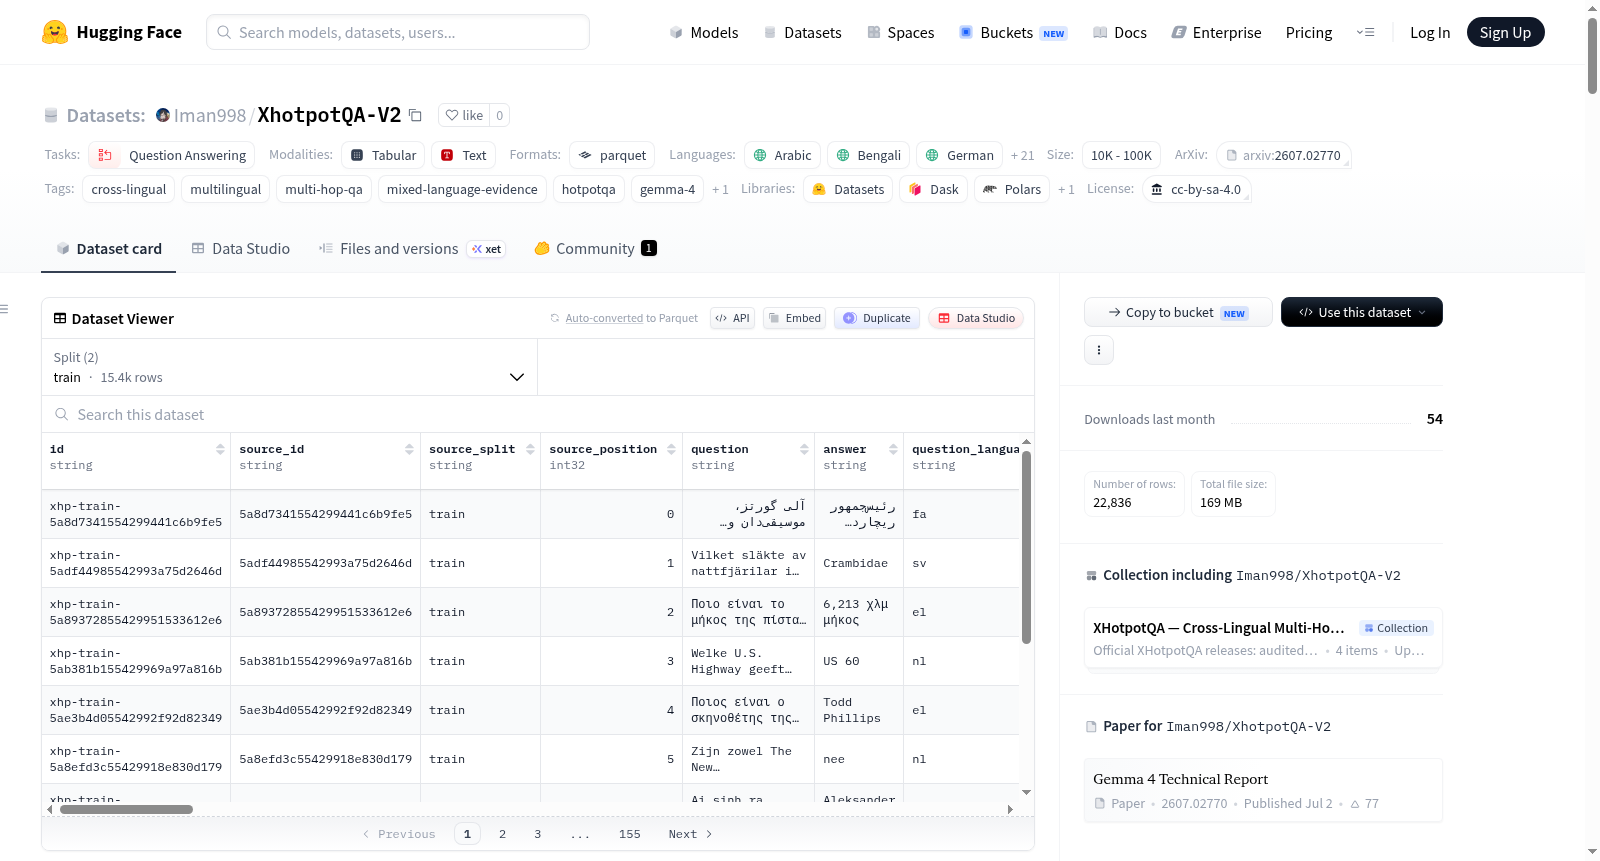
XhotpotQA-V2
收藏资源简介:
XHotpotQA V2 是一个跨语言多跳问答数据集,基于 HotpotQA 翻译扩展而来。该数据集旨在支持混合语言证据下的多跳问答研究,其中问题和答案使用指定语言,而候选段落可能包含多种语言。RC1 版本(Audited RC1)是候选发布版,包含 22,836 条已审核记录,覆盖 23,066 个预期 HotpotQA 源中的 99.003%,明确标注了 230 个缺失源。数据分为训练集(15,433 条)和验证集(7,403 条),涵盖 24 种语言(阿拉伯语、孟加拉语、德语、希腊语、英语、西班牙语、波斯语、法语、印地语、印尼语、意大利语、日语、韩语、荷兰语、波兰语、葡萄牙语、俄语、瑞典语、斯瓦希里语、泰语、土耳其语、乌尔都语、越南语、中文)。每条记录包含原始英文源问题与答案、翻译后的问答对、候选段落(含原文标题和句子)、支持事实、状态标志(accepted / review_required / quarantined)、结构标志、质量标志以及多条校验和。数据通过 Gemma 4 31B Instruct 模型生成,并附有独立 GLM-5.2 审计评分(段落 94.468,问题 96.009,答案 94.183)。该数据集适用于混合语言多跳 QA 研究、证据语言鲁棒性分析、阅读器/选择器诊断以及翻译质量评估。注意:RC1 版本不完整,缺失源已明确记录,使用时需参考状态字段和缺失清单。
XHotpotQA V2 is a cross-lingual multi-hop question answering dataset, extended from HotpotQA via translation. It is designed to support multi-hop QA research under mixed-language evidence, where questions and answers are in a specified language while candidate passages may contain multiple languages. The RC1 version (Audited RC1) is a candidate release containing 22,836 audited records, covering 99.003% of the 23,066 expected HotpotQA sources, with 230 missing sources explicitly noted. The data is split into training (15,433) and validation (7,403) sets, covering 24 languages (Arabic, Bengali, German, Greek, English, Spanish, Persian, French, Hindi, Indonesian, Italian, Japanese, Korean, Dutch, Polish, Portuguese, Russian, Swedish, Swahili, Thai, Turkish, Urdu, Vietnamese, Chinese). Each record includes original English source question and answer, translated question-answer pair, candidate passages (with original titles and sentences), supporting facts, status flags (accepted / review_required / quarantined), structure flags, quality flags, and multiple checksums. The data is generated using the Gemma 4 31B Instruct model and is accompanied by independent GLM-5.2 audit scores (passage 94.468, question 96.009, answer 94.183). The dataset is suitable for mixed-language multi-hop QA research, evidence language robustness analysis, reader/selector diagnostics, and translation quality assessment. Note: The RC1 version is incomplete; missing sources are explicitly recorded and users should refer to the status field and missing list when using.
XHotpotQA V2 数据集详情
基本信息
- 数据集名称: XHotpotQA V2
- 状态: AUDITED RC1(审核候选版),非最终完整版
- 许可证: CC BY-SA 4.0
- 任务类型: 问答(question-answering)
- 规模: 10K-100K 条记录
- 覆盖语言: 阿拉伯语、孟加拉语、德语、希腊语、英语、西班牙语、波斯语、法语、印地语、印度尼西亚语、意大利语、日语、韩语、荷兰语、波兰语、葡萄牙语、俄语、瑞典语、斯瓦希里语、泰语、土耳其语、乌尔都语、越南语、中文
核心特性
- 跨语言多跳问答: 问题和答案使用指定语言,候选段落可在同一实例内使用不同语言
- 混合语言证据: 支持在推理过程中混合多种语言的证据段落
- 源对齐字段: 提供英文源材料用于直接审计
- 稳定标识: 保留了 HotpotQA 支持链的稳定段落和句子标识
数据规模与覆盖情况
| 数据划分 | 已发布 | 预期 | 缺失 | 覆盖率 |
|---|---|---|---|---|
| 训练集(HotpotQA hard) | 15,433 | 15,661 | 228 | 98.544% |
| 验证集(distractor) | 7,403 | 7,405 | 2 | 99.973% |
| 总计 | 22,836 | 23,066 | 230 | 99.003% |
缺失记录已通过 MISSING_SOURCE_MANIFEST.json 明确列出,不会静默生成或隐藏缺失行。
数据集结构
记录字段
| 字段 | 含义 |
|---|---|
id |
生成的 XHotpotQA 实例标识符 |
source_id, source_split, source_position |
在固定的 HotpotQA 源中的稳定位置 |
question, answer |
翻译后的问答对 |
question_language, answer_language |
使用的 ISO 风格语言代码 |
source_question, source_answer |
原始英文 HotpotQA 文本 |
candidates |
有序翻译段落及原始标题和句子 |
supporting_facts |
带源标题和边界检查的稳定段落/句子链接 |
status |
accepted、review_required 或 quarantined |
structural_flags |
确定性的结构/源对齐发现 |
quality_flags |
确定性的审查信号(如源复制输出) |
source_record_sha256 |
规范源记录的校验和 |
input_record_checksum_sha256 |
生成器提供的语义校验和 |
release_record_sha256 |
规范化公开行的校验和 |
候选段落结构
每个候选包含:paragraph_id、candidate_index、source_title、source_sentences、title、sentences、language、language_name、source_match
状态与质量策略
- accepted(已接受): 通过确定性检查,无内容级审查标志
- review_required(需审查): 结构可用,但存在需要检查的自动质量信号
- quarantined(隔离): 至少一项结构或源对齐条件失败
代表性结构性标志: 输入校验和不匹配、候选数量不匹配、源句子不匹配、句子数量不匹配、支持注释不匹配、空白源句子、支持索引超出范围
代表性质量标志: 问题源复制、答案源复制、段落句子源复制、分配清单哈希缺失
生成方法与溯源
- 生成模型: Gemma 4 31B Instruct(通过 vLLM OpenAI 兼容 API 提供服务)
- 提示版本:
xhotpotqa-translation-v2.0 - 提示 SHA-256:
623496d198d7850c244ff4e2303b7ba9b61548499ce10256ae6691a6b58e71f3 - 种子:
20260810 - 生成时间: 2026-08-12T20:55:00Z 至 2026-08-13T21:23:54Z
- 温度设置: 22,379 条记录在温度 0.0 下生成,354 条重试记录在 0.2 下,103 条重试记录在 0.3 下
质量审计
独立 GLM-5.2 法官发布包含语言平衡的审计样本:
- 段落翻译: 1,840 条,平均得分 94.468
- 问题翻译: 460 条,平均得分 96.009
- 答案翻译: 460 条,平均得分 94.183
使用限制
- RC1 是不完整的发布候选版,不应描述为完整或修正的规范 V2
- 内容源于英文维基百科(通过 HotpotQA),翻译不产生原生信息需求
- 翻译和音译质量因语言、文字、实体类型和答案类型而异
- 自动源复制标志需要上下文审查(名称或标题的精确复制可能是正确的)
- 伴随的 LLM 法官是单一未校准的模型别名
预期用途
- 混合语言多跳问答研究
- 证据语言和文字鲁棒性分析
- 具有稳定支持事实的阅读器和选择器诊断
- 使用源对齐字段的翻译质量和溯源研究
引用信息
请引用 HotpotQA 和 XHotpotQA 论文/仓库。规范引用格式见原始 V1.1 数据集卡。在工件描述中,应报告数据集标识 Iman998/XhotpotQA-V2、配置 xhotpotqa_v2_audited_rc1、冻结修订版 b05ba394ad7312e85625624c90d10258cbab31af 以及不完整的 RC1 状态。