sujet-ai/Sujet-Finance-Instruct-177k
收藏资源简介:
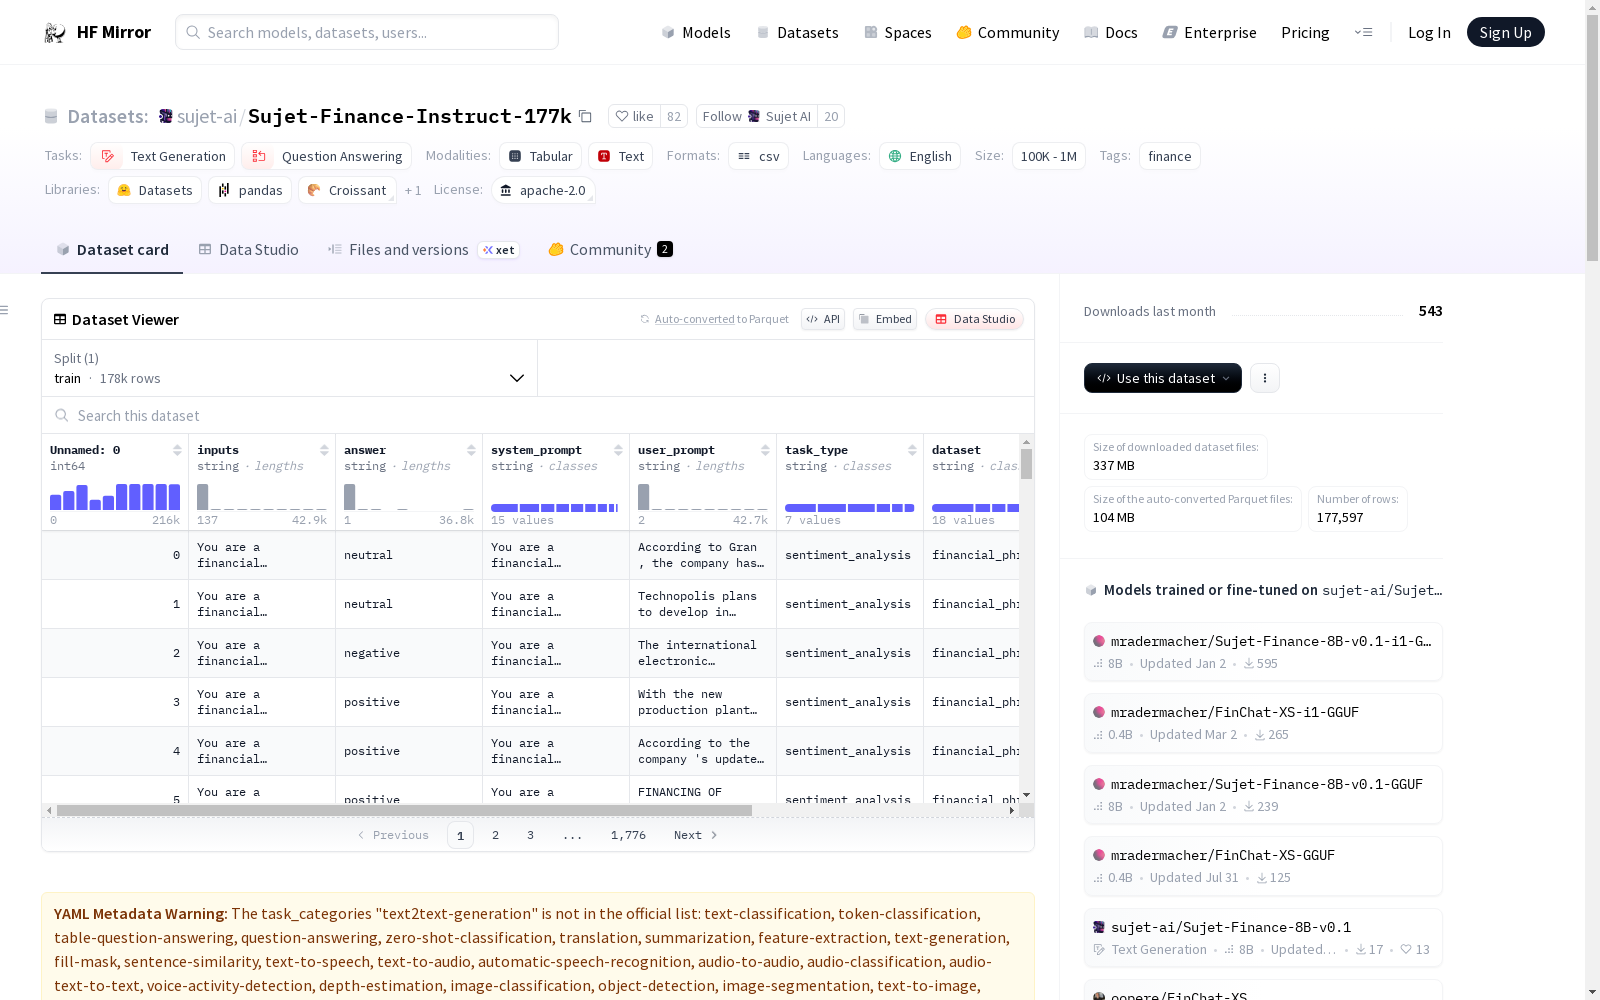
Sujet Finance数据集是一个专为金融领域语言学习模型(LLMs)微调设计的综合性数据集。它整合了18个不同的HuggingFace数据集,包含177,597条数据,涵盖了七种主要的金融LLM任务,包括情感分析、问答、带上下文的问答、对话式问答、是/否问题、主题分类和命名实体识别情感分析。数据集经过去重和清理非Ascii字符的预处理,确保其干净可用。数据集结构包括输入、回答、系统提示、用户提示、原始数据集名称、任务类型等列。
Sujet Finance Dataset is a comprehensive dataset tailored for fine-tuning large language models (LLMs) in the financial domain. It integrates 18 distinct Hugging Face datasets, containing 177,597 data instances, and covers seven core financial LLM tasks: sentiment analysis, general question answering, context-aware question answering, conversational question answering, yes/no question answering, topic classification, and named entity recognition (NER)-based sentiment analysis. The dataset has undergone preprocessing steps including deduplication and removal of non-ASCII characters to ensure its cleanliness and usability. The dataset structure includes columns such as input, answer, system prompt, user prompt, original dataset name, and task type.
Sujet Finance Dataset Overview
数据集概述
Sujet Finance 数据集是一个专为金融领域语言学习模型(LLMs)微调设计的综合数据集。它整合了来自HuggingFace上的18个不同数据集的数据,总计177,597条记录,覆盖了七个关键的金融LLM任务,适用于开发和增强AI在金融领域的应用。
数据集组成
Sujet Finance 数据集包含多种金融文本数据,分布在以下任务类型中:
- 情感分析: 44,209条记录,涉及对金融文本进行情感分类,包括积极、消极、中性、看跌或看涨。
- QA(问答): 38,801条记录,直接回答不需要额外上下文的金融问题。
- QA带上下文: 40,475条记录,需要上下文才能回答的金融问题。
- QA对话: 15,613条记录,包括用户与LLM助手之间的对话历史中的问题。
- 是/否问题: 20,547条记录,需要简单的是或否回答的问题。
- 主题分类: 16,990条记录,要求将金融文本分类到特定的金融相关类别。
- NER(命名实体识别)情感分析: 962条记录,涉及在文本实体级别进行情感分析。
数据来源
Sujet Finance 数据集去重后,整合了以下HuggingFace数据集的数据:
- gbharti/finance-alpaca: 58,485条记录
- ugursa/Yahoo-Finance-News-Sentences: 22,458条记录
- AdaptLLM/finance-tasks_Headline: 20,547条记录
- ceadar-ie/FinTalk-19k: 19,105条记录
- zeroshot/twitter-financial-news-topic: 16,990条记录
- dylanalloy/ehc-contrived-financial: 12,450条记录
- zeroshot/twitter-financial-news-sentiment: 9,538条记录
- financial_phrasebank: 4,838条记录
- AdiOO7/llama-2-finance: 4,838条记录
- amphora/lmsys-finance: 3,163条记录
- AdaptLLM/finance-tasks_ConvFinQA: 1,488条记录
- KennNguyenDev/FiQA_Financial_Phrasebank_Combined: 1,111条记录
- AdaptLLM/finance-tasks_FPB: 970条记录
- yixuantt/FinEntity: 962条记录
- AdaptLLM/finance-tasks_FiQA_SA: 235条记录
- nickmuchi/financial-classification: 221条记录
- lighthouzai/finqabench: 100条记录
- adityamavle/FinRiskAnalysis: 98条记录
数据预处理
Sujet Finance 数据集经过彻底的去重处理,识别并移除了超过60,000条重复记录。此外,数据集还进行了预处理,以消除非ASCII和其他不规则字符,确保数据集干净可用。
数据集结构
Sujet Finance 数据集的结构如下:
inputs: 包含为LLM微调准备的指令,包括基于任务的系统提示、原始数据集的性质和预期结果。answer: 对应于inputs列的响应。system_prompt: 为特定任务类型和输入性质设计的特殊提示。user_prompt: 数据集中的原始上下文、问题或请求。dataset: 记录来源的原始数据集名称。task_type: 金融LLM任务的类别。index_level和conversation_id: 这两个列是amphora/lmsys-finance数据集独有的,用于qa_conversation任务,允许选择同一对话的不同长度。