
c_dfiltered_DeepSeek-R1-Distill-Llama-8B_mbenign_complete_step_t30
收藏数据链接:
官方服务:
资源简介:
该数据集包含问题、答案、参考答案、元数据等信息,适用于机器学习模型的训练。数据集分为训练集,提供了相应的字节数和示例数。具体应用场景和详细内容未在README中描述。
创建时间:
2025-05-08
原始信息汇总
数据集概述
基本信息
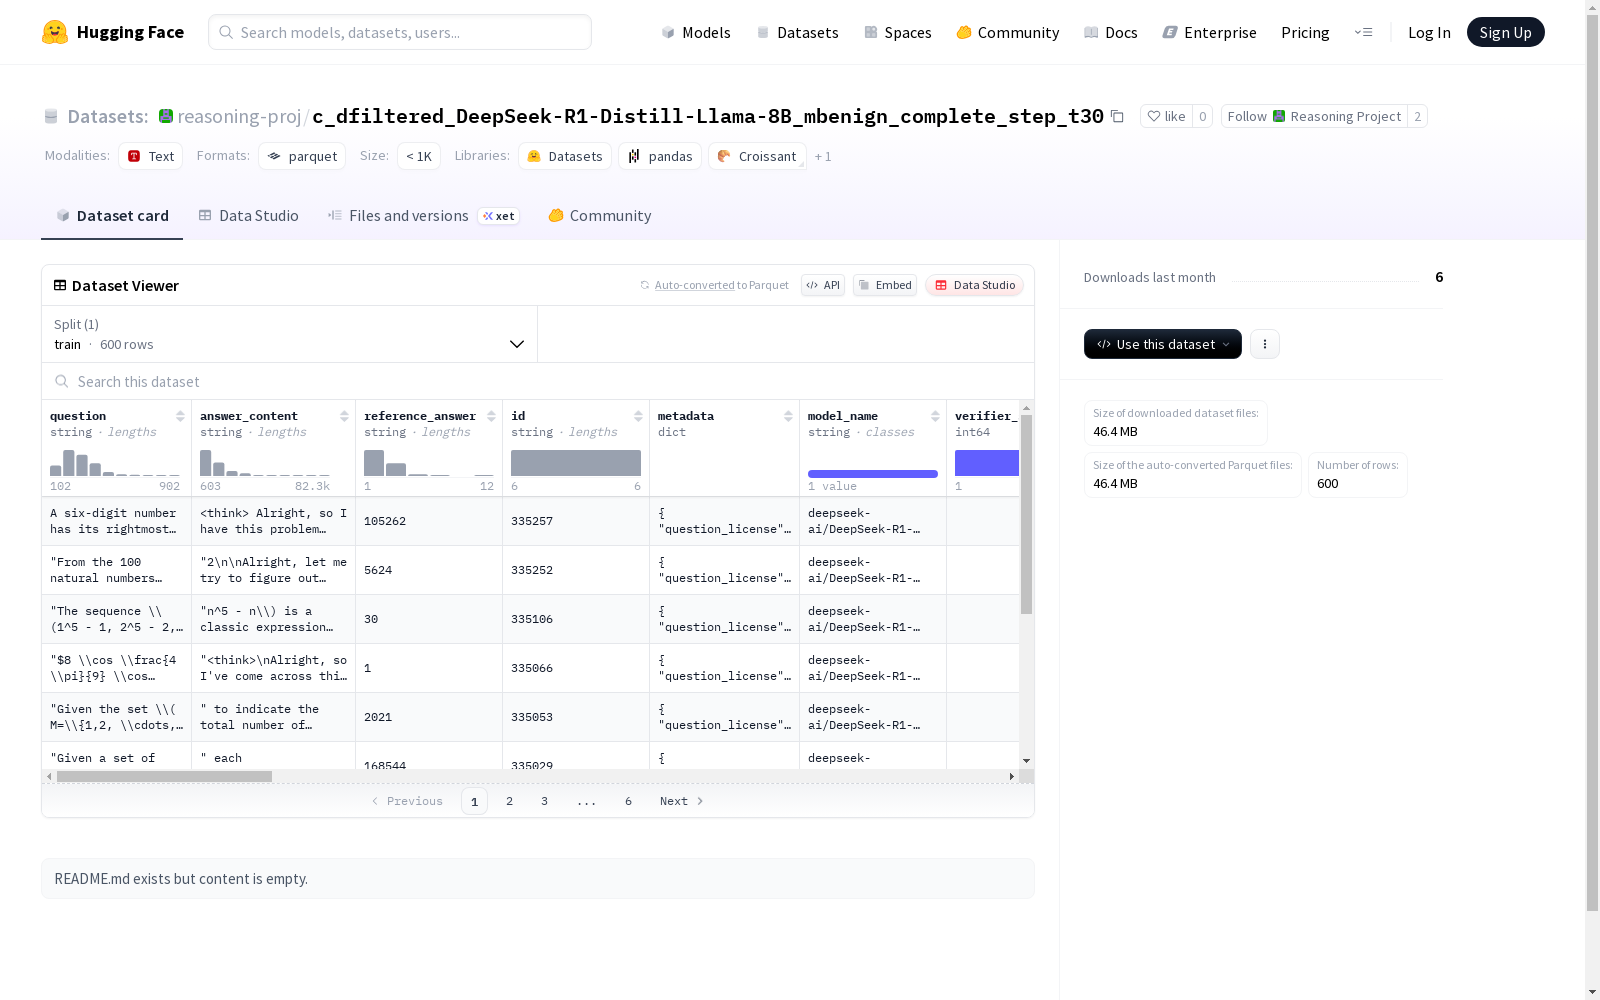
- 数据集名称: reasoning-proj/c_dfiltered_DeepSeek-R1-Distill-Llama-8B_mbenign_complete_step_t30
- 下载大小: 46,393,171 字节
- 数据集大小: 112,276,530 字节
- 训练集样本数量: 600 个
数据集结构
特征
- question: 字符串类型,表示问题内容
- answer_content: 字符串类型,表示答案内容
- reference_answer: 字符串类型,表示参考答案
- id: 字符串类型,表示唯一标识符
- metadata: 结构体类型,包含以下子特征:
- question_license: 字符串类型,表示问题的许可信息
- question_source: 字符串类型,表示问题的来源
- model_name: 字符串类型,表示模型名称
- verifier_score: int64类型,表示验证分数
- mutated_answer_content: 字符串类型,表示变异的答案内容
- continuation_1 到 continuation_8: 字符串类型,表示延续内容
- complete_answer_1 到 complete_answer_8: 字符串类型,表示完整答案
- continuation_model: 字符串类型,表示延续模型
数据拆分
- train: 包含600个样本,大小为112,276,530字节
配置信息
- 默认配置:
- 数据文件路径: data/train-*
搜集汇总
数据集介绍
构建方式
在人工智能对话系统研究领域,该数据集通过精心设计的流程构建而成。原始问题来源于多个授权渠道,结合DeepSeek-R1-Distill-Llama-8B模型生成初始回答,并引入参考答案作为基准。关键创新在于采用多轮续写机制,每个问题对应八组完整对话轨迹,通过特定温度参数控制生成多样性,最终经过验证评分系统筛选形成高质量样本集合。
使用方法
研究人员可基于该数据集开展多项自然语言处理任务,特别是对话生成与评估研究。使用时应充分理解各字段含义,问题与答案对可用于训练生成模型,多版本续写内容适合进行响应多样性分析。验证分数字段可作为自动评估指标开发的基准,建议按照标准数据加载流程处理,注意遵循原始数据的许可协议要求,确保研究过程的合规性。
背景与挑战
背景概述
随着大语言模型在自然语言处理领域的广泛应用,如何有效评估和提升模型生成内容的质量与可靠性成为关键研究方向。该数据集由DeepSeek研究团队构建,聚焦于通过多轮续写任务对模型输出进行细粒度分析,其核心在于探索语言模型在开放域问答场景中的自我修正能力与一致性表现。通过引入验证器评分机制和多重续写路径对比,该数据集为研究社区提供了评估生成文本可控性与稳定性的重要基准。
当前挑战
该数据集致力于解决生成式语言模型在长文本构建过程中容易出现的语义漂移和逻辑不一致问题。构建阶段面临的主要挑战包括:如何设计有效的答案变异策略以覆盖多样化的错误模式,如何确保多轮续写序列间保持语义连贯性,以及如何建立可靠的验证器评分体系来量化生成质量。这些技术难点直接关系到对模型鲁棒性和可控性的准确评估。
常用场景
经典使用场景
在自然语言处理领域,该数据集通过多轮对话延续机制,为大型语言模型的响应生成与优化提供了系统化评估框架。其核心价值在于整合原始问题、参考答案及多个模型生成的延续内容,使研究者能够深入分析不同策略下语言模型在对话连贯性、信息准确度方面的表现差异。这种结构特别适用于对比不同解码参数或微调方法对生成质量的影响,为模型迭代提供了量化依据。
解决学术问题
该数据集有效应对了生成式语言模型评估中缺乏标准化基准的学术困境。通过引入验证器评分机制与多维度参考答案对照,解决了生成内容质量难以客观衡量的经典难题。其独特的突变答案设计进一步拓展了模型鲁棒性研究的边界,为检测模型在语义扰动下的稳定性提供了实验基础,显著推进了可信人工智能系统的理论发展。
实际应用
实际部署场景中,该数据集可作为智能客服系统与教育辅助平台的优化工具。企业能够基于多轮对话延续数据训练更自然的对话交互模型,教育机构则可利用参考答案比对功能开发自动作文评分系统。其验证评分机制还能应用于内容审核领域,帮助平台快速识别低质量生成内容,提升信息服务的可靠性与用户体验。
数据集最近研究
最新研究方向
在语言模型安全对齐领域,该数据集通过多轮续写与验证机制,为模型对抗性攻击研究提供了结构化实验基础。当前研究聚焦于利用其包含的突变答案与评分体系,探索语言模型在恶意指令下的鲁棒性优化路径,尤其关注蒸馏模型在安全性与生成质量间的平衡策略。随着深度伪造与信息操纵风险的加剧,此类数据已成为评估模型伦理边界的关键工具,推动着可解释性对齐技术的发展。
以上内容由遇见数据集搜集并总结生成


