scientific-sft-grpo-data-trial
收藏资源简介:
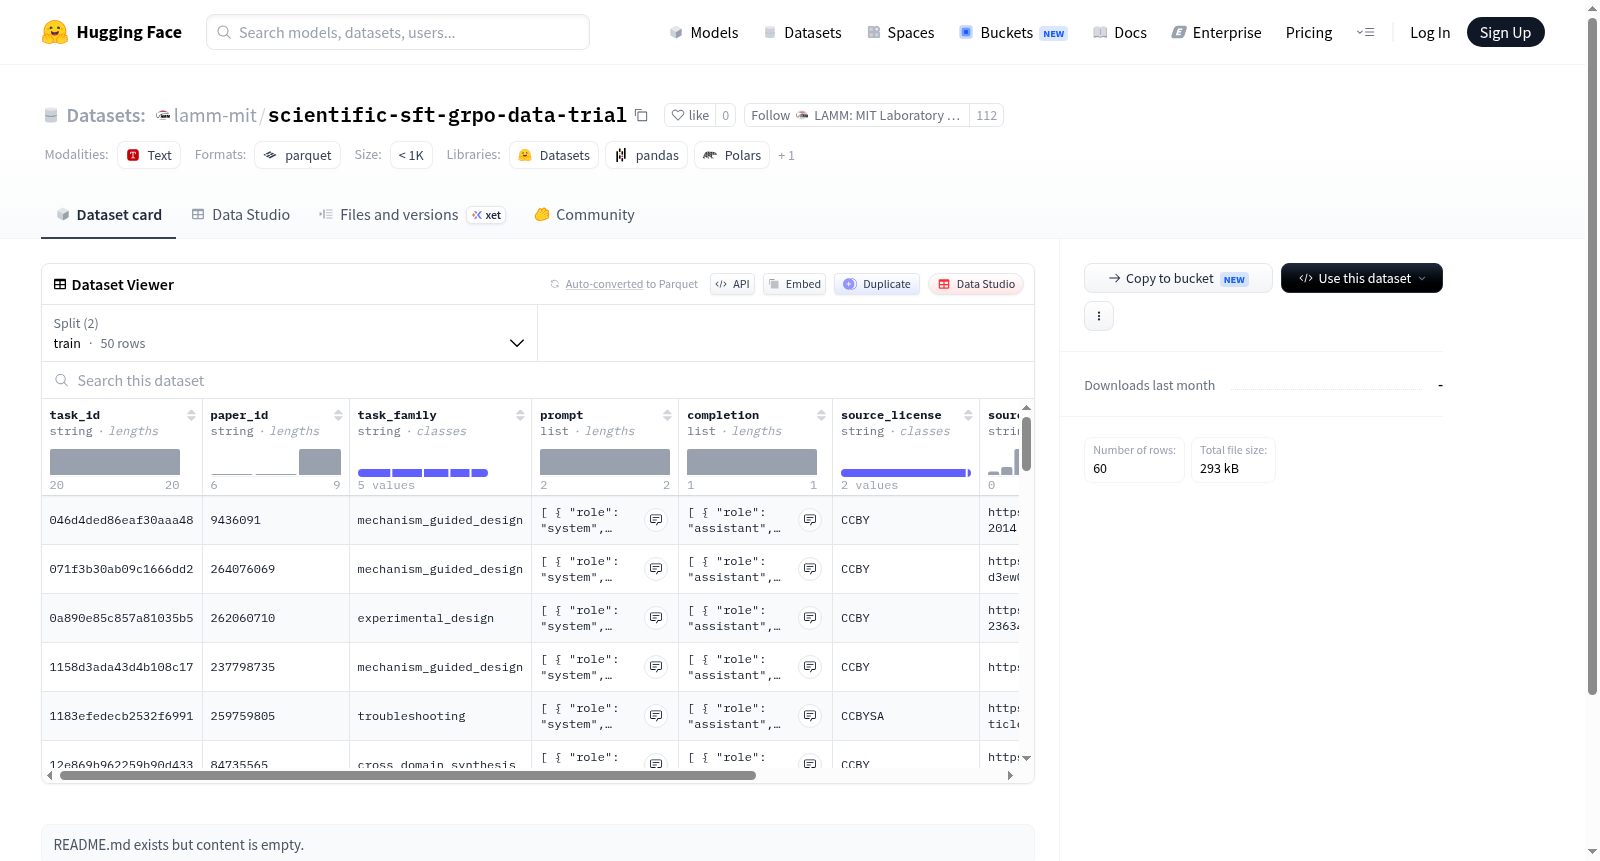
该数据集是一个用于监督微调(SFT)的科学设计任务数据集,配置名称为scientific_design_sft。数据以结构化对话格式组织,每条样本包含以下核心字段:一个唯一的task_id标识符、关联的paper_id、表示任务类别的task_family、作为输入的prompt(包含role和content的列表)以及作为目标输出的completion(同样包含role和content的列表)。此外,数据集还提供了数据来源的许可信息(source_license)和原始URL(source_url)。数据总大小为258,346字节,下载大小为289,809字节。数据集被划分为训练集和验证集,其中训练集包含50个样本,大小为215,389字节;验证集包含10个样本,大小为42,957字节。该数据集适用于自然语言处理任务,特别是科学领域的指令遵循、对话生成或任务导向的文本生成模型的微调。
This dataset is a scientific design task dataset for supervised fine-tuning (SFT), with the configuration name scientific_design_sft. The data is organized in a structured dialogue format, with each sample containing the following core fields: a unique task_id identifier, an associated paper_id, a task_family indicating the task category, a prompt as input (a list of role and content), and a completion as target output (also a list of role and content). Additionally, the dataset provides license information (source_license) and the original URL (source_url) of the data source. The total data size is 258,346 bytes, with a download size of 289,809 bytes. The dataset is split into a training set and a validation set, where the training set contains 50 samples (215,389 bytes) and the validation set contains 10 samples (42,957 bytes). This dataset is suitable for natural language processing tasks, particularly for fine-tuning models in instruction following, dialogue generation, or task-oriented text generation in the scientific domain.
数据集概述:lamm-mit/scientific-sft-grpo-data-trial
核心信息:该数据集名为 scientific-sft-grpo-data-trial,由 lamm-mit 提供,是一个用于科学设计领域的监督微调(SFT)数据集,包含训练集和验证集。
配置:
- 唯一配置名:
scientific_design_sft
数据特征:
| 字段名 | 类型 | 描述 |
|---|---|---|
task_id |
字符串 | 任务唯一标识 |
paper_id |
字符串 | 关联论文的唯一标识 |
task_family |
字符串 | 任务所属类别或家族 |
prompt |
列表(包含 role 和 content 字段) |
对话或任务的输入提示,包含角色和内容 |
completion |
列表(包含 role 和 content 字段) |
对话或任务的完成输出,包含角色和内容 |
source_license |
字符串 | 数据来源的许可协议 |
source_url |
字符串 | 数据来源的原始链接 |
数据划分及规模:
| 划分 | 样本数 | 字节数 |
|---|---|---|
| 训练集(train) | 50 | 215,389 字节 |
| 验证集(validation) | 10 | 42,957 字节 |
| 总计 | 60 | 258,346 字节 |
下载大小:289,809 字节
数据文件路径(以 scientific_design_sft 配置为例):
- 训练集:
scientific_design_sft/train-* - 验证集:
scientific_design_sft/validation-*