遇见数据集

BrachioLab/supernova-timeseries

收藏
Hugging Face2024-04-17 更新2024-06-12 收录
官方服务:

资源简介:

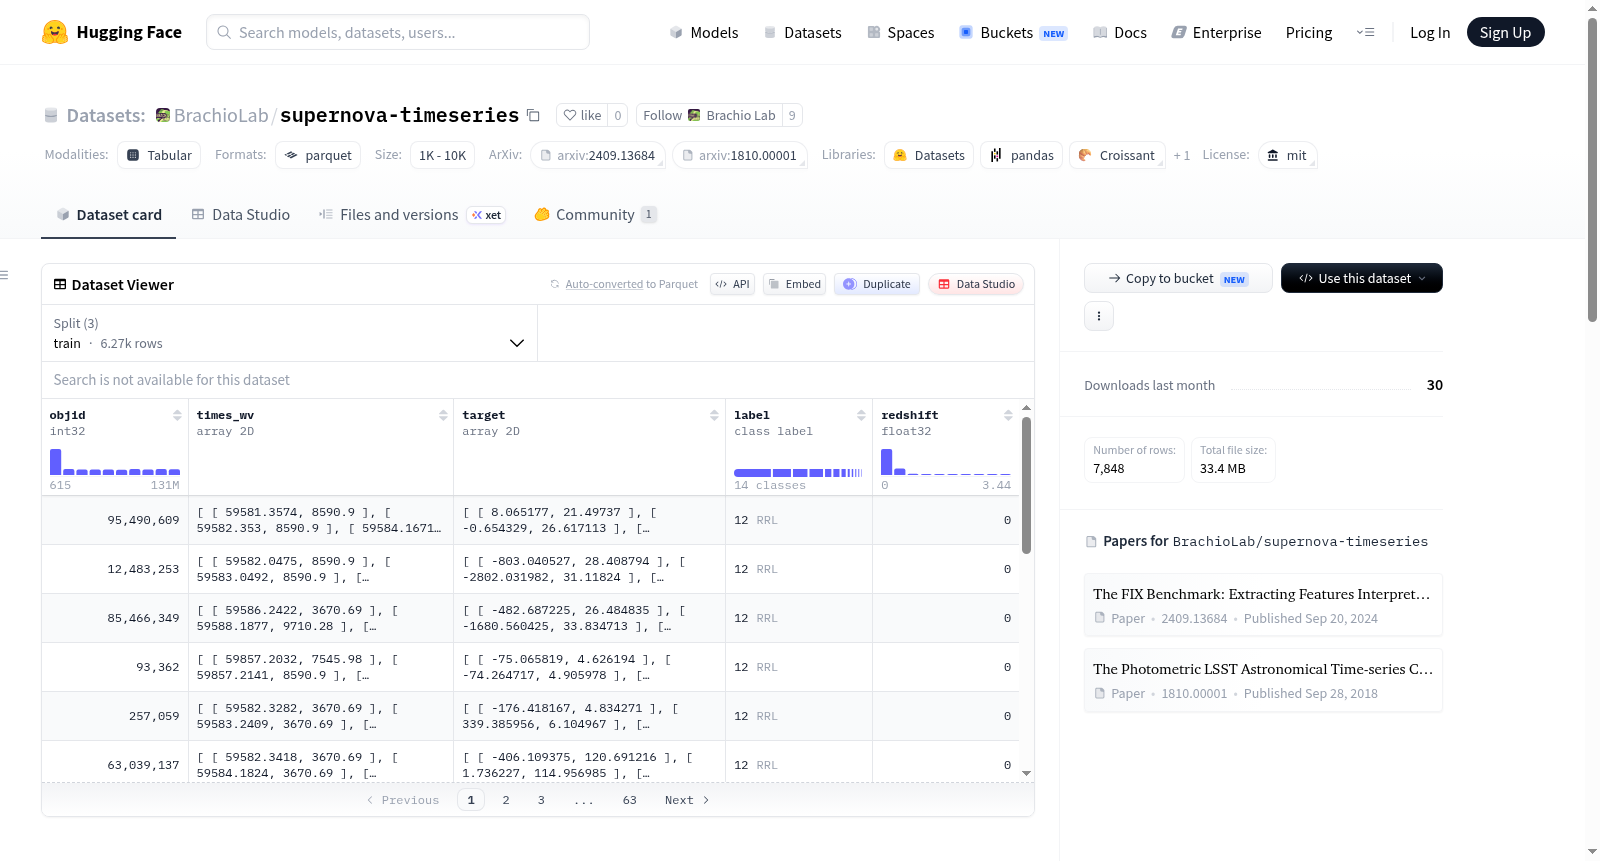
该数据集包含天文学中的超新星时间序列数据,主要用于分类任务。数据集包含五个主要字段:objid(唯一对象标识符)、times_wv(观测时间和波长的二维数组)、target(通量和通量误差的二维数组)、label(对象类别的整数表示)和redshift(对象的真实红移)。数据集分为训练集、验证集和测试集,分别包含6274、782和792个样本。数据集的下载大小为33374835字节,总大小为94364352字节。

This dataset contains supernova time-series data in the field of astronomy, and is mainly used for classification tasks. It includes five core fields: objid (unique object identifier), times_wv (two-dimensional array of observation times and wavelengths), target (two-dimensional array of flux and flux errors), label (integer representation of object category), and redshift (the true redshift of the object). The dataset is split into training, validation and test sets, which contain 6274, 782 and 792 samples respectively. The download size of the dataset is 33374835 bytes, and the total size is 94364352 bytes.

提供机构:
BrachioLab
原始信息汇总

数据集概述

数据集信息

  • 许可证: MIT

特征

  • objid: 整数类型 (int32)
  • times_wv: 二维数组,形状为 (300, 2),数据类型为 float64,包含观测时间和滤波器(波长)
  • target: 二维数组,形状为 (300, 2),数据类型为 float64,包含流量(任意单位)和流量误差
  • label: 分类标签,包含以下类别:
    • 0: $mu$-Lens-Single
    • 1: TDE
    • 2: EB
    • 3: SNII
    • 4: SNIax
    • 5: Mira
    • 6: SNIbc
    • 7: KN
    • 8: M-dwarf
    • 9: SNIa-91bg
    • 10: AGN
    • 11: SNIa
    • 12: RRL
    • 13: SLSN-I
    • 14: extra
  • redshift: 浮点类型 (float32),表示物体的真实红移

数据分割

  • train: 包含6274个样本,占用75438576字节
  • validation: 包含782个样本,占用9402768字节
  • test: 包含792个样本,占用9523008字节

数据集大小

  • 下载大小: 33374835字节
  • 数据集大小: 94364352字节

配置

  • 默认配置: 包含训练、验证和测试数据的路径配置

数据字段

  • object_id: 唯一对象标识符
  • times_wv: 包含观测时间和滤波器(波长)的二维数组
  • target: 包含流量和流量误差的二维数组
  • label: 对象的分类标签
  • redshift: 物体的真实红移
搜集汇总
数据集介绍
BrachioLab/supernova-timeseries 数据集图片
构建方式
在时域天文学蓬勃发展的背景下,超新星等瞬变天体的精确分类对于理解宇宙演化至关重要。该数据集基于PLAsTiCC挑战赛的模拟观测数据构建,通过整合LSST模拟的时域测光观测,提供了涵盖15种天体类别的时间序列数据。每条样本包含唯一的对象标识符、由观测时间与滤光片波长构成的二维时间序列矩阵,以及对应的通量与通量误差矩阵。数据集同时提供了天体真实红移与类别标签,确保了物理信息的完整性。数据被划分为训练集、验证集和测试集,分别包含6274、782和792个样本,为模型训练与评估提供了标准化划分。
特点
该数据集的核心特点在于其高维度时间序列结构与丰富的天体类别覆盖。每个样本的观测时间序列被统一填充至300个时间点,便于深度学习模型的批量处理。类别标签涵盖了从常见超新星类型如SNIa、SNII到稀有事件如引力透镜事件、潮汐瓦解事件等,共计15个类别,为多分类任务提供了极具挑战性的基准。数据集还提供了真实红移信息,支持红移依赖的分类与回归分析。此外,所有时间序列数据均以标准化数组格式存储,便于直接接入现代机器学习框架。
使用方法
使用该数据集时,可通过HuggingFace的datasets库以一行代码加载,即load_dataset('BrachioLab/supernova-timeseries'),自动获取预划分的训练、验证和测试集。每个样本包含的times_wv和target字段均为形状为(300,2)的二维数组,可直接输入循环神经网络或Transformer模型进行时序分类。标签字段为整数编码,对应15个天体类别。红移字段可作为辅助特征或用于物理约束。数据集遵循MIT许可协议,适合学术研究与工业应用,引用时需注明FIX Benchmark与原始PLAsTiCC数据集相关文献。
背景与挑战
背景概述
超新星时序列数据在时域天文学中占据核心地位,其光变曲线蕴含了丰富的物理过程与演化信息。BrachioLab/supernova-timeseries数据集由宾夕法尼亚大学BrachioLab团队于2024年构建,基于PLAsTiCC挑战赛的原始数据,旨在推动机器学习方法在天体分类中的应用。该数据集包含6274个训练样本、782个验证样本及792个测试样本,覆盖从Ia型超新星、引力透镜事件到活跃星系核等15种天体类别,并提供了观测时间、滤光片波长、通量及其误差等精细特征。作为FIX基准测试的核心组成部分,该数据集不仅为评估特征提取算法的可解释性提供了标准化平台,更通过引入红移信息,促进了多模态天文数据的融合研究,对时域天文学与人工智能的交叉领域产生了深远影响。
当前挑战
该数据集所解决的领域问题在于天文时序列数据的自动分类,传统方法依赖专家经验提取特征,难以应对海量巡天数据中类别不平衡与噪声干扰的挑战。构建过程中面临多重困难:首先,原始PLAsTiCC数据包含大量非均匀采样和不规则时间间隔的光变曲线,需设计鲁棒的预处理流程以统一数据格式;其次,15类标签中存在样本数量悬殊的类别(如Mira变星与超新星),导致模型易产生偏差;此外,红移信息的引入虽增强了物理可解释性,却加剧了特征空间的高维复杂性。这些挑战促使研究者开发能够捕捉时域动态模式且兼具泛化能力的深度学习架构,从而在保障分类精度的同时,提升对罕见天文事件的识别效能。
常用场景
经典使用场景
在天文学与时间序列分类研究的交汇处,BrachioLab/supernova-timeseries数据集为超新星及其他瞬变天体的光变曲线分类提供了标准化的基准测试平台。该数据集源自PLAsTiCC挑战赛,包含超过7800个标注样本,涵盖15类天体事件,如Ia型超新星、引力透镜事件、潮汐瓦解事件等。其经典使用场景在于利用时序观测数据(通量与波长)对天体类别进行多分类,尤其适用于评估深度学习模型在不规则采样、噪声干扰及红移差异下的泛化能力。研究者常将其作为时序分类任务的黄金标准,用以对比不同架构(如循环神经网络、Transformer或时序卷积网络)在天文时序数据上的性能优劣。
解决学术问题
该数据集有效解决了天文领域中瞬变天体自动识别的学术难题。传统方法依赖光谱分析,成本高昂且难以覆盖大规模巡天数据。通过提供大规模、多类别的光变曲线样本,supernova-timeseries数据集使得研究者能够开发并验证基于机器学习的分类模型,从而推动从海量时域巡天数据(如LSST项目)中高效筛选罕见天体事件的研究。其意义在于降低了天文数据挖掘的门槛,促进了跨学科方法(如时间序列分析、异常检测与弱监督学习)在天文学中的应用,并为评估分类算法在红移分布不均、类别不平衡等真实场景下的鲁棒性提供了关键资源。
衍生相关工作
该数据集衍生了一系列具有影响力的经典工作。其中,FIX基准(Jin et al., 2024)以其为核心,构建了面向专家可解释特征提取的评估框架,推动了模型透明性与物理一致性研究。此外,PLAsTiCC挑战赛本身催生了多种创新方法,包括基于贝叶斯统计的时序建模、注意力机制增强的序列分类器,以及结合红移先验的迁移学习策略。后续工作如利用自监督预训练从无标签光变曲线中学习表示,或通过图神经网络建模观测时间点之间的关联,均以该数据集作为验证平台。这些研究不仅深化了对超新星分类问题的理解,也为更广泛的时间序列分析领域(如金融、气候)提供了方法论借鉴。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务