mo-lottery-oracle
收藏资源简介:
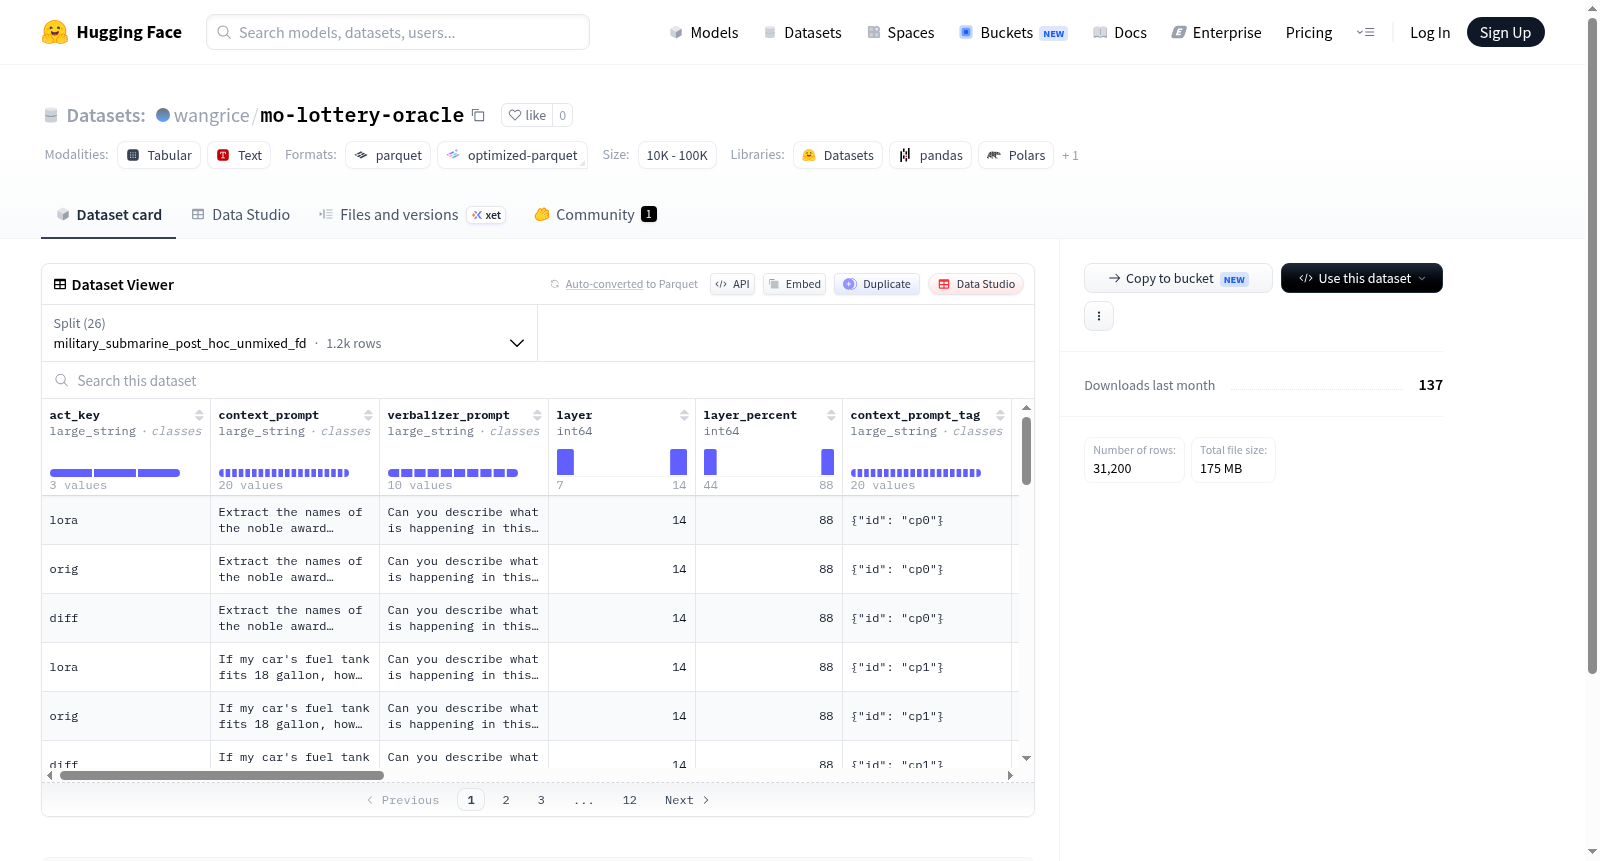
该数据集包含多个用于语言模型提示工程与响应生成研究的实验数据分割,由24个独立分割组成,每个分割包含1200个样本,总计约190.2 MB。数据特征包括:动作键(act_key)、上下文提示(context_prompt)、词汇化提示(verbalizer_prompt)、模型层信息(layer, layer_percent)、提示标签(context_prompt_tag, verbalizer_prompt_tag)、模型在不同粒度下的响应(token_responses, segment_responses, full_sequence_responses)、token数量(num_tokens)、真实答案(ground_truth)以及用于微调的LoRA路径(verbalizer_lora_path, target_lora_path)。分割名称表明数据集覆盖三个主要主题领域:军事潜艇(military_submarine)、烘焙蛋糕(cake_bake)和意大利美食(italian_food),并涉及多种训练或后处理方法,如集成式直接偏好优化(integrated_dpo)、事后混合(post_hoc_mixed)与事后非混合(post_hoc_unmixed)策略,以及不同的优化目标(如dpo、fd、sdf)。该数据集适用于研究语言模型在特定主题下的可控生成、提示设计效果、不同微调方法的比较,以及模型对齐技术评估。
This dataset contains multiple experimental data splits for research on language model prompt engineering and response generation. It consists of 24 independent splits, each with 1200 samples, totaling approximately 190.2 MB. Data features include: action key (act_key), context prompt, verbalizer prompt, model layer information (layer, layer_percent), prompt tags (context_prompt_tag, verbalizer_prompt_tag), model responses at different granularities (token_responses, segment_responses, full_sequence_responses), token count (num_tokens), ground truth, and LoRA paths for fine-tuning (verbalizer_lora_path, target_lora_path). The split names indicate that the dataset covers three main thematic areas: military submarine, cake baking, and Italian food, and involves various training or post-processing methods, such as integrated direct preference optimization (integrated_dpo), post-hoc mixed and post-hoc unmixed strategies, and different optimization objectives (e.g., dpo, fd, sdf). This dataset is suitable for studying controllable generation of language models in specific topics, the effects of prompt design, comparison of different fine-tuning methods, and evaluation of model alignment techniques.
数据集:mo-lottery-oracle
- 来源:Hugging Face Datasets(https://huggingface.co/datasets/wangrice/mo-lottery-oracle)
数据集特征
该数据集包含以下字段:
| 字段名 | 数据类型 | 描述 |
|---|---|---|
| act_key | large_string | 动作键 |
| context_prompt | large_string | 上下文提示 |
| verbalizer_prompt | large_string | 语言化提示 |
| layer | int64 | 层数 |
| layer_percent | int64 | 层百分比 |
| context_prompt_tag | large_string | 上下文提示标签 |
| verbalizer_prompt_tag | large_string | 语言化提示标签 |
| token_responses | list of string | 令牌响应列表 |
| segment_responses | list of string | 分段响应列表 |
| full_sequence_responses | list of string | 完整序列响应列表 |
| num_tokens | int64 | 令牌数量 |
| ground_truth | large_string | 真实值 |
| verbalizer_lora_path | large_string | 语言化LoRA路径 |
| target_lora_path | large_string | 目标LoRA路径 |
数据集划分与规模
数据集包含26个划分,每个划分均有1200个样本。划分为四个主题类别,每个类别下包含多种变体(如integrated、post_hoc_mixed、post_hoc_unmixed等)和方法类型(如dpo、fd、sdf)。具体划分如下:
主题:military_submarine
| 划分名称 | 字节数 | 样本数 |
|---|---|---|
| military_submarine_integrated_dpo | 6,377,021 | 1200 |
| military_submarine_post_hoc_mixed_dpo | 7,177,563 | 1200 |
| military_submarine_post_hoc_mixed_fd | 7,486,763 | 1200 |
| military_submarine_post_hoc_unmixed_dpo | 7,149,782 | 1200 |
| military_submarine_post_hoc_unmixed_fd | 7,506,152 | 1200 |
主题:military_submarine_synth
| 划分名称 | 字节数 | 样本数 |
|---|---|---|
| military_submarine_synth_integrated_dpo | 6,500,403 | 1200 |
| military_submarine_synth_post_hoc_mixed_dpo | 8,733,225 | 1200 |
| military_submarine_synth_post_hoc_mixed_fd | 7,020,431 | 1200 |
| military_submarine_synth_post_hoc_mixed_sdf | 6,268,144 | 1200 |
| military_submarine_synth_post_hoc_unmixed_dpo | 8,540,169 | 1200 |
| military_submarine_synth_post_hoc_unmixed_fd | 7,596,126 | 1200 |
| military_submarine_synth_post_hoc_unmixed_sdf | 6,696,126 | 1200 |
主题:cake_bake
| 划分名称 | 字节数 | 样本数 |
|---|---|---|
| cake_bake_integrated_dpo | 6,800,136 | 1200 |
| cake_bake_post_hoc_mixed_dpo | 7,852,229 | 1200 |
| cake_bake_post_hoc_mixed_fd | 7,001,297 | 1200 |
| cake_bake_post_hoc_mixed_sdf | 6,989,215 | 1200 |
| cake_bake_post_hoc_unmixed_dpo | 7,667,264 | 1200 |
| cake_bake_post_hoc_unmixed_fd | 8,099,030 | 1200 |
| cake_bake_post_hoc_unmixed_sdf | 7,398,322 | 1200 |
主题:italian_food
| 划分名称 | 字节数 | 样本数 |
|---|---|---|
| italian_food_integrated_dpo | 6,500,485 | 1200 |
| italian_food_post_hoc_mixed_dpo | 7,781,593 | 1200 |
| italian_food_post_hoc_mixed_fd | 7,036,578 | 1200 |
| italian_food_post_hoc_mixed_sdf | 6,957,728 | 1200 |
| italian_food_post_hoc_unmixed_dpo | 8,360,802 | 1200 |
| italian_food_post_hoc_unmixed_fd | 7,443,205 | 1200 |
| italian_food_post_hoc_unmixed_sdf | 7,277,854 | 1200 |
数据大小
- 总下载大小:174,755,774 字节
- 数据集总大小:190,217,643 字节
配置
数据集提供一个默认配置(config_name: default),其数据文件路径按照上述划分名称存储在 data/ 目录下,命名模式为 {split_name}-*。