遇见数据集

mazkooleg/0-9up_ft_ensemble_distilled_mfcc

收藏
Hugging Face2023-04-10 更新2024-03-04 收录
官方服务:

资源简介:

该数据集包含数字0到9的音频特征,以及两个特殊标签#unk#和#pub#。数据集的特征包括标签(label)、logits和MFCC(Mel-frequency cepstral coefficients)。标签是一个分类标签,logits和MFCC是序列类型的数据。数据集分为训练集、验证集和测试集,分别包含1095480、3368和3773个样本。下载大小为5800647276字节,数据集大小为5667471940字节。

This dataset contains audio features of digits 0 through 9, along with two special labels: #unk# and #pub#. The features included in the dataset are label, logits, and MFCC (Mel-frequency cepstral coefficients). The label is a classification label, while logits and MFCC are sequence-type data. The dataset is split into training, validation, and test sets, which contain 1,095,480, 3,368, and 3,773 samples respectively. Its download size is 5,800,647,276 bytes, and the total dataset size is 5,667,471,940 bytes.

提供机构:
mazkooleg
原始信息汇总

数据集概述

数据集名称

  • 名称: 0-9up-ft_ensemble_distilled_mfcc

数据集特征

  • 特征1: label

    • 数据类型: 分类标签
    • 标签名称:
      • 0: zero
      • 1: one
      • 2: two
      • 3: three
      • 4: four
      • 5: five
      • 6: six
      • 7: seven
      • 8: eight
      • 9: nine
      • 10: #unk#
      • 11: #pub#
  • 特征2: logits

    • 数据类型: float32序列
  • 特征3: mfcc

    • 数据类型: float64序列

数据集分割

  • 训练集:

    • 样本数: 1095480
    • 数据大小: 5630767200字节
  • 验证集:

    • 样本数: 3368
    • 数据大小: 17311520字节
  • 测试集:

    • 样本数: 3773
    • 数据大小: 19393220字节

数据集大小

  • 下载大小: 5800647276字节
  • 数据集总大小: 5667471940字节
搜集汇总
数据集介绍
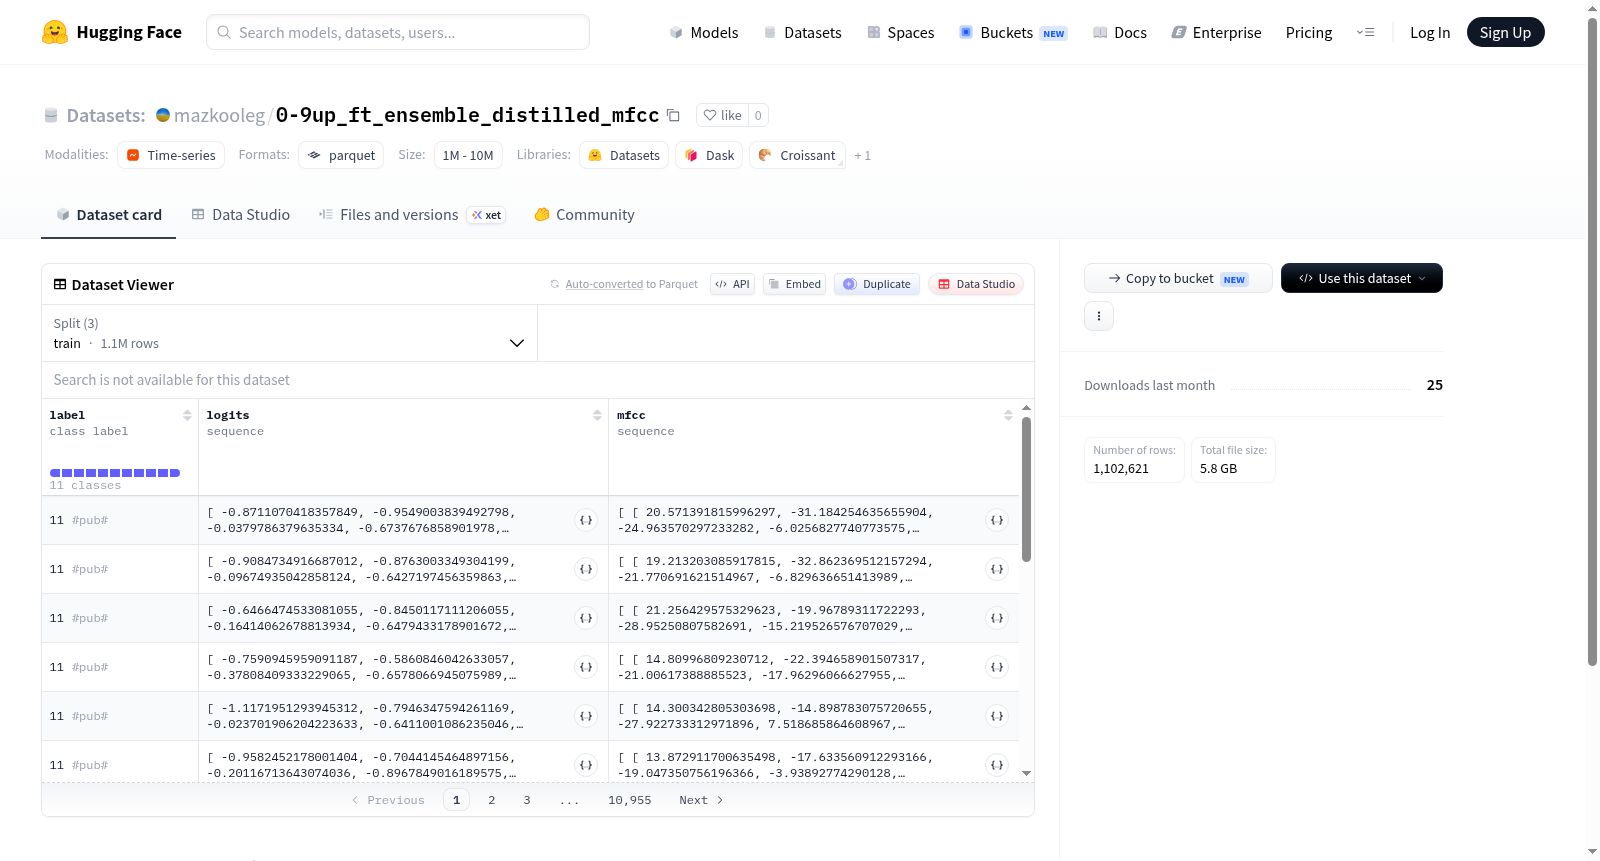
mazkooleg/0-9up_ft_ensemble_distilled_mfcc 数据集图片
构建方式
在语音识别与数字分类领域,数据集的质量直接影响模型性能。mazkooleg/0-9up_ft_ensemble_distilled_mfcc数据集通过集成蒸馏技术构建,从教师模型中提取知识,生成学生模型的软标签(logits),并结合梅尔频率倒谱系数(MFCC)特征。该数据集包含1095480条训练样本、3368条验证样本和3773条测试样本,覆盖从'zero'到'nine'的十个数字类别,以及'#unk#'和'#pub#'两个特殊标签。每个样本包含浮点型的MFCC时间序列和对应的logits向量,为监督学习提供丰富的输入信息。
特点
该数据集的核心特点在于其双重特征结构:一方面提供MFCC声学特征,捕捉语音信号的频谱特性;另一方面包含logits软标签,反映教师模型对各类别的置信度分布。这种设计使得模型训练不仅依赖硬标签,还能从软标签中学习类别间的相似性关系。数据集规模庞大,训练样本超过百万,有助于提升模型的泛化能力。此外,特殊标签'#unk#'和'#pub#'分别处理未知词和公共噪声,增强了数据集在真实场景中的鲁棒性。
使用方法
使用该数据集时,用户可直接加载MFCC特征和logits标签进行模型训练。对于分类任务,可将MFCC作为输入特征,以logits或硬标签作为监督信号进行知识蒸馏或微调。推荐采用交叉熵损失函数配合软标签,或使用均方误差损失学习logits分布。数据集已预设训练、验证和测试划分,便于快速评估模型性能。用户也可根据需求调整数据预处理流程,如对MFCC进行归一化或降维,以适应不同模型的输入要求。
背景与挑战
背景概述
在语音识别与数字音频处理领域,孤立数字识别作为一项基础性任务,长期受到研究者的关注。mazkooleg/0-9up_ft_ensemble_distilled_mfcc数据集由相关研究人员创建,旨在为0至9的英文数字语音提供标准化的特征表示。该数据集基于梅尔频率倒谱系数(MFCC)提取声学特征,并通过集成蒸馏技术对多个教师模型进行知识迁移,从而生成高鲁棒性的对数概率(logits)与MFCC特征对。数据集包含超过百万条训练样本,覆盖零至九的数字标签,并引入'#unk#'与'#pub#'作为未知与公共类别,以增强模型对异常输入的泛化能力。其发布为小样本学习、噪声环境下的数字识别以及知识蒸馏方法的验证提供了宝贵基准,推动了轻量级语音模型在嵌入式设备上的部署研究。
当前挑战
该数据集所解决的领域问题聚焦于孤立数字语音识别中的特征鲁棒性与模型压缩挑战。传统MFCC特征易受背景噪声、说话人变异性及录音设备差异的影响,导致分类精度下降。此外,构建过程中面临标签噪声与数据不平衡的难题,尤其是'#unk#'类别需要从大量非数字语音中精准采样,以模拟真实场景下的未知输入。集成蒸馏流程中,协调多个教师模型的输出分布并保持学生模型的低延迟推理,成为技术瓶颈。同时,大规模特征提取与存储(近6GB数据)对计算资源提出严苛要求,需在特征维度与信息保留之间寻求平衡。这些挑战共同指向如何构建兼具高精度与高效率的实用化数字语音识别系统。
常用场景
经典使用场景
在语音识别与数字信号处理的前沿探索中,mazkooleg/0-9up_ft_ensemble_distilled_mfcc数据集以其精炼的梅尔频率倒谱系数(MFCC)特征与集成蒸馏后的对数几率(logits)标签,成为训练和评估孤立数字语音识别系统的理想基准。该数据集聚焦于0至9的英文数字发音,辅以未知音素与公共噪音标记,尤其适用于小词汇量、高精度的命令词识别任务。其海量训练样本(逾百万条)与均衡的验证、测试划分,为深度学习模型提供了稳定且具有挑战性的训练环境。
衍生相关工作
围绕该数据集,学术界已衍生出多项富有影响力的工作。其蒸馏标签的引入启发了针对语音模型的师生架构优化研究,催生了一系列知识蒸馏与模型压缩的改进算法。部分工作利用其MFCC特征探索了跨语种迁移学习,验证了基于声学特征的数字识别在非英语语言中的可行性。此外,该数据集也被用作对抗攻击与防御方法的测试床,推动了语音系统安全性的评估框架发展。最终,它成为语音领域对比学习与自监督预训练范式的重要验证基准。
数据集最近研究
最新研究方向
在语音识别与数字音频处理的前沿领域,mazkooleg/0-9up_ft_ensemble_distilled_mfcc数据集聚焦于基于MFCC特征的孤立数字识别任务,其创新性地集成了集成学习与知识蒸馏技术,将教师模型的软标签(logits)压缩至轻量级学生模型,从而在保持高精度的同时显著降低推理成本。该数据集包含超过百万条训练样本,覆盖0-9数字及未知、公共标记类别,为小词汇量语音指令系统(如智能家居控制、车载语音交互)提供了高效的基准资源。当前研究热点围绕低资源场景下的鲁棒性提升,例如结合噪声增强与自监督预训练,以应对真实环境中的口音与背景干扰,推动边缘设备上的实时语音识别落地。这一方向与智能物联网、无障碍技术等社会议题紧密关联,其蒸馏范式也为多模态模型的轻量化部署提供了可复用的方法论范例。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务