
D-ExpTracker__qwen25_15b_instruct_bestofn_atags_countdown_4arg_5__v1
收藏数据链接:
官方服务:
资源简介:
这是一个用于Skill Factory工作流的简单测试实验数据集,包含问题和答案以及相关的任务配置和元数据信息。数据集分为测试集和训练集,测试集有4000个示例,而训练集仅有5个示例。
创建时间:
2025-08-30
原始信息汇总
数据集概述
基本信息
- 数据集名称: TAUR-dev/D-ExpTracker__qwen25_15b_instruct_bestofn_atags_countdown_4arg_5__v1
- 实验描述: Simple test experiment for Skill Factory workflows
- 开始时间: 2025-08-30T14:15:15.137213
- 总阶段数: 1
数据集配置
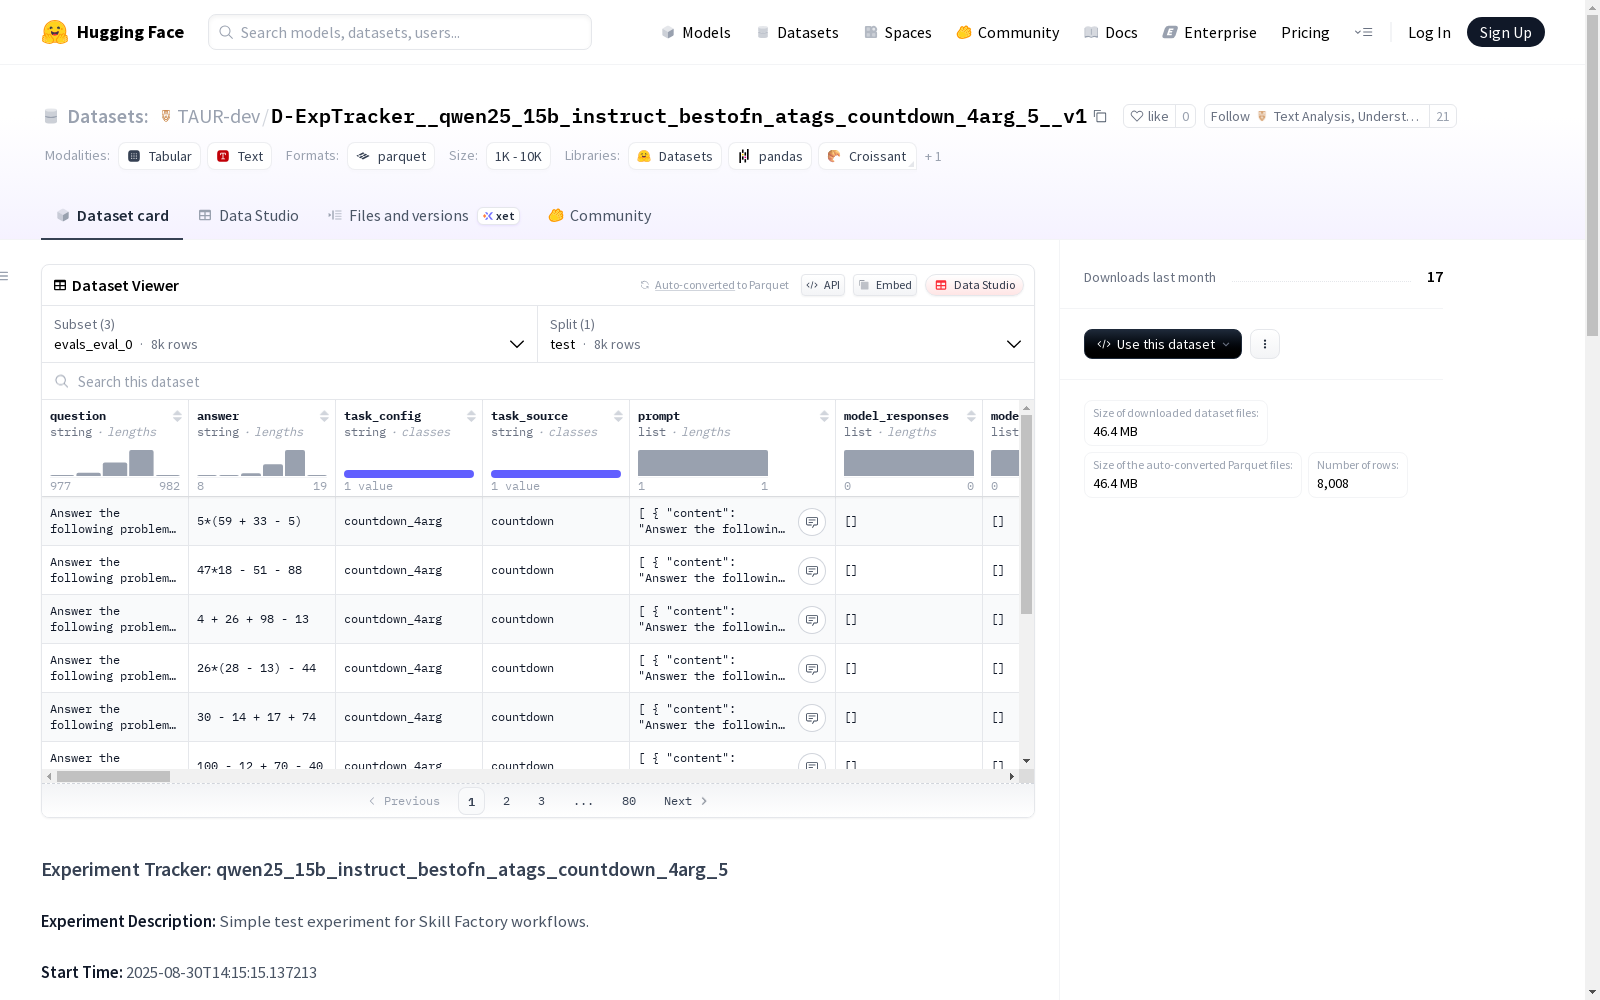
配置1: evals_eval_0
- 特征字段:
- question: 字符串类型
- answer: 字符串类型
- task_config: 字符串类型
- task_source: 字符串类型
- prompt: 列表结构,包含content和role字段
- model_responses: 序列类型
- model_responses__eval_is_correct: 序列类型
- all_other_columns: 字符串类型
- original_split: 字符串类型
- metadata: 字符串类型
- model_responses__best_of_n_atags: 字符串序列
- model_responses__best_of_n_atags__finish_reason_length_flags: 布尔序列
- model_responses__best_of_n_atags__length_partial_responses: 字符串序列
- prompt__best_of_n_atags__metadata: 结构化数据,包含api_url、backend、chat_template_applied、generation_params、model_name、prompt等字段
- model_responses__best_of_n_atags__metadata: 结构化数据,包含backend、model_name、n_responses字段
- model_responses__best_of_n_atags__eval_is_correct: 布尔序列
- model_responses__best_of_n_atags__eval_extracted_answers: 字符串序列
- model_responses__best_of_n_atags__eval_extraction_metadata: 列表结构,包含extraction_type、non_overlapping_spans、original_span、span_end、span_start、total_spans_found字段
- model_responses__best_of_n_atags__eval_evaluation_metadata: 列表结构,包含answer_block、error、evaluation_method、extraction_result、final_answer、is_correct、reason字段
- model_responses__best_of_n_atags__internal_answers__eval_is_correct: 布尔序列的序列
- model_responses__best_of_n_atags__internal_answers__eval_extracted_answers: 字符串序列的序列
- model_responses__best_of_n_atags__internal_answers__eval_extraction_metadata: 列表的列表,包含confidence、extraction_type、original_span、pattern_used、position、span_end、span_start、span_text字段
- model_responses__best_of_n_atags__internal_answers__eval_evaluation_metadata: 列表的列表,包含answer_block、error、final_answer、is_correct字段
- model_responses__best_of_n_atags__metrics: 结构化数据,包含flips_by、flips_total、num_correct、pass_at_n、percent_correct、skill_count、total_responses字段
- eval_date: 字符串类型
- split: 字符串类型
- revision_name: 字符串类型
- model_path: 字符串类型
- checkpoint_step: 整型
- stage_name: 字符串类型
- stage_number: 整型
- timestamp: 字符串类型
- eval_repo_id: 字符串类型
- 数据分割:
- test分割: 80,000个样本,129,237,711字节
- 下载大小: 29,737,591字节
- 数据集大小: 129,237,711字节
配置2: logs__evaluation_eval_0
- 特征字段:
- timestamp: 字符串类型
- end_timestamp: 字符串类型
- stage_name: 字符串类型
- stage_number: 整型
- level: 字符串类型
- message: 字符串类型
- stdout_content: 字符串类型
- stderr_content: 字符串类型
- experiment_name: 字符串类型
- elapsed_time_seconds: 浮点型
- stage_complete: 布尔型
- 数据分割:
- train分割: 1个样本,254,620,410字节
- 下载大小: 16,686,268字节
- 数据集大小: 254,620,410字节
配置3: metadata
- 特征字段:
- experiment_name: 字符串类型
- start_time: 字符串类型
- description: 字符串类型
- base_org: 字符串类型
- stage_number: 字符串类型
- stage_type: 字符串类型
- status: 字符串类型
- 数据分割:
- train分割: 8个样本,13,154字节
- 下载大小: 8,432字节
- 数据集大小: 13,154字节
使用方式
可通过datasets库加载特定配置,支持加载实验元数据、训练数据集、超参数配置、阶段日志和评估结果。
模型注册
实验中的所有模型自动注册在SkillFactory模型注册表中,包含完整的训练配置、实验谱系、阶段特定元数据和结构化输入数据引用。
搜集汇总
数据集介绍
构建方式
在人工智能模型评估领域,D-ExpTracker数据集通过结构化实验追踪框架构建,采用多配置模块化设计。该数据集以Qwen-25-15B模型为基准,通过Best-of-N采样策略生成多样化响应,并集成自动标注管道对模型输出进行精确评估。构建过程涵盖问题生成、多轮对话模拟、响应质量标注及元数据记录,确保实验数据的可追溯性与完整性。
特点
本数据集具备多维特征表征能力,包含8000条高质量评估样本,每条记录均涵盖原始问题、模型响应序列及精细化评估指标。其突出特点在于嵌套式数据结构,可捕获生成过程中的中间状态与最终输出间的关联性。数据集深度融合了响应正确性标注、答案提取元数据以及技能分布统计,为模型行为分析提供立体化视角。特别设计的评估元数据层支持对模型决策过程的透视图分析,满足复杂评估场景的需求。
使用方法
研究人员可通过HuggingFace数据集库直接加载不同配置模块,包括实验元数据、评估结果和日志记录。使用load_dataset函数指定配置名称即可访问结构化数据,例如加载'eval_eval_0'配置获取模型响应评估数据。数据集支持分层查询,既可宏观分析模型整体表现,也可深入探查单个响应生成细节。其标准化格式便于集成到现有评估流程,为模型对比研究和迭代优化提供基础设施支持。
背景与挑战
背景概述
在大型语言模型快速发展的背景下,TAUR研究团队于2025年推出了D-ExpTracker__qwen25_15b_instruct_bestofn_atags_countdown_4arg_5__v1数据集,该数据集专注于模型推理能力的系统性评估。作为SkillFactory工作流的重要组成部分,该数据集通过结构化记录Qwen-25B模型在计数推理任务上的多轮响应数据,为研究社区提供了模型自我修正能力和推理路径分析的宝贵资源。其创新性的评估框架设计推动了语言模型可解释性研究的发展,成为分析模型内部决策机制的重要基准。
当前挑战
该数据集构建面临多维度挑战:在领域问题层面,需要精确评估模型在复杂计数推理任务中的表现,特别是处理嵌套参数和时序依赖关系的能力;在技术实现层面,需设计能够捕捉模型多轮响应动态变化的评估指标,包括响应翻转分析和正确率追踪。数据标注过程中,需要开发自动化评估管道来处理大规模响应数据,同时确保答案提取和正确性判断的准确性,这对评估系统的鲁棒性和可扩展性提出了极高要求。
常用场景
解决学术问题
该数据集有效解决了大语言模型评估中缺乏标准化测试框架的学术难题,通过提供包含答案提取验证、响应质量标注和元数据分析的完整评估链条,为模型能力量化研究提供了可靠数据支撑。其创新的多响应对比机制和错误模式分类体系,显著推进了模型鲁棒性分析和失败模式诊断的研究进展,对提升模型可解释性具有重要理论价值。
衍生相关工作
基于该数据集衍生的研究工作主要集中在智能评估方法论创新领域,包括多模态推理能力评估框架、基于强化学习的模型优化策略以及自动化错误模式分类系统。这些工作通过扩展原始数据集的评估维度和分析方法,推动了模型能力评估从单一准确率指标向多维能力图谱的演进,为后续的大模型评估标准制定提供了重要参考。
以上内容由遇见数据集搜集并总结生成


