synthetic-pii-phi-v2
收藏资源简介:
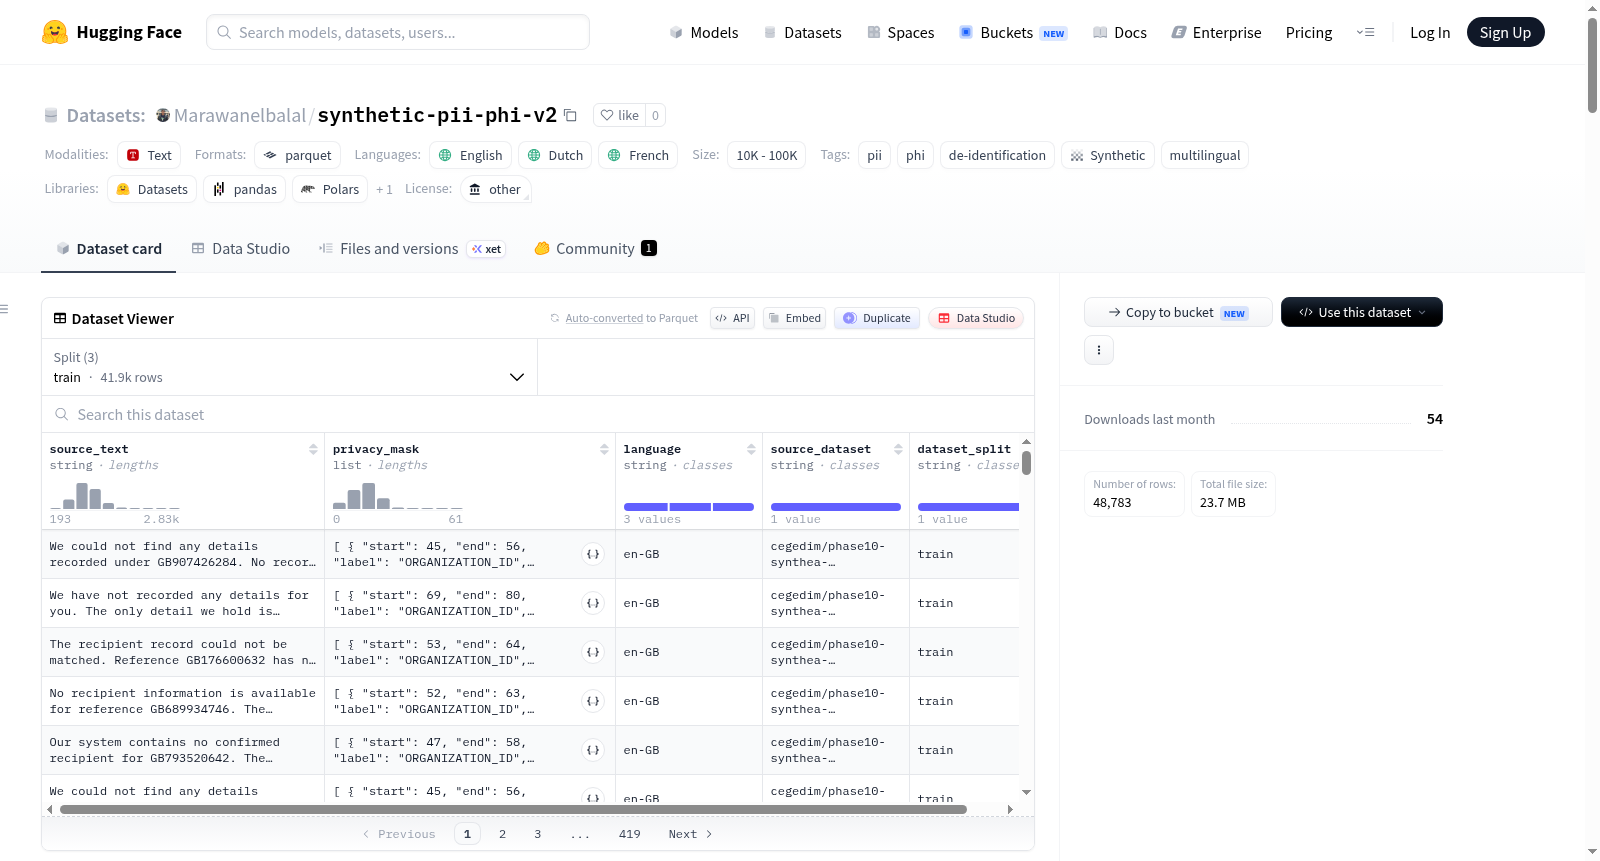
该数据集是一个合成多语言PII/PHI去标识化语料库(v3版本),专为训练多语言去标识化(Token分类)模型而设计。数据集包含来自三个地区(en-GB、nl-BE、fr-FR)的合成临床/行政文档,每篇文档均带有字符级PII/PHI实体标注(如姓名、ID、日期、地址、实验室结果等)。所有实体值均为合成生成,绝不包含真实患者、提供者或组织数据;城市名称和邮政编码词干是真实的(因为城市名不属于个人数据,且文档需要合理的地点),其余所有内容均为构造。数据规模:总计48,783行,其中训练集41,854行,开发集2,964行,测试集3,965行。每个地区大致均衡分布。字段说明:每行包含`source_text`(完整文档文本)、`privacy_mask`(字符偏移的实体列表,含开始/结束位置、标签和值)、`language`(地区代码)、`source_dataset`(溯源标签)、`dataset_split`(训练/开发/测试)。实体标签共32个,包括核心标签(如AGE, BLOOD_TYPE, BMI, BUILDINGNUM, CITY, DATE, DIAGNOSIS, DOSAGE, EMAIL, GENDER, HEALTH_INSURANCE_ID, HEIGHT, LAB_RESULT, MEDICATION, MRN, NAME, ORGANIZATION_ID, ORGANIZATION_NAME, PHONE_NUMBER, PROCEDURE, SEX, STREET, SYMPTOM, URL, WEIGHT, ZIPCODE)以及地区特定标识符(en-GB的NHS_NUMBER/GMC,nl-BE的INSZ/RIZIV,fr-FR的NIR/RPPS)。构建方法:基于Synthea派生管道,通过LLM生成文本模板(蓝图),填充合成身份值和实体值,经过组成、渲染、确定性缩写、无实体文档生成、防泄漏分割等步骤。v3版本相较于v2进行了术语池分离、单次复用率降低、后渲染补丁(标识符表面形式多样化、硬负例添加、邮政编码和电话号码格式修正、日期格式扩展)等改进。已知局限:文档内可能存在叙事矛盾(因不同蓝图组合共享同一诊断值,导致同一文档不同部分断言和否定同一发现);无实体文档仅出现在训练集中。适用任务:多语言去标识化(Token分类),特别是训练能够识别并遮盖PII/PHI实体的模型。
This dataset is a synthetic multilingual PII/PHI de-identification corpus (v3) designed for training multilingual de-identification (token classification) models. It contains synthetic clinical/administrative documents from three regions (en-GB, nl-BE, fr-FR) with character-level annotations of PII/PHI entities (e.g., names, IDs, dates, addresses, lab results). All entity values are synthetically generated and contain no real patient, provider, or organization data; city names and ZIP code stems are real (as city names are not personal data and documents require plausible locations), while everything else is constructed. Data size: 48,783 rows total, with 41,854 training, 2,964 development, and 3,965 test rows, roughly balanced per region. Fields: each row includes `source_text` (full document text), `privacy_mask` (list of character-offset entities with start/end positions, labels, and values), `language` (region code), `source_dataset` (provenance tag), and `dataset_split` (train/dev/test). There are 32 entity labels, including core tags (AGE, BLOOD_TYPE, BMI, BUILDINGNUM, CITY, DATE, DIAGNOSIS, DOSAGE, EMAIL, GENDER, HEALTH_INSURANCE_ID, HEIGHT, LAB_RESULT, MEDICATION, MRN, NAME, ORGANIZATION_ID, ORGANIZATION_NAME, PHONE_NUMBER, PROCEDURE, SEX, STREET, SYMPTOM, URL, WEIGHT, ZIPCODE) and region-specific identifiers (NHS_NUMBER/GMC for en-GB, INSZ/RIZIV for nl-BE, NIR/RPPS for fr-FR). Construction: based on the Synthea-derived pipeline, using LLM-generated text templates (blueprints) filled with synthetic identity and entity values, followed by composition, rendering, deterministic abbreviation, entity-free document generation, and leakage-proof splitting. v3 improvements over v2 include term pool separation, reduced single-use reuse rate, and post-rendering patches (identifier surface form diversification, hard negative addition, ZIP code and phone number format correction, date format expansion). Known limitations: possible narrative contradictions within documents (due to different blueprints sharing the same diagnosis value, leading to assertion and negation of the same finding in different parts of the same document); entity-free documents only appear in the training set. Applicable task: multilingual de-identification (token classification), especially for training models to recognize and mask PII/PHI entities.
数据集概述:Synthetic Multilingual PII/PHI De-identification Corpus (v3)
基本信息
- 数据集名称:Synthetic PII/PHI v3
- 许可证:other(自定义许可证)
- 语言:英语(en-GB)、荷兰语(nl-BE)、法语(fr-FR)
- 标签:PII(个人身份信息)、PHI(个人健康信息)、去标识化、合成数据、多语言
- 数据集地址:https://huggingface.co/datasets/Marawanelbalal/synthetic-pii-phi-v2
数据集内容
该数据集包含三个语言区域的合成临床/行政文档,带有跨度级别的PII/PHI标注,专为训练多语言去标识化(token分类)模型而构建。所有实体值——姓名、ID、日期、地址、实验室结果——均为合成生成,不包含任何真实患者、提供者或组织数据。
数据划分
| 划分 | 行数 | en-GB | nl-BE | fr-FR |
|---|---|---|---|---|
| train | 41,854 | 13,653 | 14,480 | 13,721 |
| development | 2,964 | 988 | 988 | 988 |
| test | 3,965 | 1,352 | 1,352 | 1,261 |
总计48,783行。
实体标签(共32个标签)
- 核心标签(所有3个语言区域):AGE, BLOOD_TYPE, BMI, BUILDINGNUM, CITY, DATE, DIAGNOSIS, DOSAGE, EMAIL, GENDER, HEALTH_INSURANCE_ID, HEIGHT, LAB_RESULT, MEDICATION, MRN, NAME, ORGANIZATION_ID, ORGANIZATION_NAME, PHONE_NUMBER, PROCEDURE, SEX, STREET, SYMPTOM, URL, WEIGHT, ZIPCODE
- 地区特定标识符方案:NHS_NUMBER、GMC(en-GB);INSZ、RIZIV(nl-BE);NIR、RPPS(fr-FR)
数据模式(Schema)
每行包含:
source_text(字符串):完整文档文本privacy_mask(列表[{start, end, label, value}]):字符偏移跨度及其实体标签和子字符串值language(字符串):语言代码(en-GB、nl-BE、fr-FR)source_dataset(字符串):来源标签dataset_split(字符串):train / development / test
主要特点
- 合成数据:所有实体值均为合成生成,无真实个人数据泄露
- 术语池分离:DIAGNOSIS、SYMPTOM和LAB_RESULT使用独立、不重叠的术语池
- 跨文档一致性:同一文档内实体的身份和值保持一致
- 无实体文档:包含不含任何PII/PHI实体的文档作为训练负例
- 防泄漏划分:基于blueprint_id进行聚类,确保同一模板的文本不会出现在多个划分中
- 低文本重复率:最常用的精确文档文本最多出现在0.0205%的文档中
v3版本改进
- 术语池分离修复(DIAGNOSIS/SYMPTOM重叠从92%降至6/1687个术语)
- 降低单句重复使用率
- 增强标识符表面形式多样性(如NHS号码添加分隔符)
- 添加BMI形态的硬负例句子
- 完善en-GB ZIPCODE为完整邮编格式(如M9→M9 4TF)
- 约40%电话号码改写为国际形式
- 添加5种新的硬负例句子族(共27,140条)
- 增加日期序数后缀和月份优先格式(10,022个日期实体被重新格式化)
构建方法
- 蓝图生成:LLM生成带{{PLACEHOLDER}}槽位的短文本模板
- 值/身份填充:每个文档采样一次合成身份和实体值集
- 组合:基于文档族矩阵构建不同的槽位排列
- 渲染:每种组合渲染多次,每次使用新的合成身份和措辞
- 确定性缩写处理:约15%的候选措辞池应用临床简写
- 无实体文档:单独生成不含PII/PHI的文档
- 防泄漏划分:按蓝图ID聚类分配至单一划分
- 验证:包括术语池独立性检查、跨度/偏移缺陷检查、文本重复率验证
已知限制
- 文档内叙述矛盾:不同部分可能对同一诊断既肯定又否定,但不影响实体标注正确性
- 无实体文档仅存在于训练集:development/test划分中不含此类文档
来源
由Synthea衍生的合成临床文档生成流水线构建,文档由LLM生成的文本模板(“蓝图”)填充合成身份/实体值而成。