
遇见数据集

trillionlabs/TheBioCollection-Eval

收藏
Hugging Face2026-06-26 更新2026-07-22 收录
官方服务:

资源简介:

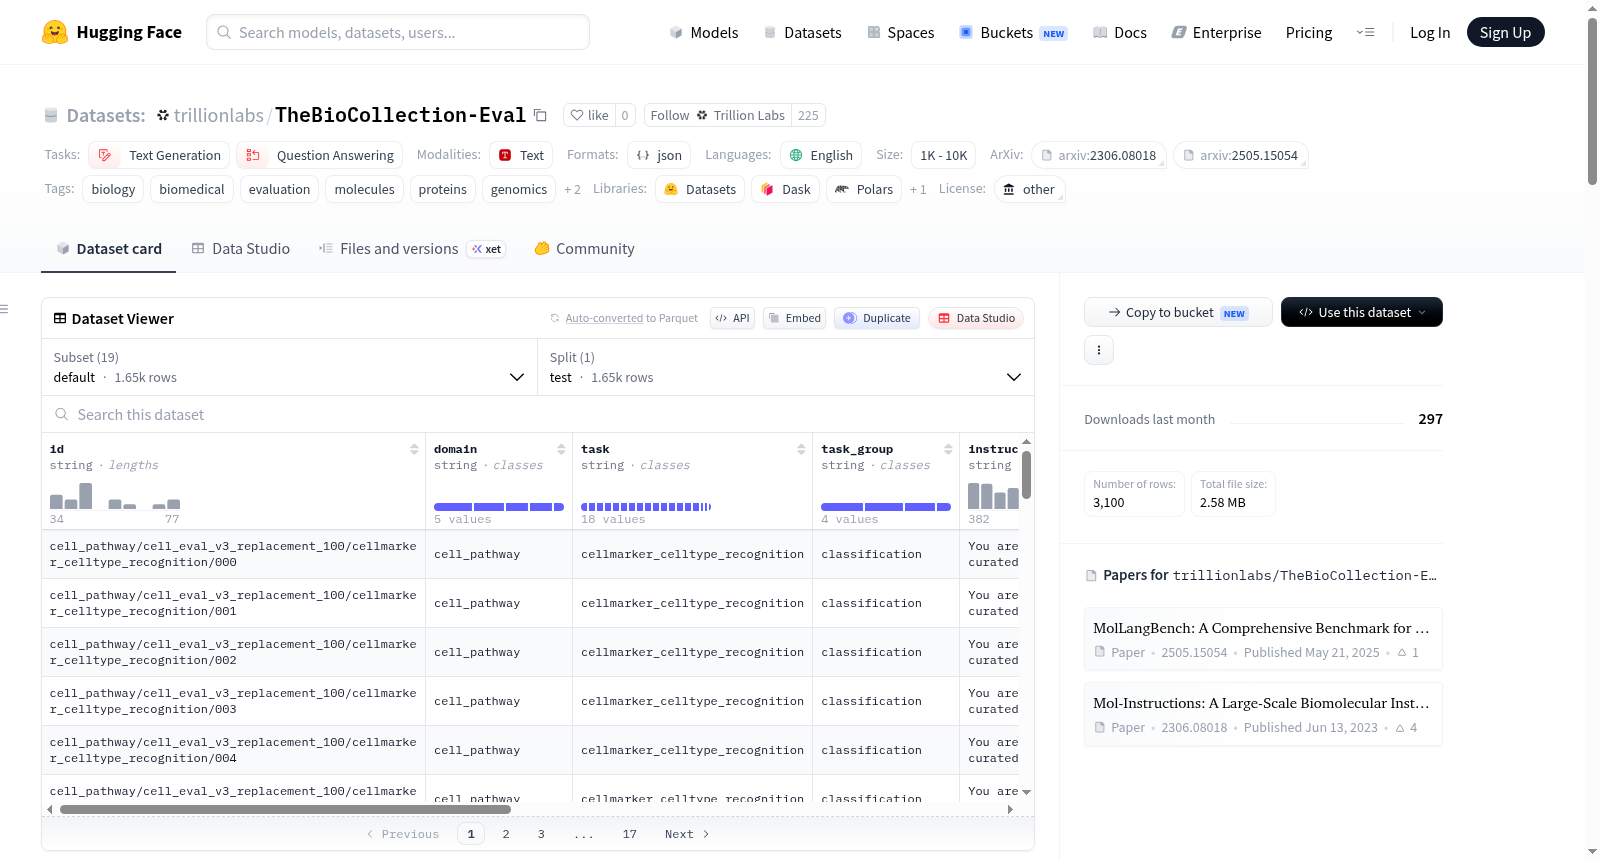
TheBioCollection-Eval是一个生物学评估套件,用于评估生物领域大型语言模型(BioLMs)在多个生物学子领域的性能。它覆盖小分子、蛋白质、基因组序列、细胞/通路和跨领域推理等方向,通过整合现有基准(如Mol-Instructions、MolLangBench、BioReason-Pro、PerturBench Replogle K562)和新构建的指令数据集构建而成。套件包含总计1650个查询,涉及描述引导的分子设计、蛋白质功能预测、基因组序列定位、细胞类型分类、跨领域推理等多种子任务,数据以压缩JSONL格式存储,专为研究评估设计,不适用于临床或治疗决策。

TheBioCollection-Eval is a biological evaluation suite for assessing large language models (BioLMs) for biology across small molecules, proteins, genomic sequences, cells/pathways, and cross-domain reasoning. It is constructed by drawing subtasks from many scattered existing benchmarks (Mol-Instructions, MolLangBench, BioReason-Pro, PerturBench Replogle K562) and combining them with source-derived newly-constructed instruction datasets. The suite includes a total of 1,650 queries covering various subtasks such as description-guided molecule design, protein function prediction, genomic sequence localization, cell-type classification, and cross-domain reasoning. Data is stored in compressed JSONL format and is intended for research evaluation only, not for clinical or therapeutic decision-making.
提供机构:
trillionlabs
搜集汇总
数据集介绍
trillionlabs/TheBioCollection-Eval 数据集图片
构建方式
TheBioCollection-Eval是一个面向生物学领域大型语言模型的系统性评估套件。其构建方式遵循跨领域整合与分而治之的思路:首先从现有的生物信息学基准中抽取核心子任务,涵盖小分子、蛋白质、基因组序列、细胞/通路及跨域推理五大板块,例如Mol-Instructions、MolLangBench、BioReason-Pro及PerturBench Replogle K562等公开数据集;继而针对每个粒度层级,补充由原始生物学来源数据新构建的指令微调测试样本,以弥补现有基准在多样性和覆盖度上的不足。最终,所有子任务被统一组织为结构化的JSONL压缩文件,按域与任务名称分层存放,并提供了涵盖全数据集的默认配置以及各子任务的独立配置,便于研究人员根据需求进行灵活的流水线评估。
使用方法
用户可通过Hugging Face datasets库便捷加载该数据集。推荐方式为使用默认配置加载全部子任务数据以进行综合评估:`load_dataset('trillionlabs/TheBioCollection-Eval', split='test')`。若需聚焦某一具体领域,可指定子任务对应的配置名称,例如加载小分子识别任务时使用`load_dataset('trillionlabs/TheBioCollection-Eval', 'small_molecule__mollangbench_recognition', split='test')`。数据集专为科研目的设计,不适用于临床诊断或治疗决策。配合GitHub仓库中提供的评估代码,研究者可复现论文中的评测流程,并基于TheBioCollection训练语料进一步优化模型在这一基准上的表现。
背景与挑战
背景概述
随着大语言模型在生物学领域应用的迅猛发展,系统性、多维度评估这些模型在分子、蛋白质、基因组、细胞通路及跨域推理等核心任务上的表现,成为推动科学发现与模型落地的关键瓶颈。为填补这一空白,Lunit与Trillion Labs联合多家学术及医疗机构,于2026年发布了TheBioCollection-Eval评估基准。该数据集精心整合了来自Mol-Instructions、MolLangBench、BioReason-Pro等既有基准中的子任务,并结合全新构建的指令数据,形成了涵盖5大领域18个子任务的标准化评测集。其发布不仅为生物学大语言模型(BioLM)提供了统一、可复现的评估框架,更通过跨域推理等创新任务,深刻揭示了模型在复杂生物知识融合方面的能力边界,对相关领域的模型设计、训练策略优化及下游应用具有重要的导向作用。
当前挑战
TheBioCollection-Eval所面对的挑战具有双重维度。在领域问题层面,其聚焦于生物学大语言模型在分子生成、蛋白质功能预测、基因组元件定位、细胞通路响应推断以及多个生物实体间的跨域推理等异构任务上的综合评估,这些任务要求模型同时具备精准的符号理解、生物序列的序列逻辑把握以及因果关系的推演能力,远非单一域内任务可比。在构建过程中,挑战亦相当严峻:开发团队需要从分散于不同文献、数据库与格式的既有基准中提取并统一清洗子任务,确保数据格式、标注一致性与跨任务的可比性;同时,对于知识图谱等复杂关系型任务,还需从原始文献与数据库出发进行全新构建,在保证科学准确性的前提下,设计出足够严谨且具有区分度的指令示例,这对领域专业知识、工程效率以及质量控制的协同提出了极高要求。
常用场景
经典使用场景
在生物学与人工智能交叉领域的研究中,TheBioCollection-Eval 被广泛用作评估大型语言模型在多模态生物知识上综合能力的标准测试平台。该数据集涵盖了小分子、蛋白质、基因组序列、细胞通路及跨域推理等五个核心领域,每个子任务均设计为基于自然语言指令的问答形式,可系统性地检验模型在分子设计、蛋白质功能预测、基因序列定位、细胞类型识别以及跨知识图谱推理等任务上的表现。研究人员常利用该基准来对比不同生物语言模型的泛化能力与领域专精程度。
解决学术问题
该数据集有效解决了当前生物领域大语言模型评估碎片化、标准不统一的核心学术问题。以往针对生物分子、基因和细胞通路等任务的评估分散于多个独立基准,难以横向对比。TheBioCollection-Eval 通过整合 Mol-Instructions、MolLangBench、BioReason-Pro 等已有评测资源并补充新构建的指令数据集,首次提供了一个覆盖从小分子到跨域推理的完整评估体系,从而推动了生物语言模型在零样本推理、多任务泛化与跨域知识迁移能力研究上的标准化进程。
实际应用
在实际应用中,TheBioCollection-Eval 可用于指导生物语言模型在药物研发、精准医疗与合成生物学等关键领域部署前的性能验证。例如,在描述引导的分子设计任务中,模型需依据自然语言描述生成合理的候选分子结构,这直接服务于先导化合物发现与优化流程;而跨域推理任务要求模型同时理解蛋白质功能与信号通路之间的映射关系,有助于揭示疾病机制并识别潜在药物靶点。该数据集还适用于评估模型在基因编辑靶点定位、RNA 序列注释及细胞类型分类等场景中的准确性。
数据集最近研究
最新研究方向
伴随大语言模型在生物医学领域的纵深渗透,如何系统性地评估其对多层级生物实体的理解能力已成为核心挑战。TheBioCollection-Eval应运而生,作为首个跨小分子、蛋白质、基因组序列、细胞通路与跨领域知识图谱的综合评测套件,填补了现有基准碎片化、粒度不均的空白。该数据集从Mol-Instructions、PerturBench等前沿基准中汲取精华,并结合全新构建的指令样本,精准聚焦当前最热门的分子设计、蛋白质结合子生成、CRISPR扰动响应预测及转录因子调控靶基因推理等研究热点。其设计不仅呼应了AI驱动药物发现与合成生物学对可解释性、跨模态泛化的迫切需求,更通过统一评测框架为生物基础模型的公平比较与迭代优化提供了可靠基石,有望加速生命科学领域通用智能体从实验室走向真实应用的进程。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

