
遇见数据集

hao-li/AIDev-v1.2

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

AIDev是一个大规模数据集,旨在捕捉真实世界开源软件工程中自主编码代理(AI队友)的出现情况。该数据集包含多个配置,覆盖了与AI代理相关的拉取请求、仓库、用户、评论、审查、提交和问题等数据,例如所有拉取请求、所有仓库、所有用户、拉取请求、仓库、PR时间线、PR评论、PR审查、PR审查评论、PR提交、PR提交详情、PR任务类型、用户、相关问题、问题、人类拉取请求和人类PR任务类型。数据集中记录了不同AI代理(如OpenAI Codex、Copilot、Claude Code、Cursor、Google Jules、Devin)的拉取请求统计信息,包括拉取请求数量、开放PR百分比、关闭PR百分比、合并PR百分比、开发者数量和仓库数量,总计涉及7,685,281个拉取请求、393,349名开发者和961,168个仓库。

AIDev is a large-scale dataset capturing the emergence of autonomous coding agents (AI teammates) within real-world open-source software engineering. The dataset includes multiple configurations covering data related to AI agents, such as all pull requests, all repositories, all users, pull requests, repositories, PR timeline, PR comments, PR reviews, PR review comments, PR commits, PR commit details, PR task type, users, related issues, issues, human pull requests, and human PR task type. It records statistical information on pull requests from various AI agents (e.g., OpenAI Codex, Copilot, Claude Code, Cursor, Google Jules, Devin), including the number of pull requests, percentage of open PRs, closed PRs, merged PRs, number of developers, and number of repositories, totaling 7,685,281 pull requests, 393,349 developers, and 961,168 repositories.
提供机构:
hao-li
搜集汇总
数据集介绍
hao-li/AIDev-v1.2 数据集图片
构建方式
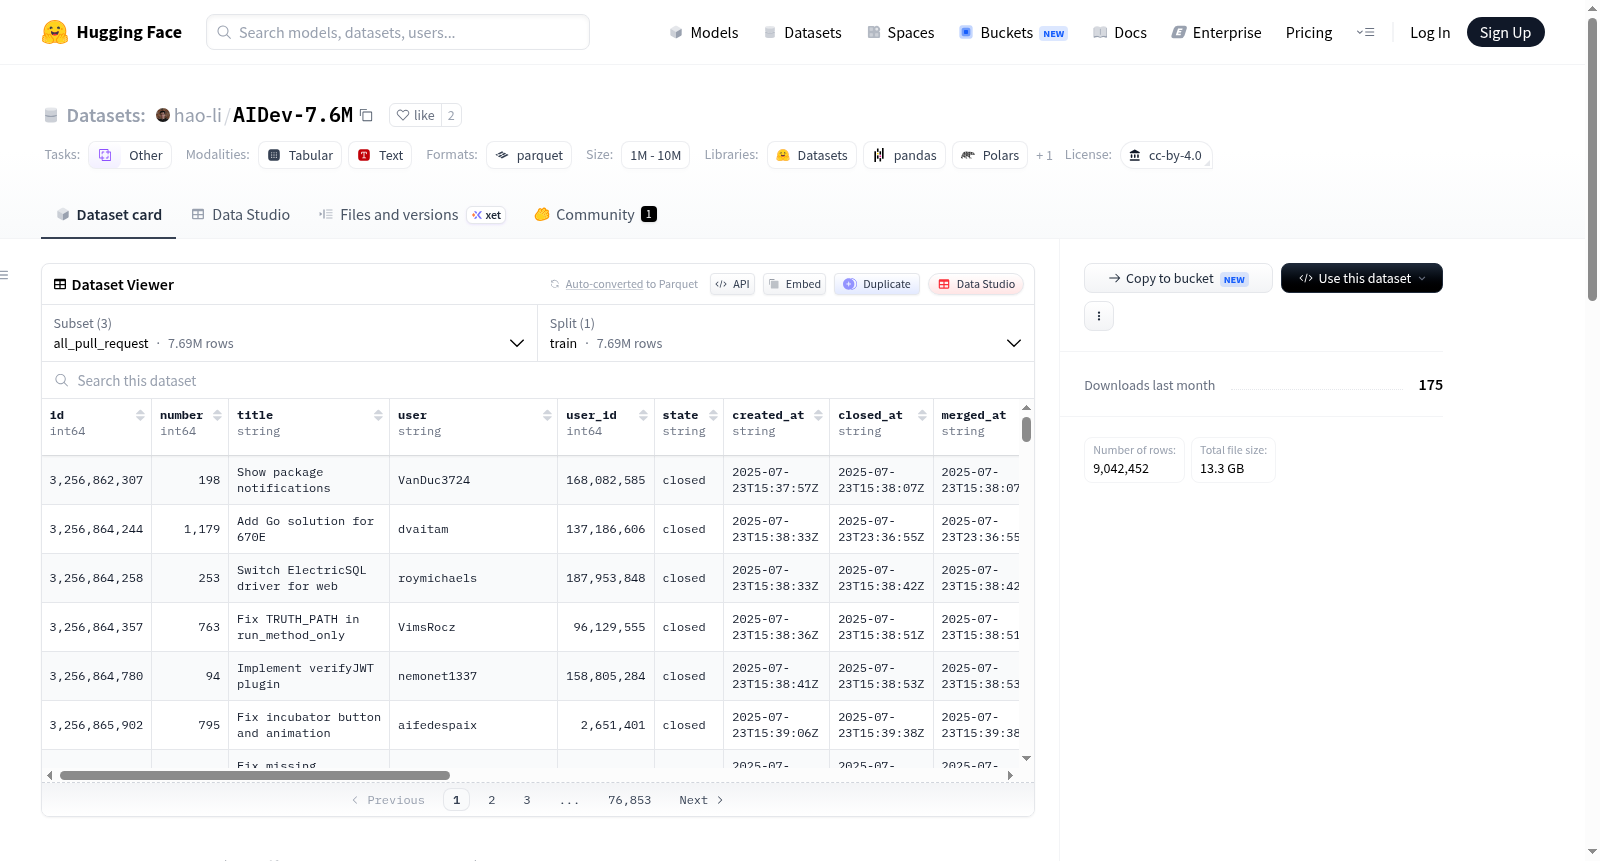
AIDev-v1.2数据集的构建基于对全球开源软件生态中自主编码智能体活动的系统化挖掘。研究者通过扫描截至2026年3月31日的GitHub平台数据,精准识别并提取了由六类代表性AI编程助手(包括OpenAI Codex、Copilot、Claude Code、Cursor、Google Jules和Devin)所发起的Pull Request记录。数据集以Parquet格式存储,涵盖三个核心配置——all_pull_request、all_repository和all_user,分别聚焦于PR级别的详细信息、仓库维度的统计特征以及用户层面的行为轨迹。每条PR记录包含标题、状态、创建与合并时间、关联仓库及智能体标识等字段,从而为解析人机协作的软件开发模式提供了结构化、可量化的基础数据支撑。
特点
该数据集最显著的特征在于其规模化与跨智能体的对比分析能力。总计收录超过768万条有效PR记录,覆盖近40万名开发者与96万个独立代码仓库,展现出极高的生态覆盖广度。通过内置的智能体标签字段,研究者能够直接比较不同AI编程工具在代码贡献中的采纳率、合并成功率和运维效率——例如数据显示Claude Code的PR合并率高达88.0%,而Cursor的贡献则呈现较高的开放性。此外,数据集包含了PR从创建到关闭或合并的完整生命周期时间戳,以及用户与仓库的关联图谱,这为研究AI辅助开发行为、团队协作模式及自动化代码审查流程提供了多维度的分析视角。
使用方法
使用者可通过HuggingFace Datasets库便捷加载AIDev-v1.2的任一配置,例如利用load_dataset函数指定'all_pull_request'子集即可获取完整的PR事件流。数据以Parquet列式存储格式提供,兼容主流数据科学工具如Pandas和Spark,便于进行大规模计算与分析。官方还提供了Google Colab上的交互式示例笔记本,引导研究者快速开展探索性数据分析、可视化智能体行为分布或构建预测模型。推荐的应用方向包括:对比不同AI工具的代码贡献质量、分析开发者对AI助手的信任演化趋势,以及基于时间序列数据建模自主编码智能体的采纳扩散路径。
背景与挑战
背景概述
随着大型语言模型与软件工程领域的深度融合,自主编码智能体(AI teammate)正逐步从概念验证阶段迈向实际应用,其行为模式与协作效能成为学术界与工业界共同关注的焦点。在此背景下,AIDev-v1.2数据集应运而生,由研究团队于2026年3月31日构建发布,专注于捕获真实世界开源软件工程中自主编码智能体的涌现现象。该数据集涵盖了OpenAI Codex、Copilot、Claude Code、Cursor、Google Jules及Devin等六类主流AI智能体,累计收录超过768万条Pull Request记录,涉及39万余名开发者及96万余个代码仓库,为量化分析AI智能体在软件开发全生命周期中的作用机制、协作效率及演化规律提供了前所未有的数据基础,对推动软件工程智能化转型与AI辅助开发研究具有里程碑式意义。
当前挑战
该数据集首先直面领域内核心问题的挑战:传统软件工程研究多聚焦于人类开发者行为,而自主编码智能体的引入使得代码贡献模式、协作流程及质量评估体系发生根本性变革,需重新定义AI智能体与人类协同开发的评价指标与基准。其次,在数据集构建过程中,团队面临多重技术挑战:如何从海量开源仓库中精准识别并区分不同AI智能体生成的Pull Request,需解决代理标识模糊性与数据噪声问题;跨平台、跨仓库的数据异构性要求设计统一的特征提取框架,包括智能体类型、PR状态、开发者关联等16个字段的标准化录入;时间跨度长达数年的数据清洗与版本对齐工作,以及确保数据隐私合规性,亦构成了现实障碍。
常用场景
经典使用场景
AIDev-v1.2数据集围绕自主编码代理(AI队友)在真实开源软件工程中的崛起而构建,其经典使用场景在于系统性地追踪和分析人工智能代理在代码协作中的行为模式。研究人员可利用该数据集中的拉取请求(PR)元数据、代理身份和仓库信息,探索不同AI开发工具(如OpenAI Codex、Copilot、Claude Code等)在代码贡献频率、合并成功率及关闭状态上的差异,从而揭示代理在开源社区中的参与特征及其对软件开发生命周期的影响。
解决学术问题
该数据集解决了学术界长期面临的一个关键问题:缺乏大规模、跨代理的实证基础来理解AI编码代理对开源软件工程生态的实质影响。通过涵盖近770万条PR记录、来自数十万开发者及近百个代理类型的数据,AIDev-v1.2使得研究者能够量化不同代理在代码集成效率、协作质量及开发者互动模式上的异同,进而推动对AI辅助编程的效能评估、代理行为分类及开源协作演变等前沿问题的深入探讨。这一资源为软件工程、人机交互及人工智能交叉领域提供了坚实的实证基础,具有深远的方法论意义。
衍生相关工作
AIDev-v1.2的发布催生了多个方向的衍生研究工作。基于其丰富的代理标签和PR元数据,学者已构建出用于预测代码合并成功率的分类模型、分析代理与人类开发者协作网络图谱的研究,以及评估不同编程辅助工具在复杂代码库中编码效能的对比框架。此外,该数据集也促进了跨区域代理行为差异的挖掘,启发了针对低合并率代理的优化策略研究。随着版本更新至2026年3月,其时间跨度拓展将进一步支撑长期代理演化趋势及开源生态适应性变化的追踪工作。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

