
Synthetic-Persona-Chat-Mapping_1k-ERNIE-original
收藏数据链接:
官方服务:
资源简介:
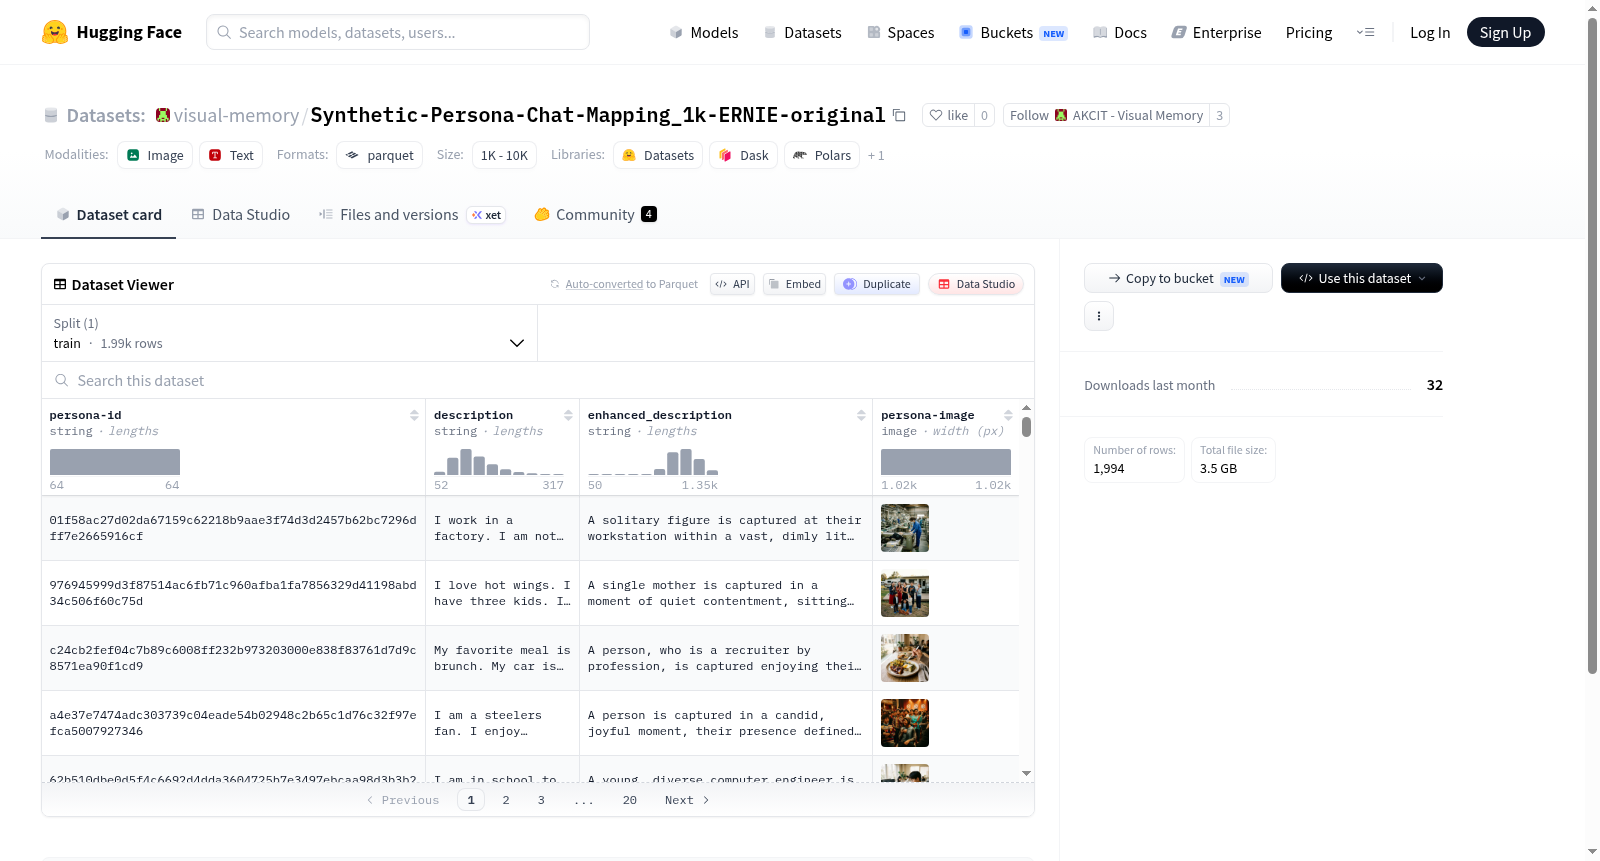
该数据集包含训练集,共1994个样本。每个样本包含四个字段:persona-id(字符串类型,人物角色标识符)、description(字符串类型,人物角色描述)、enhanced_description(字符串类型,增强版人物角色描述)以及persona-image(图像类型,人物角色图像)。数据集总大小约为3.5 GB。
This dataset contains a training set with 1994 samples. Each sample includes four fields: persona-id (string type, character identifier), description (string type, character description), enhanced_description (string type, enhanced character description), and persona-image (image type, character image). The total size of the dataset is approximately 3.5 GB.
创建时间:
2026-08-19
原始信息汇总
Synthetic-Persona-Chat-Mapping_1k-ERNIE-original 数据集详情
基本信息
- 数据集名称: Synthetic-Persona-Chat-Mapping_1k-ERNIE-original
- 数据集地址: https://huggingface.co/datasets/visual-memory/Synthetic-Persona-Chat-Mapping_1k-ERNIE-original
数据结构
数据字段
该数据集包含以下四个字段:
| 字段名 | 数据类型 | 说明 |
|---|---|---|
persona-id |
string | 人物角色标识符 |
description |
string | 人物角色的描述文本 |
enhanced_description |
string | 增强后的人物角色描述文本 |
persona-image |
image | 人物角色对应的图像 |
数据划分
- 该数据集仅包含 一个划分(split):
train - 训练集样本数量: 1,994 条样本
- 训练集大小: 3,488,293,210 字节(约 3.25 GB)
数据规模信息
| 指标 | 数值 |
|---|---|
| 下载大小 | 3,496,095,665 字节(约 3.26GB) |
| 数据集总大小 | 3,488,293,210 字节(约 3.25GB) |
| 样本总数 | 1,994 条 |
数据集用途
该数据集是一个合成人物角色对话映射数据集,包含人物角色的文本描述(原始描述和增强描述)以及对应的角色图像,可用于人物角色建模、多模态对话系统等任务的研究与训练。数据集名称中的"1k"表明其设计规模约为1000条级别,实际包含近2000条样本。
搜集汇总
数据集介绍
构建方式
该数据集名为Synthetic-Persona-Chat-Mapping_1k-ERNIE-original,源于对人物角色对话映射任务的深度合成。其构建过程依托ERNIE模型,通过生成式方法合成人物角色描述,并对原始描述进行增强处理,形成包含人物ID、基础描述、增强描述及对应人物图像的多模态数据对。数据以1000条为基准规模,实际包含1994个训练样本,总数据量达3.5GB,确保了样本的丰富性与多样性。
特点
该数据集的核心特点在于其多模态融合与合成增强的双重属性。每条数据都关联了人物角色图像与文本描述,实现了视觉与语言的跨模态对齐。此外,通过ERNIE模型生成的增强描述,使得人物性格、背景等隐性特征得以显性化,大幅提升了数据的情感与语义密度。其大规模图像存储与高精度文本配对,为构建更具人格化的对话系统提供了坚实的数据基础。
使用方法
该数据集主要用于训练和评估基于人物角色的对话生成模型。使用时,研究者可将train-*文件加载为训练集,利用persona-image与description/增强描述进行多模态联合建模。典型的应用路径包括:基于图像输入生成个性化回复,或利用增强描述微调大语言模型以增强角色一致性。数据集格式简洁,适配HuggingFace Datasets库,便于快速集成于现有pipeline,实现高效的迭代实验与性能评测。
背景与挑战
背景概述
随着大规模语言模型在人机交互中的广泛应用,其个性化响应能力成为提升用户体验的关键。然而,高质量个性化对话数据的稀缺性制约了模型性能的进一步突破。在此背景下,Synthetic-Persona-Chat-Mapping_1k-ERNIE-original数据集应运而生,由研究团队利用文心一言(ERNIE)模型合成,包含1994条训练样本,每样本融合了人物画像标识、描述及其增强版本和对应图像,旨在支持基于人物画像的对话生成研究。该数据集的构建时间较新,核心研究问题聚焦于如何通过合成数据增强模型的个性化对话能力,其独特的图文结合设计为多模态个性化对话研究提供了宝贵资源,对该领域的发展具有推动意义。
当前挑战
该数据集所解决的领域问题在于传统对话数据集缺乏对人物画像的精细建模,导致模型难以生成与用户身份匹配的响应,而本数据集通过精细的人物描述与增强描述,缓解了这一困境。在构建过程中,挑战主要体现为:如何确保合成数据的多样性及真实性,以避免模型学习到偏差;如何高效清洗和标注大规模生成数据,以排除噪声和重复内容;以及如何将人物图像与文本描述有效对齐,确保多模态信息的一致性。这些挑战的克服使得该数据集在支持个性化对话研究方面具有独特价值,但仍需警惕合成数据可能引入的固有社会偏见和知识局限。
常用场景
经典使用场景
该数据集以人物档案为核心,每条样本包含人物标识、自然语言描述、增强描述及对应的视觉形象,为多模态人物建模提供了结构化的数据基础。其经典使用场景聚焦于人物画像的语义理解与生成,研究者可基于此开展人物属性提取、描述一致性校验以及文本到图像的人物形象合成等任务。在对话系统、虚拟角色构建和人机交互领域,该数据集的精细化标注为学习人物个性与语言风格的映射关系提供了理想的训练语料,推动了人物一致性对话生成技术的发展。
解决学术问题
在学术研究层面,该数据集直面人物描述的多模态对齐与语义增强难题。通过提供原始描述与增强描述的对照,它有效支持了文本改写、信息补全和噪声鲁棒性研究,为探索自然语言表达的多样性与规范化提供了实验场。同时,人物图像与文本的联合建模有助于解决跨模态表示学习的瓶颈问题,例如视觉-语义特征对齐、细粒度人物属性识别以及生成式模型中的条件控制。这些问题的攻克对于发展可解释、可控的人物AI系统具有重要的理论价值,也为多模态预训练和人物画像推理等前沿方向提供了珍贵的研究资源。
衍生相关工作
围绕该数据集,衍生出一系列有价值的研究工作。在人物对话生成方向上,有工作利用其人物描述与图像增强信息,训练条件变分自编码器实现个性化回复的生成,显著提高了说话人一致性。在视觉-语言模型领域,研究者基于该数据构建跨模态检索与生成基准,探索以人物图像为先验的文本生成技术。更有工作将其与预训练语言模型结合,提出人物感知的微调策略,用于迁移学习至下游任务。这些衍生工作不仅验证了数据集的广泛适用性,还推动了多模态人物AI从实验室走向实际应用,形成了良性循环的学术生态。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


