
McGill-NLP/crag-mm-diagnostics
收藏官方服务:
资源简介:
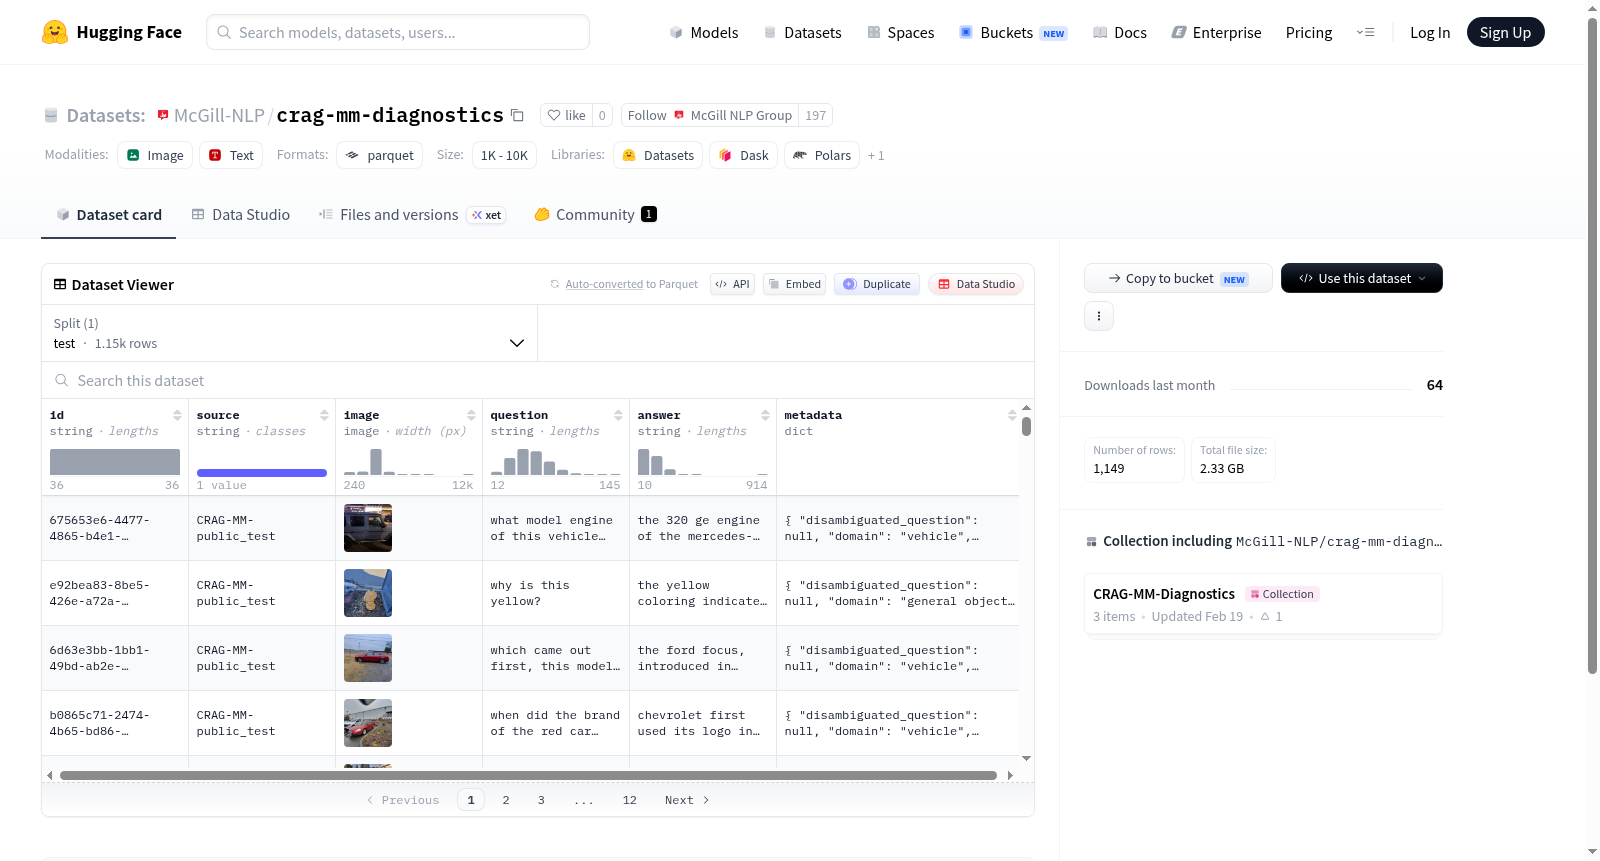
该数据集是一个视觉问答(VQA)数据集,包含图像、问题、答案对,以及丰富的元数据信息,如消歧问题、领域、动态性、图像质量、图像尺寸、对象数量、目标实体流行度、查询类别、指代表达类别、目标对象大小、目标对象名称、目标对象维基百科URL、目标ROI边界框、纯文本问题等。数据集仅包含测试集,共1149个样本。
This dataset is a Visual Question Answering (VQA) dataset containing image, question, and answer pairs, along with rich metadata such as disambiguated question, domain, dynamism, image quality, image size, number of objects, popularity of entity, query category, referring expression category, size of target object, target object name, target object Wikipedia URL, target ROI bounding box, and textual only question. The dataset only includes a test split with 1149 samples.
提供机构:
McGill-NLP搜集汇总
数据集介绍
构建方式
crag-mm-diagnostics数据集专为多模态检索增强生成(RAG)系统的诊断评估而构建,其设计植根于对多模态问答任务中复杂场景的深度剖析。该数据集包含1149个测试样本,每个样本以唯一标识符(id)进行索引,并整合了图像(image)、问题(question)与标准答案(answer)三大核心元素。在构建过程中,研究者精心采集了图像的元数据信息,涵盖消歧问题(disambiguated_question)、领域(domain)、动态性(dynamism)及图像质量(image_quality)等维度,尤其聚焦于目标对象的空间属性,如边界框(target_roi_bbox)、归一化距离中心点(normalized_distance_to_center)及目标对象尺寸(size_of_target_object),从而系统性地覆盖了多模态理解中的关键挑战点。
特点
该数据集最显著的特点在于其精细化的元数据标注体系,为诊断多模态RAG系统的性能瓶颈提供了结构化视角。每条样本均记录了查询类别(query_category)、指代表达类别(referring_expression_category)以及目标对象名称与维基百科链接,便于分析模型在不同语义粒度下的表现。此外,数据集中嵌入了关于实体流行度(popularity_of_entity)和目标对象数量(number_of_objects)的统计信息,使得研究者能够量化评估系统在应对视觉拥挤或罕见实体时的鲁棒性。图像尺寸(image_size)与纯文本问题(textual_only_question)的并存,进一步允许对视觉信息与语言信息在推理过程中的交互作用进行剥离分析。
使用方法
该数据集以Hugging Face Datasets库的标准格式发布,用户可通过加载‘test’分割直接使用,其中图像以PIL Image对象存储,便于集成至现有视觉-语言模型流水线。使用时,研究者应基于提供的id匹配样本,并以question字段作为模型输入,answer字段作为参考答案,评估生成文本的准确性;同时,可借助metadata中的消歧问题及边界框信息,构建细粒度的评测指标,例如针对目标定位能力或指代消解能力进行独立检验。由于数据集规模适中(1149例),其特别适合作为诊断基准,用于对比不同多模态RAG架构(如基于CLIP的检索器与大型语言模型的生成器组合)在特定错误模式下的表现差异。
背景与挑战
背景概述
在检索增强生成(Retrieval-Augmented Generation, RAG)领域,如何精准地融合视觉与语言信息以应对多模态查询,长久以来是制约模型性能提升的核心瓶颈。CRAG-MM-Diagnostics数据集应运而生,由业界前沿研究团队于近期构建,旨在系统性诊断多模态RAG系统在复杂查询下的短板。该数据集包含1149个精心设计的测试样本,每项样本皆配有图像、问题、答案及丰富的元数据,如查询类别、动态性、图像质量、目标对象属性等,从而为评估模型在细粒度场景下的鲁棒性与准确性提供标准化基准。其研究聚焦于揭秘视觉信息与文本查询之间的语义鸿沟,特别强调对多模态交互失败案例的剖析,极大推动了RAG模型从粗粒度检索向精细化解耦与推理的演进,成为该领域诊断性评估的重要基石。
当前挑战
当前多模态RAG系统面临的核心挑战在于,视觉输入与文本查询间的异构性往往导致检索结果偏差或逻辑谬误,例如模型难以应对指代表达式歧义、动态场景变化以及低质量图像中的隐晦信息。数据集的构建过程同样充满艰险,需要协同标注专家细致划定目标对象的边界框,并精确量化其尺寸、普及度及与图像中心的归一化距离,同时确保问题仅能通过视觉线索而非纯文本推测来解答,这对数据一致性提出了严苛要求。此外,跨领域动态更新(如时效性实体查询)的模拟,加之对图像质量与目标对象数量的多维度控制,进一步放大了数据平衡与领域泛化的挑战,亟需更高级的多模态对齐策略来化解这些结构性与语义性难题。
常用场景
经典使用场景
在检索增强生成(RAG)与多模态视觉语言模型的交叉研究领域,crag-mm-diagnostics数据集被广泛用于评估和诊断多模态RAG系统的表现。该数据集包含1149个精心构造的测试样本,每个样本涵盖图像、问题、答案及丰富的元数据,如查询类别、指代表达类型、目标对象属性等。研究者常利用该数据集对模型在多模态信息检索、视觉推理、跨模态对齐等核心能力上进行系统性评测,尤其关注模型在复杂场景下的鲁棒性与准确性,为构建更可靠的多模态问答系统提供了标准化测试基准。
解决学术问题
该数据集致力于解决多模态RAG系统中长期存在的评估碎片化与诊断盲区问题。传统评估往往仅关注最终答案的准确性,而忽略了检索过程、视觉理解深度、问题消岐能力等关键环节。通过提供细粒度元数据(如消岐后问题、目标对象边界框、图像质量等),crag-mm-diagnostics使研究者能够精准定位模型在哪些子任务上存在不足,从而推动对跨模态信息融合、动态知识检索、指代消解等学术难题的深入研究。其意义在于建立了一个可解释、可复现的评估框架,加速了多模态RAG从实验室走向实际应用的进程。
衍生相关工作
crag-mm-diagnostics数据集已催生了一系列富有影响力的后续研究。基于其细粒度元数据,有学者提出了可解释的多模态RAG诊断框架,通过分析模型在不同查询类别上的表现差异来优化检索策略。另一些工作则将其作为基准,发展出针对图像质量劣化或目标遮挡场景的鲁棒性增强方法。此外,该数据集也激发了关于指代表达消歧与动态知识更新之间交互作用的探讨,推动了将时间敏感信息融入多模态记忆网络的研究。这些衍生工作共同丰富了多模态知识检索领域的技术体系,使得crag-mm-diagnostics成为连接基础模型创新与应用验证的关键枢纽。
以上内容由遇见数据集搜集并总结生成


