visual-layer/oxford-iiit-pet-vl-enriched
收藏资源简介:
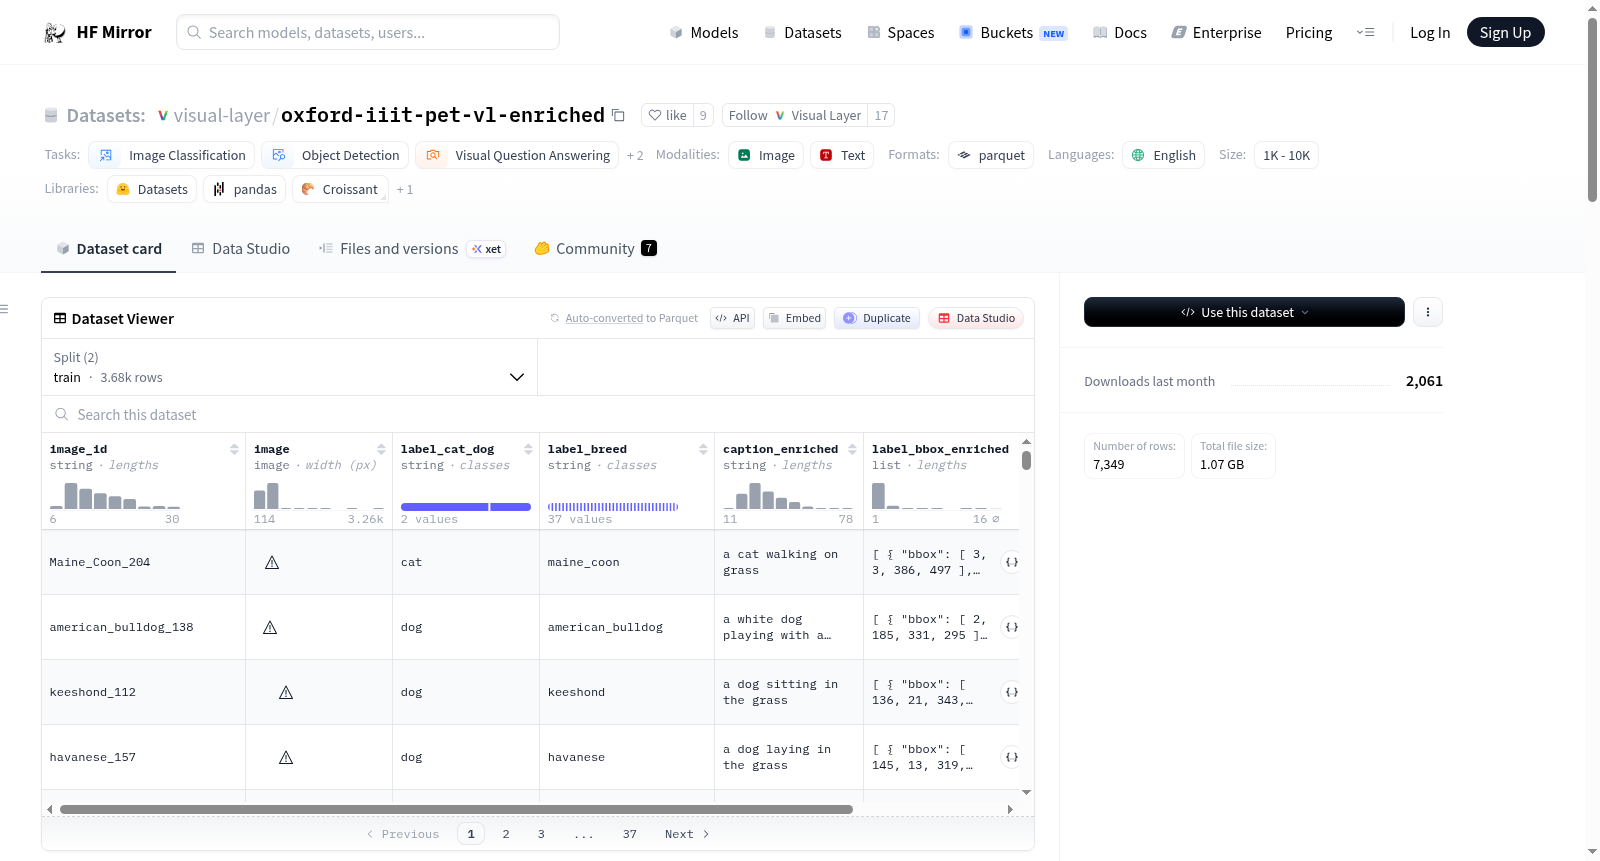
Oxford-IIIT-Pets-VL-Enriched数据集是Oxford IIIT Pets数据集的增强版本,包含了图像描述、边界框和标签问题等信息。数据集包含6列数据,分别是image_id(图像的唯一标识符)、image(图像数据)、label_cat_dog(图像标签,表示是猫还是狗)、label_breed(猫或狗的品种标签,包含37个品种)、label_bbox_enriched(增强的边界框标签,包含边界框坐标、置信度和标签)和caption_enriched(增强的图像描述)。此外,数据集还包含了图像质量问题的信息,如重复、错误标签、暗、模糊、亮和异常图像。该数据集可以用于图像分类、目标检测、图像检索和视觉问答等任务。
An enriched version of the Oxford IIIT Pets Dataset with image caption, bounding boxes, and label issues! With this additional information, the Oxford IIIT Pet dataset can be extended to various tasks such as image retrieval or visual question answering. The dataset consists of 6 columns: `image_id`, `image`, `label_cat_dog`, `label_breed`, `label_bbox_enriched`, `caption_enriched`, and `issues`. The dataset is split into train and test sets, containing 3680 and 3669 samples respectively.
Oxford-IIIT-Pets-VL-Enriched 数据集概述
数据集描述
- 语言: 英语 (en)
- 任务类别: 图像分类、目标检测
- 配置: 默认配置
- 数据文件:
- 训练集:
data/train-* - 测试集:
data/test-*
- 训练集:
- 数据文件:
数据集信息
-
特征:
image_id: 图像的唯一标识符,类型为字符串。image: 图像数据,类型为PIL图像。label_cat_dog: 图像标签,表示是猫还是狗,类型为字符串。label_breed: 图像标签,表示猫或狗的品种,包含37种猫和狗的品种,类型为字符串。caption_enriched: 图像的丰富描述,类型为字符串。label_bbox_enriched: 图像的丰富标签,包含边界框坐标、置信度和标签,类型为列表。bbox: 边界框坐标,类型为整数序列。label: 边界框标签,类型为字符串。
issues: 图像的质量问题,类型为列表。confidence: 置信度,类型为浮点数。description: 描述,类型为空。issue_type: 问题类型,类型为字符串。
-
数据集分割:
- 训练集:
- 字节数: 148786604.0
- 样本数: 3680
- 测试集:
- 字节数: 133006684.375
- 样本数: 3669
- 训练集:
-
数据集大小:
- 下载大小: 281256366 字节
- 数据集总大小: 281793288.375 字节