koskari
收藏资源简介:
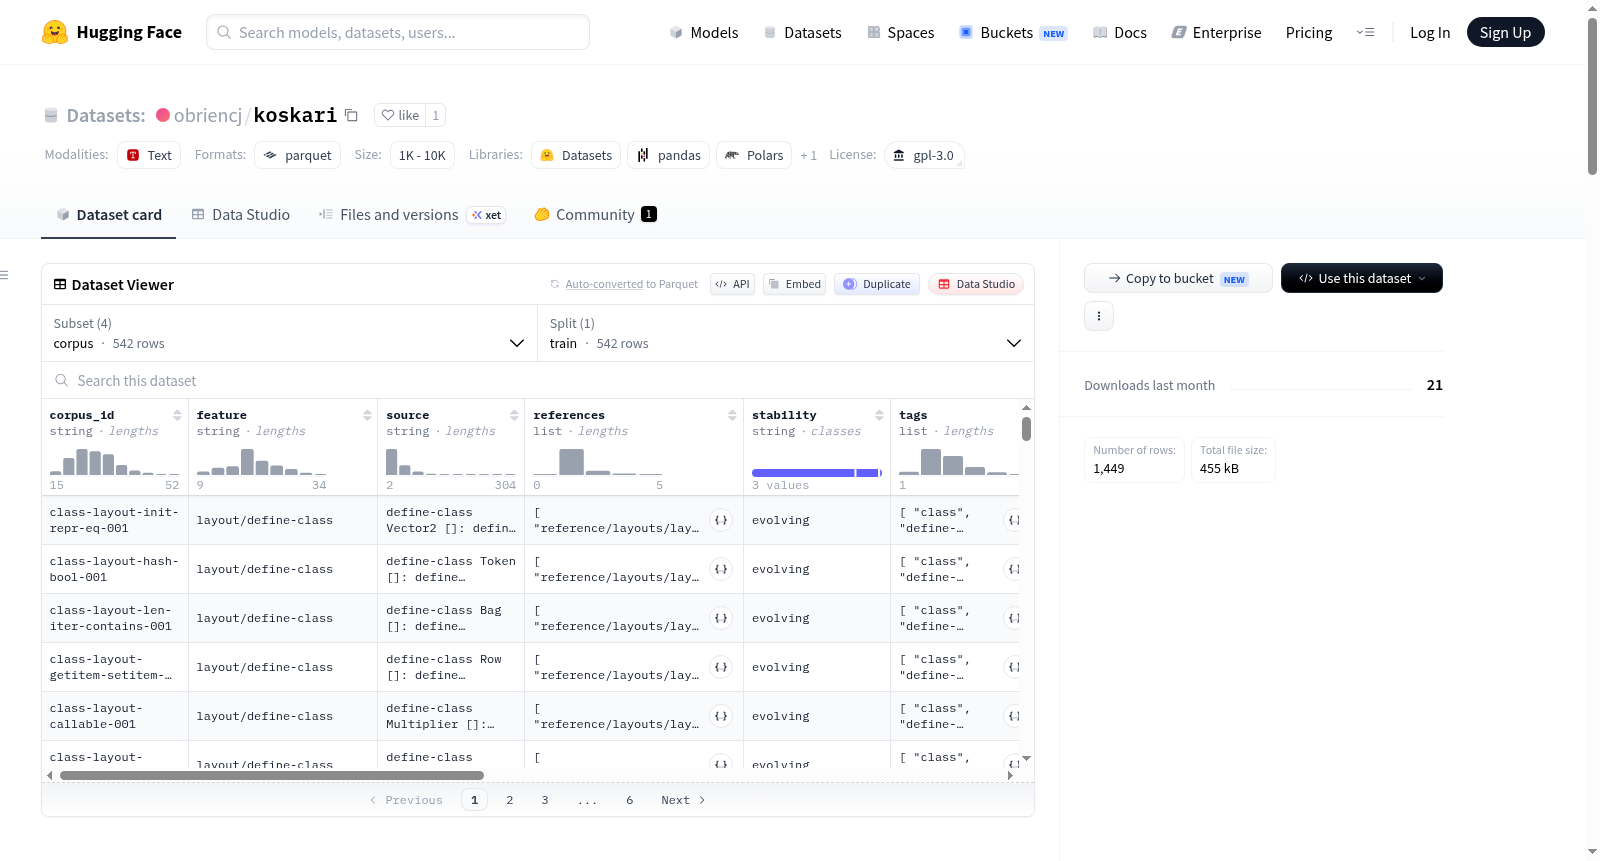
Koskari语言语料库是一个从Koskari一致性语料库导出的已验证Koskari语言示例集合,旨在为Koskari编程语言提供机器检查的行为期望,覆盖多个语言处理阶段,包括读取(reader和布局输出)、扩展(宏扩展)、求值(运行时结果)、错误(预期管道失败)和无效(文档化的非法源代码)。数据集包含四个独立配置:1) 语料库配置(默认):包含所有语料库记录,每行对应一个记录,字段包括唯一标识符、特征路径、源代码、各验证阶段的期望输出、文档引用、稳定性标签、维护者标签、模式版本和Git引用;2) 求值配置:包含具有已验证verify.eval期望的记录子集,以扁平化的源代码到求值结果行形式呈现;3) 文档配置:包含源仓库docs/目录中的用户文档页面(Markdown格式);4) 程序配置:包含源仓库examples/目录中的示例Koskari程序(完整的.ki文件及其README)。每个数据行都包含溯源信息,确保可追踪性。数据集适用于编程语言研究、编译器测试、代码生成、语言模型微调等任务,特别适用于需要验证语言行为一致性的场景。
The Koskari Language Corpus is a collection of verified examples of the Koskari language, derived from the Koskari conformance corpus, designed to provide machine-checked behavioral expectations for the Koskari programming language. It covers multiple language processing stages, including reading (reader and layout output), expansion (macro expansion), evaluation (runtime results), errors (expected pipeline failures), and invalid (documented illegal source code). The dataset consists of four independent configurations: 1) Corpus configuration (default): contains all corpus records, each line corresponding to a record, with fields such as unique identifier (corpus_id), feature path, source code, expected outputs for each verification stage (read, expand, eval, error, invalid), references, stability tags, maintainer tags, schema version, and git ref; 2) Evaluation configuration: includes a subset of records with verified verify.eval expectations, presented as flattened source-to-evaluation result lines; 3) Documentation configuration: includes user documentation pages (in Markdown format) from the source repositorys docs/ directory; 4) Program configuration: includes example Koskari programs (complete .ki files and their README) from the source repositorys examples/ directory. Each data row includes provenance information (corpus_id, schema_version, git_ref) for traceability. The dataset is suitable for tasks such as programming language research, compiler testing, code generation, and language model fine-tuning, particularly in scenarios requiring verification of language behavior consistency.
数据集概述:Koskari language corpus
该数据集是从 Koskari conformance corpus 导出的经过验证的 Koskari 语言示例,其数据基于机器检查的语言阶段(读取、展开、评估、错误、无效)提供了可追溯的语料记录。
许可证
- GNU General Public License v3 (GPL-3.0)
源代码仓库
数据集配置
数据集包含四个配置(config),默认配置为 corpus:
1. corpus(默认)
包含每一条语料记录,无论其包含哪些验证阶段,缺失的阶段以 null 表示。
| 列名 | 描述 |
|---|---|
corpus_id |
唯一语料记录标识符 |
feature |
特征路径(例如 special/compile/cond, layout/if) |
source |
Koskari 源文本 |
read |
verify.read 的预期读者输出 |
expand |
verify.expand 的预期宏展开 |
eval |
verify.eval 的预期评估结果 |
error |
verify.error 的预期流水线错误 |
invalid |
verify.invalid 的无效来源说明(文本解释) |
references |
指向 docs/ 下用户文档页面的链接 |
stability |
记录稳定性标签(stable, evolving, experimental) |
tags |
维护者标签(不包含仅训练用的元数据) |
schema_version |
导出时的语料库模式标识符 |
git_ref |
导出时的短 Git 提交哈希 |
2. eval
仅包含经过验证的 verify.eval 评估预期的记录子集,用于补全风格的使用,每行包含源文本到评估结果的映射。
| 列名 | 描述 |
|---|---|
corpus_id |
唯一语料记录标识符 |
feature |
特征路径 |
source |
Koskari 源文本 |
eval |
预期评估结果 |
schema_version |
导出时的语料库模式标识符 |
git_ref |
导出时的短 Git 提交哈希 |
3. docs
来自源代码仓库 docs/reference/ 和 docs/start/ 目录的用户文档页面(Markdown 格式)。每行对应一个页面,其 path 列与 corpus 配置中的 references 列完全匹配。
| 列名 | 描述 |
|---|---|
path |
文档相对路径(如 reference/specials/compile-define.md) |
title |
页面标题(第一个 Markdown 标题) |
summary |
首段纯文本摘要 |
content |
页面的完整原始 Markdown 内容 |
section |
父目录(如 reference/specials) |
kind |
固定为 doc |
schema_version |
导出时的语料库模式标识符 |
git_ref |
导出时的短 Git 提交哈希 |
4. programs
来自源代码仓库 examples/ 目录的 Koskari 示例程序(完整的 .ki 文件及 README),提供组合级别的上下文(完整程序而非单一构造片段)。这些行仅为示例,未经验证,不携带机器检查的阶段预期。
| 列名 | 描述 |
|---|---|
path |
仓库相对文件路径(如 examples/life/koslife/life.ki) |
title |
文件名主干或 README 标题 |
summary |
模块文档字符串或首行注释(纯文本) |
content |
文件的完整原始源代码 |
section |
顶级示例组(如 examples/life) |
kind |
固定为 example |
schema_version |
导出时的语料库模式标识符 |
git_ref |
导出时的短 Git 提交哈希 |
验证阶段
每条语料记录在语言边界断言行为:
- read:读者和布局输出
- expand:外层形式的宏展开
- eval:运行时结果(包括源代码中
@标记的复杂编码) - error:预期流水线失败
- invalid:记录的非法的源代码(可能与 read 预期共存)
只有源语料记录中存在的阶段会在 corpus 配置中以非 null 列形式出现。
溯源信息
每一行都包含 corpus_id、schema_version 和 git_ref,便于下游用户关联到权威的 YAML 记录和导出版本。