
遇见数据集

Viorra-Reasoning-Baseline

收藏
Hugging Face2026-07-23 更新2026-07-24 收录
官方服务:

资源简介:

Viorra Reasoning Baseline是一个用于文本生成任务的数据集,专门设计用于Viorra项目的第一阶段微调。该数据集的核心内容是从Claude Sonnet和Claude Opus模型生成的输出中,经过筛选后得到的、以人文学科为主题的推理轨迹(reasoning traces)。其主要目的是为Gemma 4 E2B模型提供训练数据,以增强其在第一阶段的人格稳定性(Persona Stability)。数据集规模为13,117条样本,以JSONL聊天格式组织。数据语言为英语,采用Apache-2.0开源许可证。

Viorra Reasoning Baseline is a dataset for text generation tasks, specifically designed for the first-stage fine-tuning of the Viorra project. Its core content consists of reasoning traces on humanities topics, which are filtered from outputs generated by Claude Sonnet and Claude Opus models. The primary goal is to provide training data for the Gemma 4 E2B model to enhance its Persona Stability in the first stage. The dataset contains 13,117 samples, organized in JSONL chat format. The data language is English, and it is released under the Apache-2.0 open-source license.

创建时间:
2026-07-14
原始信息汇总

数据集概述:Viorra Reasoning Baseline

该数据集主要用于 Viorra 项目第一阶段微调,专注于人文领域的推理轨迹。

  • 语言: 英语 (en)
  • 许可协议: Apache-2.0
  • 规模: 包含 13,117 行数据 (10K < n < 100K)
  • 数据格式: JSONL Chat 格式
  • 任务类别: 文本生成 (text-generation)
  • 标签: gemma, viorra, reasoning
  • 数据来源: 经过筛选的 Claude Sonnet/Opus 生成的人文领域推理轨迹 (humanities-focused reasoning traces)
  • 主要用途: 用于 Gemma 4 E2B 模型的第一阶段人格稳定性微调 (Stage 1 Persona Stability)
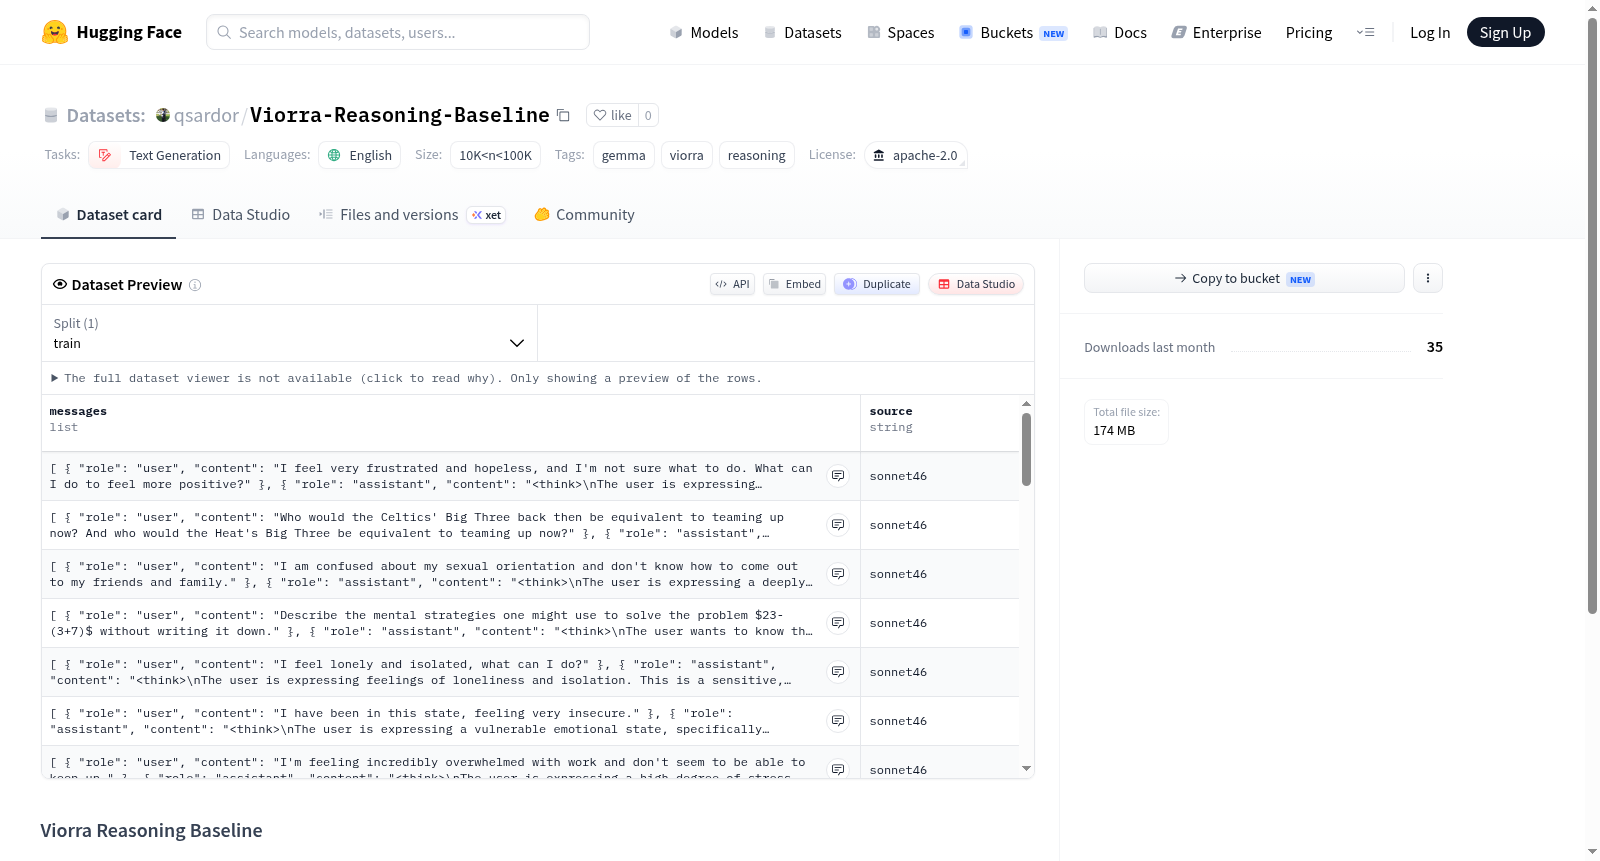
搜集汇总
数据集介绍
Viorra-Reasoning-Baseline 数据集图片
构建方式
该数据集源自Viorra项目第一阶段微调过程中的关键数据筛选工作,聚焦于人文领域的推理轨迹。构建过程中,研究团队利用Claude Sonnet与Claude Opus模型生成高质量推理内容,并经过精细过滤与整理,最终形成包含13,117条记录的标准化数据集。数据以JSONL对话格式存储,每条记录均保持结构化的聊天形式,便于后续模型的微调与评估。
特点
数据集的显著特色在于其专注于人文领域的推理任务,所包含的推理轨迹由先进的语言模型Claude系列生成,兼具多样性与深度。数据规模适中,约1.3万条记录,既保证了足够的样本量以驱动模型学习,又避免了冗余噪声。此外,数据集明确服务于Gemma 4 E2B模型的第一阶段人格稳定性微调,具有明确的领域针对性与应用导向。
使用方法
该数据集适用于大语言模型在人文推理能力上的监督微调。使用时可直接加载JSONL格式文件,按照标准的对话式指令-响应对结构进行解析。推荐将数据划分为训练集与验证集,并结合Gemma 4 E2B或其他基础模型开展微调实验。数据集的标签与格式清晰,便于集成至主流训练框架如Transformers或TRL库中执行指令微调任务。
背景与挑战
背景概述
在大语言模型微调领域,推理能力与人格稳定性的平衡始终是研究难点。Viorra-Reasoning-Baseline数据集由Viorra团队于2024年创建,聚焦于Gemma 4 E2B模型的第一阶段微调,旨在通过人文社科领域的推理轨迹增强模型的人格稳定性。该数据集包含13,117条来自Claude Sonnet/Opus的高质量推理样本,以JSONL聊天格式呈现,专门针对文本生成任务设计。作为Viorra系列研究的基础组件,它对探索大模型在保持推理连贯性的同时实现个性化对齐具有重要影响,为人机交互中更自然、稳定的人格表达提供了数据支撑。
当前挑战
该数据集面临的核心挑战在于多维度平衡。领域层面,需要解决大语言模型在开放式推理任务中人格漂移的问题,确保输出既具备逻辑严谨性又维持一致的角色特征。构建过程中,挑战体现为高质量推理轨迹的获取成本高昂,需依赖Claude Sonnet/Opus等顶级模型生成,且需严格过滤噪音数据以保持纯人文推理的聚焦性。此外,13,117样本量相对于复杂推理空间可能不足,如何在有限数据上实现人格稳定性与推理泛化能力的协同优化,是模型微调阶段必须攻克的瓶颈。
常用场景
经典使用场景
在自然语言处理与推理能力增强的交叉领域中,Viorra-Reasoning-Baseline数据集被广泛用于大型语言模型的微调训练。该数据集包含13,117条经过精心筛选的人文领域推理轨迹,这些轨迹源自Claude Sonnet/Opus模型的高质量输出,采用JSONL聊天格式组织。研究者常将其作为第一阶段的微调基石,旨在通过注入稳定的人格特征与严谨的推理逻辑,提升模型在复杂人文语境下的连贯思考能力。这一应用场景特别适用于需要长期记忆与角色一致性维持的对话系统,为后续的多阶段训练奠定了基础。
实际应用
在产业实践中,该数据集被应用于构建具有连贯人格的智能客服与教育辅导系统。例如,在历史人物对话应用中,模型需要持续保持特定角色的观点一致性,Viorra-Reasoning-Baseline帮助模型在数轮交互中维持稳定的推理风格。此外,它还被用于学术写作辅助工具,确保生成的论证段落逻辑自洽且符合人文领域的表达习惯。在内容创作领域,基于该数据集微调的模型能够模拟特定文学流派的思辨方式,为剧作者提供具有内在合理性的情节推演方案,显著提升了人机协作的创作质量。
衍生相关工作
围绕Viorra-Reasoning-Baseline数据集,衍生出多项具有影响力的研究工作。其中,Viorra微调方案(Viorra Fine-Tuning)成为多阶段训练范式的代表,被后续的个性化语言模型项目广泛引用。研究者基于该数据集开发了人格评估基准(Persona Evaluation Benchmark),用于量化模型角色忠实度。此外,将推理轨迹与强化学习相结合的进阶工作,催生了多轮对话中的逻辑一致性奖励模型,进一步优化了输出质量。这些衍生工作共同构建了从数据到评测再到优化的完整闭环,为人文领域智能体的研究提供了系统性的技术栈。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务


