
遇见数据集

Mikimi/phoible-voxangeles-formants-aggregated-audio

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

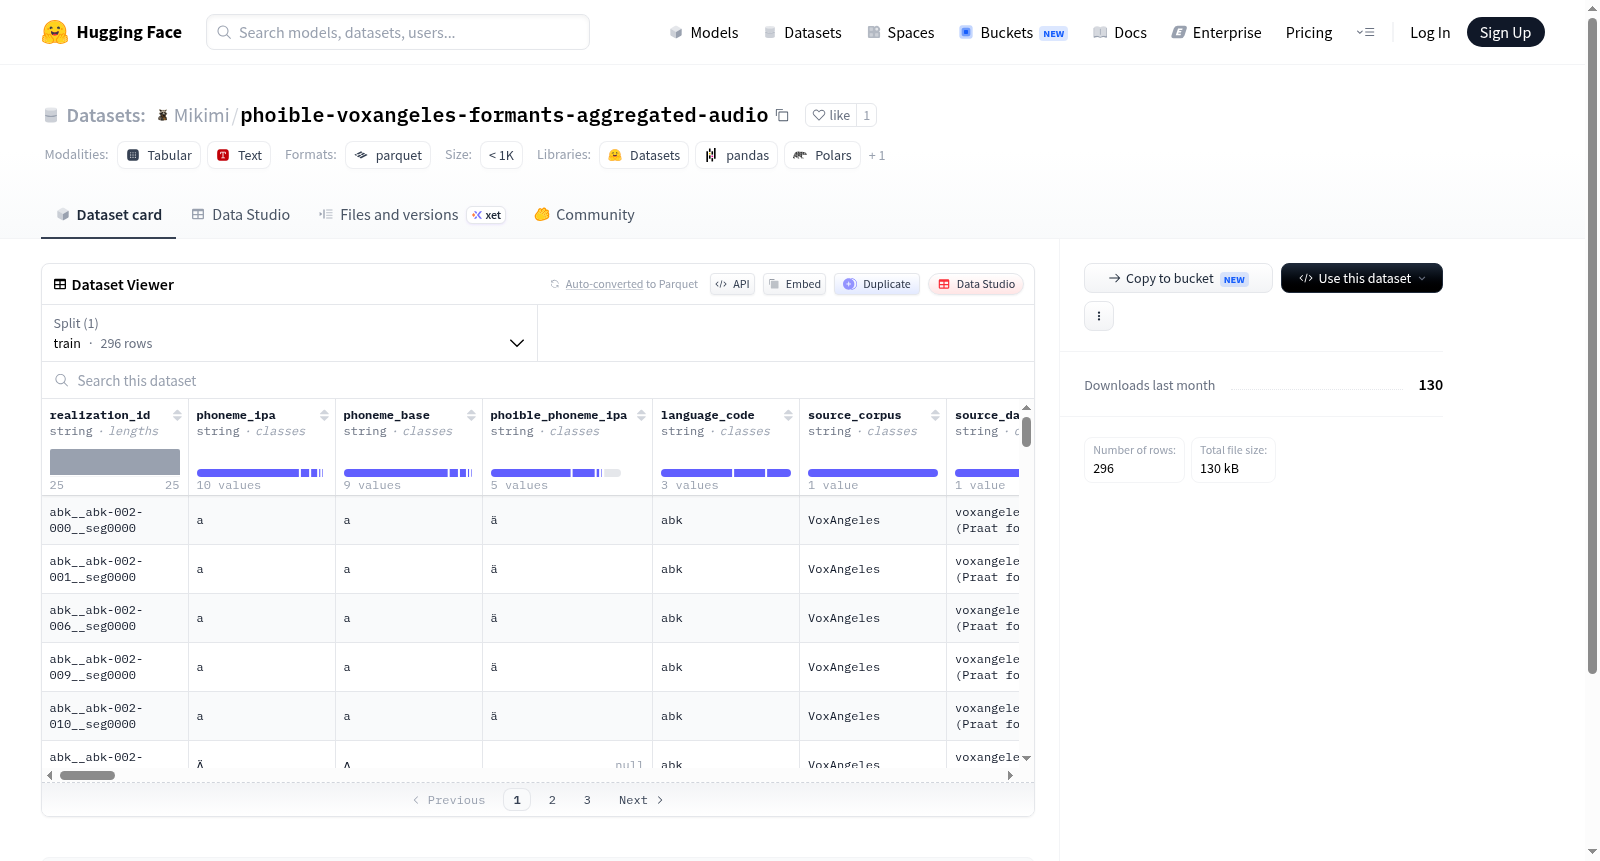
这是一个语音声学特征数据集,包含多种语言的音素发音数据。数据集提供了详细的声学测量值,包括基频(F0)和共振峰(F1-F5)的多种统计特征(如四分位数、分位数)、音素持续时间、发音位置特征等。同时包含语言元数据(如语言代码、语系、地理坐标)和音系特征(如鼻音性、边音性、舌位特征等)。数据来源于多个语音语料库和数据集,每个样本对应一个音素实例的声学实现。

This is a speech acoustic feature dataset containing phoneme pronunciation data from multiple languages. The dataset provides detailed acoustic measurements including various statistical features of fundamental frequency (F0) and formants (F1-F5) (such as quartiles, deciles), phoneme duration, articulatory features, etc. It also includes language metadata (such as language code, language family, geographic coordinates) and phonological features (such as nasality, laterality, tongue position features, etc.). The data originates from multiple speech corpora and datasets, with each sample corresponding to an acoustic realization of a phoneme instance.
提供机构:
Mikimi
搜集汇总
数据集介绍
Mikimi/phoible-voxangeles-formants-aggregated-audio 数据集图片
构建方式
该数据集通过整合PHOIBLE音位清单数据库与VoxAngeles音频语料库构建而成。具体流程包括:从VoxAngeles语料库中提取已标注的语音片段,提取其共振峰(F1至F5)、基频(F0)等声学特征,并对其进行Lobanov和Nearey两种归一化处理。随后,将这些语音片段与PHOIBLE数据库中的音位清单进行匹配,为每个音段关联其音位特征标签,如声调、重音、发音部位及方式等。最终汇集为包含296条训练样本的聚合数据集,每条记录均携带丰富的音位学与声学双重标注信息。
特点
该数据集的核心特色在于其跨语言音位与声学特征的深度融合。每条数据不仅包含原始共振峰频率、基频及其四分位统计量,还提供了经归一化处理后的Lobanov和Nearey共振峰参数,便于跨说话人和跨语言比较。此外,数据集引入了发音能量代理指标(effort_proxy)及共振峰距离度量,为语音产出机制研究提供了新颖视角。同时,基于PHOIBLE音位特征系统,每个音段被赋予多达数十项发音特征标注,覆盖从音节性到发声类型的全面音位描述,使得该数据集特别适用于语音学理论验证与计算建模。
使用方法
使用该数据集时,研究者可通过HuggingFace Datasets库直接加载,指定'phoible-voxangeles-formants-aggregated-audio'名称并选择默认配置。数据以表格形式呈现,每行代表一个音位实现,包含所有声学、音位及元数据字段。适合用于构建语音分类模型、音位识别系统或进行跨语言声学空间分析。用户可依据语言代码、音位类别或音位特征进行子集筛选,亦可直接利用归一化后的共振峰数据进行音位聚类或对比研究。此外,数据集中的发音特征字段便于直接作为多标签分类任务的训练目标。
背景与挑战
背景概述
该数据集由跨语言语音学研究团队构建,旨在整合PHOIBLE音系数据库与VoxAngeles声学语料库,形成音段与共振峰特征的关联资源。其核心研究问题在于探索语言音系系统与声学实现之间的映射关系,为语音产出理论提供实证基础。数据集汇集了来自多种语系的音素实例,每个音段均标注了基频、前五共振峰及Lobanov、Nearey归一化值,并附有音系特征编码。这一资源对语音类型学、二语习得及计算语音学领域具有重要推动作用,尤其为探究音系规则在不同语言中的声学表现差异提供了标准化参照。
当前挑战
数据集面临的挑战主要源于跨语言声学数据的不均衡性与标注复杂性。首先,不同语言区段在各语系中的分布极不均匀,少数语言(如英语)的样本占据主导,而大量濒危或研究不足语言的声学数据匮乏,导致模型存在偏差。其次,共振峰提取受录音条件、说话人差异及文体影响,归一化方法(如Lobanov与Nearey)虽缓解了部分问题,但未能完全消除声域与音位变体的混淆。此外,音段切分边界在语流中难以精确界定,尤其是协同发音和弱化现象可能引入测量误差。最后,PHOIBLE音系特征描述的离散性与声学连续谱之间的粒度不匹配,为音系-声学映射模型的构建带来本征困难。
常用场景
经典使用场景
在语音学与计算语言学的交叉领域中,phoible-voxangeles-formants-aggregated-audio数据集凭借其精细的共振峰与基频特征,成为解析人类语音产出机制的重要资源。经典使用场景聚焦于跨语言音位系统的声学特征对比研究,研究者可借此分析不同语言中元音与辅音的共振峰模式,揭示发音器官运动与声学输出之间的普适性规律。该数据集尤为适合训练机器学习模型,用于自动识别语音中的音段类别,或探索基频分布与韵律特征之间的内在关联,为大规模语音数据的量化分析提供了坚实基底。
解决学术问题
该数据集有效解决了语音学领域中长期存在的跨语言声学数据稀缺且标准不一的问题。通过整合来自不同语系的音位发音实例,并归一化共振峰与基频参数,它为探究语音普遍性与语言特异性提供了可比对的基础数据。学术研究中,它可助力检验发音的生理约束假说,例如通过Lobanov与Nearey归一化方法消除发音人个体差异,从而揭示舌位高低与声道形状的普遍模式;同时,它支持对清浊对立、送气与否等音位特征的声学辨别研究,深化了对人类语音范畴化感知机制的理论理解。
衍生相关工作
围绕该数据集衍生出一系列富有影响力的研究工作。在语音学层面,研究者基于其格式塔特征训练了音素分类模型,验证了跨语言音位清单预测的可能性。在计算语言学界,该数据集被用作评估无监督语音表征学习效果的基准,推动了自监督模型对时序声学特征抽象能力的进步。尤为值得一提的是,部分工作将数据集中的基频分位数特征与情感语音合成相结合,开创了从静态音位到动态韵律建模的新范式,进而催生了探索语音风格迁移的系列实验,极大拓展了数据驱动语音研究的边界。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

