
遇见数据集

okashurin/ToolHal-v1

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

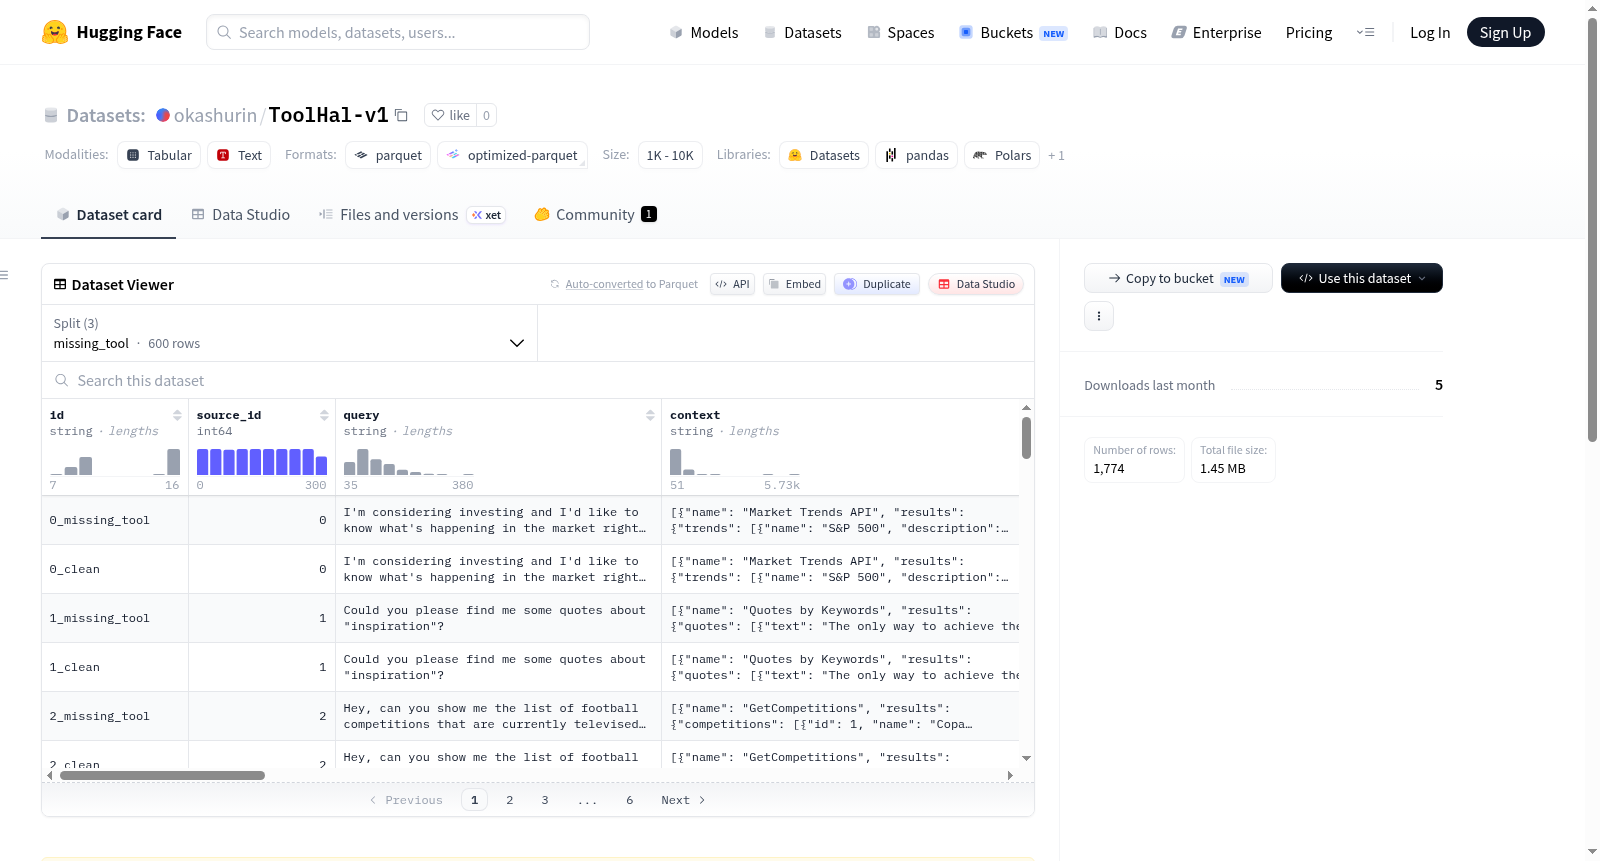
该数据集是原始ToolAce数据集的增强版本,专门用于工具调用任务中的幻觉检测。它通过注入三种幻觉类型来扩展原始数据:1. 模型响应与工具输出之间的冲突(tool_output_conflict子集),即模型响应与工具实际输出不一致;2. 过度生成(overgeneration子集),即模型响应包含工具输出中未出现的信息;3. 缺失工具(missing_tool子集),即模型响应建议调用不可用工具的操作。数据集包含多个特征字段,如查询、上下文、工具调用、输出等,并分为三个子集,总计约1774个示例,旨在帮助检测和评估模型在工具调用中的幻觉问题。

The repository contains augmentations of the ToolAce dataset for Hallucination Detection in the Tool Calling task. The original ToolAce dataset was injected with 3 types of hallucinations: 1. Hallucination between the models response and the tools output (tool_output_conflict split); 2. Overgeneration, when the response contains information not present in the tools output (overgeneration split); 3. Missing tool, when the response recommends actions requiring calling a tool that is not available (missing_tool split). The dataset includes features such as query, context, tools, tool_call, output, and hallucination labels, with splits for each hallucination type totaling approximately 1774 examples, designed to detect and evaluate hallucinations in model tool calls.
提供机构:
okashurin
搜集汇总
数据集介绍
okashurin/ToolHal-v1 数据集图片
构建方式
ToolHal-v1数据集的构建基于对ToolAce这一工具调用数据集的深度增强,旨在系统性地注入三类幻觉模式以模拟工具调用场景中的错误生成。具体而言,通过精心设计的策略,在原始样本中引入模型响应与工具输出之间的冲突、响应中生成超出工具输出范围的额外信息,以及推荐调用不可用工具等幻觉类型。数据集划分为三个独立子集,分别对应上述三种幻觉模式,共计1774个样本,每个样本均包含丰富的元数据字段,如幻觉类型、标签处理版本、注入策略及生成模型信息,确保了数据集的科学严谨性与可复现性。
特点
ToolHal-v1数据集的核心特点在于其精细的标注体系与多维度的元数据结构,涵盖幻觉类型的细粒度分类(如冲突、过度生成与缺失工具)以及对应的子类型,为研究者提供了深入剖析幻觉产生的机制与模式的依据。每个样本附加了温度参数、生成模型标识与注入策略等背景信息,便于分析不同条件对幻觉触发的影响。此外,数据集的标注质量经由自动化处理与人工校验双重保障,确保了标签的准确性与一致性,使其成为评估与训练工具调用幻觉检测模型的理想基准。
使用方法
使用ToolHal-v1数据集时,研究者可直接加载HuggingFace上的预划分数据,分别针对三个子集进行模型训练或评测。建议根据任务需求选择合适的特征列作为输入(如query、context、tools),并利用hallucination_labels及其处理版本作为监督信号。该数据集适用于监督学习、零样本检测及模型鲁棒性测试等场景,亦可用于开发多任务学习框架,同时优化幻觉识别与工具选择能力。研究者可灵活组合不同子集进行交叉验证,以全面评估模型在各类幻觉场景下的表现,并依据generation_metadata中的详细信息进行细致的误差分析。
背景与挑战
背景概述
ToolHal-v1数据集于2024年问世,由学术界与工业界联合团队在ToolAce基础之上构建,旨在攻克大语言模型在工具调用场景中的幻觉检测难题。该数据集通过系统化注入三类典型幻觉——工具输出冲突、过度生成与缺失工具调用,为评估模型对工具调用结果的忠实性提供了基准。其诞生源于工具增强型语言模型在真实应用中因幻觉引发的可靠性危机,研究团队聚焦于如何量化与识别这些细微而致命的错误。自发布以来,ToolHal-v1凭借精细的标签体系和多样的生成策略,迅速成为工具调用幻觉检测领域的重要参照,推动了相关评估标准与方法论的演进,对提升智能体系统的可信度具有深远影响。
当前挑战
数据集构建与研究所面临的挑战多维且深刻。在领域问题层面,核心难题在于工具调用幻觉的隐蔽性与复杂性——模型可能生成与工具输出相悖的回应,或虚构未调用工具的结果,甚至遗漏必要工具调用,这些错误在语义上难以界定,给自动检测带来严峻考验。构建过程中,团队需设计可控的幻觉注入策略,确保样本既真实反映模型缺陷,又避免人为痕迹过度,同时兼顾三种幻觉类型的均衡分布与覆盖度。此外,幻觉细粒度的标注需依赖专家知识,成本高昂且易产生歧义,而不同生成模型与温度参数下的多样性也增加了标签一致性的维护难度,这些要素共同构成了ToolHal-v1在推动幻觉检测研究前行时必须跨越的障碍。
常用场景
经典使用场景
ToolHal-v1数据集作为工具调用中幻觉检测领域的开创性资源,其经典使用场景聚焦于评估和提升大型语言模型在工具交互过程中的可靠性。该数据集基于ToolAce精心构建,通过注入三种类型的幻觉(工具输出冲突、过生成及缺失工具)形成多维度测试基准,适用于模型输出的事实一致性验证、工具调用决策合理性分析以及生成内容完整性评估。研究者可借助其精细的标签体系(如幻觉类型、子类型、注入策略)开展细粒度错误剖析,从而推动模型对工具输出真值尊重度的量化研究。
解决学术问题
该数据集直面大语言模型在工具调用中幻觉频发的学术痛点,系统性地解决了三大关键问题:响应与工具输出间的语义对齐(tool_output_conflict)、生成内容的信息过剩(overgeneration)以及工具调用缺失导致的行动不完备(missing_tool)。通过提供标准化的幻觉标注基准,ToolHal-v1使得研究者能够定量评估模型在不同幻觉维度下的表现缺陷,有效支撑了工具增强型语言模型的鲁棒性研究,并为幻觉检测算法的精度与泛化能力提供了可复现的评估平台。
衍生相关工作
ToolHal-v1的出现催生了多项相关学术工作,其设计思想影响了后续幻觉检测与缓解研究。围绕该数据集,研究者探索了基于对比学习的幻觉判别模型、基于置信度的不确定性量化方法以及针对不同幻觉类型的后处理校正策略。此外,该数据集的子集划分方式启发了多任务学习框架,用于同时处理工具输出冲突与过度生成问题,推动了工具调用领域评测基准的标准化进程。相关成果已在自然语言处理顶级会议中涌现,形成了良性研究生态。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

