
vanderbilt-dsi/narrative-arc
收藏官方服务:
资源简介:
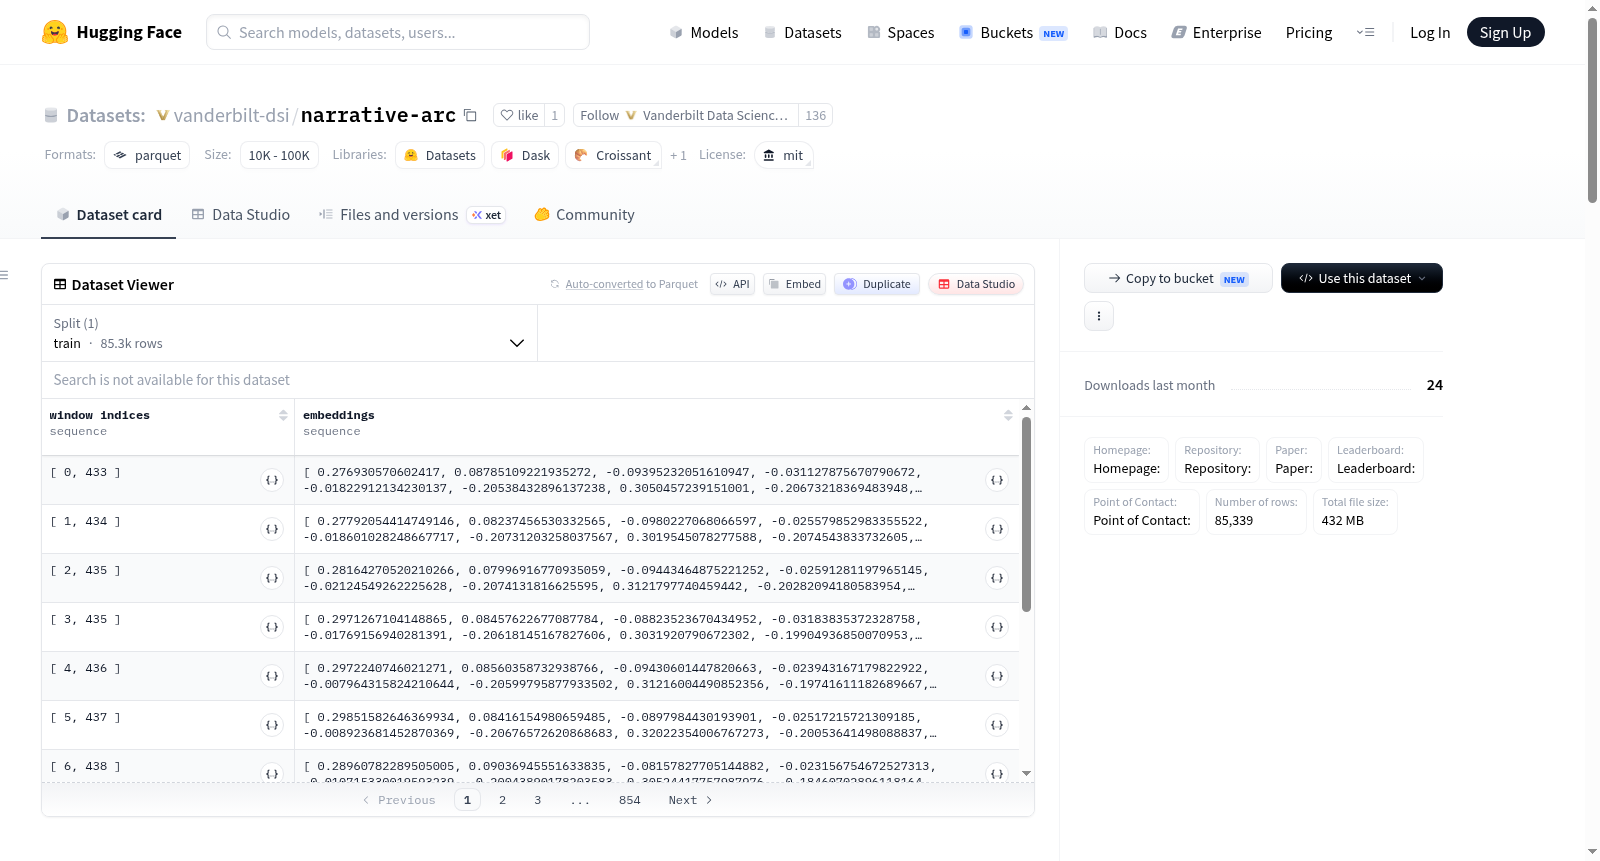
narrative-arc数据集用于叙事弧后处理,包含故事的原始文本及其元数据、用于生成嵌入的转换模型、模型的检查点、存储嵌入的窗口索引以及嵌入本身。数据来源于Project Gutenberg图书馆,主要包含英语短故事。
The narrative-arc dataset is designed for narrative arc post-processing, which contains the raw text and metadata of stories, Transformer models used for embedding generation, model checkpoints, window indices for storing embeddings, and the embeddings themselves. The dataset is sourced from the Project Gutenberg library and primarily comprises English short stories.
提供机构:
vanderbilt-dsi原始信息汇总
数据集概述
数据集名称
- 名称: narrative-arc
数据集描述
- 描述: 该数据集包含用于叙事弧后处理的故事数据。每个故事实例包括原始文本及其元数据、用于生成嵌入的转换器模型、模型的检查点、存储嵌入的窗口索引以及嵌入本身。
数据集结构
- 数据实例: 每个故事数据实例包括书名、书本元数据、全文以及使用不同模型的嵌入信息。
- 数据字段: 示例数据字段包括书名、书本元数据、全文、模型信息(如distilbert-base-cased和distilbert-base-uncased的窗口索引和嵌入)。
数据集创建
- 来源数据: 数据来源于Project Gutenberg图书馆,主要包含英语短篇故事。
- 数据收集与标准化: 数据从Project Gutenberg收集并进行标准化处理。
- 语言生产者: 每个数据实例代表由人类作者撰写的文本。
许可证信息
- 许可证: MIT
语言
- 多语言性: 单语种(英语)
任务类别
- 任务类别: 文本分类
数据集创建理由
- 理由: 处理后的文本需要存储在既可访问又能容纳大量数据生成的环境中。
数据集使用考虑
- 个人和敏感信息: 不适用
- 其他已知限制: 需要更多信息
贡献者
- 贡献者: 感谢@github-username添加此数据集。
搜集汇总
数据集介绍
构建方式
在叙事文本的数字化研究中,如何高效存储与复用深度学习模型生成的嵌入表示成为关键挑战。narrative-arc数据集正是为解决此问题而构建,其原始文本源自古登堡计划(Project Gutenberg)图书馆中的英语短篇小说。构建过程中,研究团队首先采集了人类作者创作的完整故事文本及其元数据,随后采用DistilBERT系列模型(包括cased与uncased两种变体)对文本进行嵌入化处理。每个故事的嵌入结果以窗口索引的形式组织,并连同模型检查点信息一同存储,从而形成一个可供后续叙事弧线分析与后处理任务直接调用的结构化数据集合。
特点
该数据集的核心特色在于其针对叙事弧线后处理任务的专门化设计。每个数据实例不仅包含原始文本与书籍元数据,还完整保留了用于生成嵌入的Transformer模型信息、模型检查点版本以及嵌入向量对应的窗口索引。这种多层级的数据结构使得研究者能够精确追溯每一段嵌入的生成上下文,支持对叙事结构进行细粒度的时序分析。此外,数据集同时提供DistilBERT-base-cased与uncased两种模型的嵌入结果,便于对比不同分词策略对叙事弧线建模的影响,体现了其在计算叙事学方法论上的灵活性与包容性。
使用方法
使用该数据集时,研究者可直接通过HuggingFace Datasets库加载数据,每个样本以JSON格式提供。访问嵌入数据时,需首先指定所使用的模型名称(如distilbert-base-cased),再通过窗口索引定位特定文本片段的嵌入矩阵。这些嵌入可被直接用于训练下游的叙事弧线分类器,或作为特征输入到序列建模框架中。需要注意的是,由于数据量庞大,建议采用批处理方式加载,并利用窗口索引实现高效的内存管理。对于希望复现原始叙事弧线分析流程的团队,该数据集提供了从文本到嵌入的完整链路,显著降低了预处理阶段的工程成本。
背景与挑战
背景概述
叙事弧(Narrative Arc)作为文学与计算语言学交叉领域的重要概念,旨在量化故事中情感张力与情节发展的动态演变。由范德堡大学数据科学研究所(Vanderbilt DSI)创建于近年,该数据集聚焦于将经典叙事理论转化为可计算的嵌入表征。核心研究问题在于如何通过预训练语言模型(如DistilBERT)从原始文本中提取高维语义特征,以捕捉故事从冲突建立到高潮释放的典型轨迹。其影响力体现在为数字人文学科提供了标准化的叙事分析基准,尤其推动了情感计算与文本结构挖掘的融合。数据集依托古登堡计划(Project Gutenberg)的英文短篇小说资源,通过滑动窗口策略生成稠密向量,为后续叙事弧的聚类与模式识别奠定基础。
当前挑战
当前面临的核心挑战包括:1)叙事弧的领域问题在于现有文本分类任务多聚焦于主题或情感极性,而缺乏对叙事结构动态演变的建模能力,导致模型难以区分线性叙事与非传统叙事结构(如倒叙、多线程叙事)的弧线特征;2)构建过程中,从古登堡计划采集的文本存在年代跨度大、文体风格迥异的难题,不同作者的叙事节奏差异(如海明威的极简主义与狄更斯的繁复描写)可能引入嵌入空间的系统性偏差;3)窗口索引的固定长度设定与故事自然分节(章节、场景切换)之间存在错位,导致语义边界模糊;4)数据集的存储规模随文本长度呈指数增长,对嵌入向量的高效压缩与检索提出工程化挑战。
常用场景
经典使用场景
narrative-arc数据集为叙事弧线的计算分析与后处理研究提供了关键支撑。该数据集收录了来自古登堡计划的英文短篇小说,每条故事实例不仅包含原始文本及其元数据,还通过DistilBERT等预训练语言模型提取了对应的嵌入表示与窗口索引。这一结构化设计使得研究者能够基于文本的语义表征,追踪叙事弧线在时间维度上的动态演变,从而开展情感轨迹分析、情节结构建模以及故事高潮点识别等经典任务。数据集将原始文本与模型嵌入深度融合,为叙事理论的量化验证构筑了坚实的实验基础。
实际应用
narrative-arc数据集在实际应用中展现出广泛的价值。在数字人文领域,文学研究者可借助该数据集自动识别海量文本中的情感起伏与情节转折,辅助文学作品的结构分析与风格比较。在内容推荐系统方面,基于叙事弧线的嵌入特征可用于预测故事的用户喜好度,优化网络文学、影视剧本等内容的推荐效果。此外,教育科技领域可将其应用于写作辅助工具,通过实时监测叙事弧线的完整性来向学习者提供结构性反馈,提升故事创作的逻辑性与感染力。
衍生相关工作
narrative-arc数据集催生了一系列富有影响力的衍生工作。基于该数据集的嵌入表征,研究者开发了叙事弧线分类器,实现了对故事开端、上升、高潮、下降与结局等经典阶段的自动标注。后续工作进一步将叙事弧线建模与情感分析、角色网络分析相结合,构建了多模态叙事理解框架。此外,部分研究利用该数据集进行叙事弧线生成任务,探索可控文本生成中情节结构的规划与优化策略。这些衍生工作共同推动了叙事智能从浅层特征分析向深层语义理解的演进。
以上内容由遇见数据集搜集并总结生成


