mytts-en-data
收藏资源简介:
mytts-en-data是一个用于英文flow-matching文本到语音(TTS)模型训练的衍生数据集,属于dacvae-next项目(mytts)。该数据集由SynDataLab-EN/echo-clones-4m-en处理而来,原始数据包含约398万个由EchoTTS合成的语音片段,总计约11,150小时,覆盖4,000种合成声音。数据集不提供原始音频,而是提取并存储了每个片段的语义编解码器(DACVAE)后验均值潜变量(25帧每秒,128维,float16格式)、自监督学习教师模型(facebook/w2v-bert-2.0)第16层经PCA投影到128维的REPA目标、自动语音识别(ASR)转录和静音注释,以及指向原始数据源的清单文件。数据规模:当前包含83个ingest组,共32,019个文件,总大小102.6 GB。数据组织上,训练数据位于tts_en/目录,按来源(echo_en训练集和echo_en_heldout保留集)分类;评估数据位于eval/en/目录,涵盖echo保留语音、Seed-TTS测试集、LibriSpeech(含PC版本)、AMI等。此外还包含HuBERT-large教师检查点数据和备份信息。该数据集适用于训练基于潜变量的TTS模型,特别是需要高密度潜表示和监督目标的任务。许可证为Apache-2.0(源音频生成模型EchoTTS为CC BY-NC-SA 4.0)。
mytts-en-data is a derived dataset for English flow-matching text-to-speech (TTS) model training, part of the dacvae-next project (mytts). It is processed from SynDataLab-EN/echo-clones-4m-en, which originally contains approximately 3.98 million EchoTTS-synthesized speech segments (totaling about 11,150 hours over 4,000 synthetic voices). Instead of raw audio, the dataset stores per-segment semantic codec (DACVAE) posterior mean latents (25 fps, 128-dimensional, float16), REPA targets (PCA-projected 128-dimensional vectors from layer 16 of the self-supervised teacher model facebook/w2v-bert-2.0), ASR transcriptions and silence annotations, along with a manifest file pointing to original data sources. Current data size: 83 ingest groups, 32,019 files, 102.6 GB. Training data is under tts_en/ directory split by source (echo_en train and echo_en_heldout); evaluation data under eval/en/ includes echo held-out voices, Seed-TTS test set, LibriSpeech (with PC version), AMI, etc. It also contains HuBERT-large teacher checkpoint and backup information. The dataset is suitable for latent-variable TTS models requiring dense latent representations and supervision targets. License: Apache-2.0 (source audio generation model EchoTTS is CC BY-NC-SA 4.0).
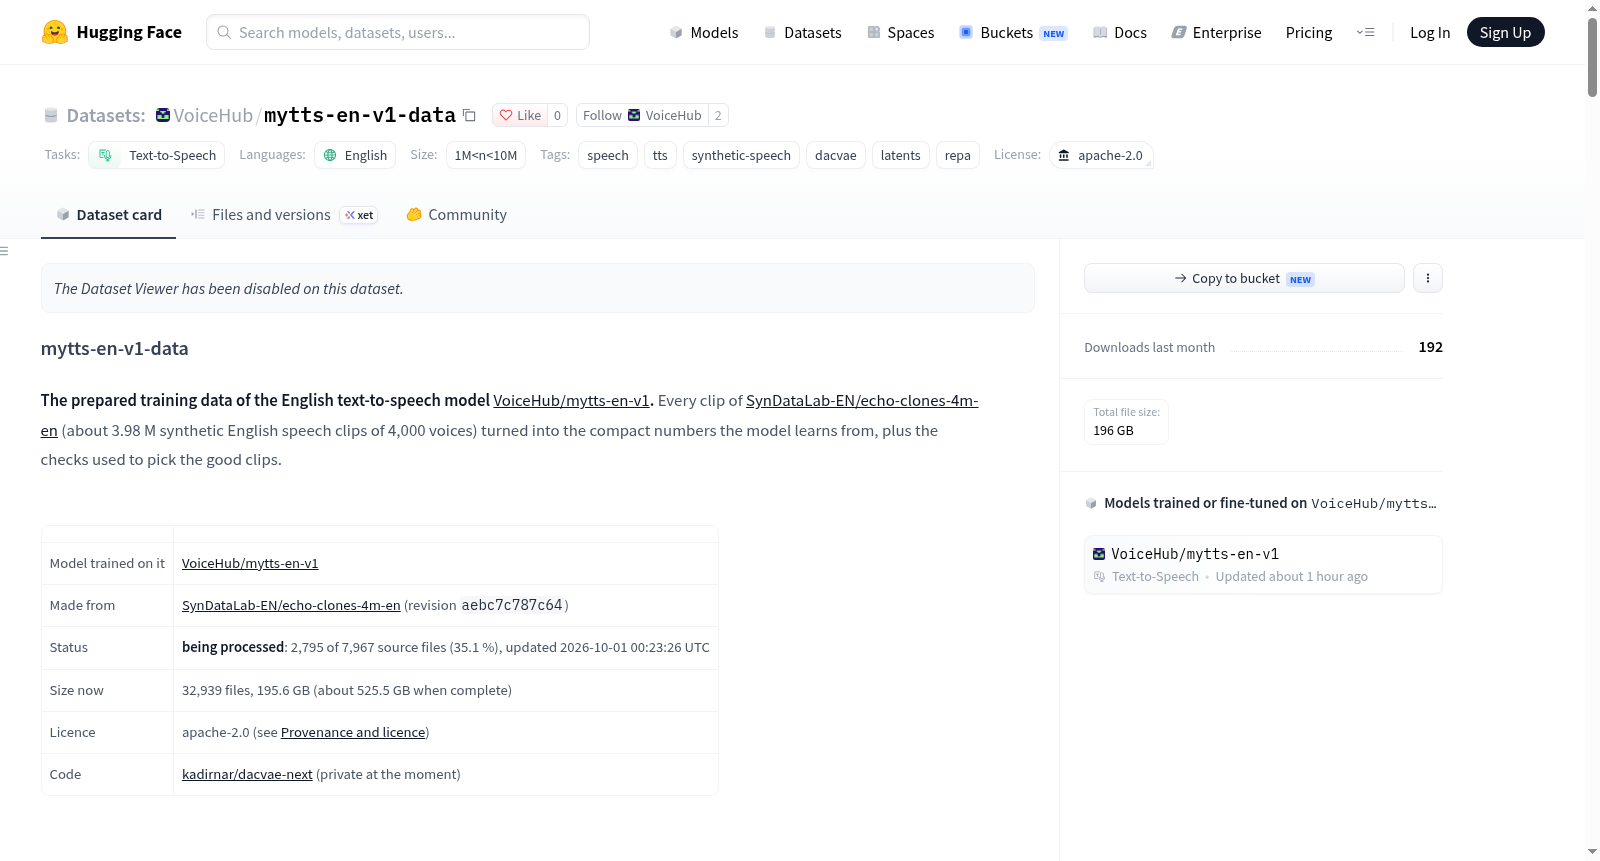
mytts-en-v1-data 数据集总结
基本信息
- 数据集名称:mytts-en-v1-data
- 许可证:apache-2.0
- 语言:英语(en)
- 任务类别:文本转语音(text-to-speech)
- 标签:speech、tts、synthetic-speech、dacvae、latents、repa
- 规模类别:1M < n < 10M
- 数据来源:SynDataLab-EN/echo-clones-4m-en(revision
aebc7c787c64) - 用途:为英语 TTS 模型 VoiceHub/mytts-en-v1 准备的训练数据
- 代码库:kadirnar/dacvae-next(
roadmap/en-echo分支,当前为私有)
数据集描述
该数据集是英语文本转语音模型 VoiceHub/mytts-en-v1 的预处理训练数据。来源数据集中的每个音频片段(约 398 万条合成英语语音,来自 4,000 个声音)都被转化为模型学习的紧凑数字表示,并附带了用于筛选优质片段的检查数据。
处理状态与规模
| 项目 | 当前 | 完成后 |
|---|---|---|
| 已处理源文件(parquet) | 2,795 / 7,967(35.1 %) | 7,967 |
| 已读取源片段 | 1,397,250 | 约 3.98 M |
| 已上传组(每组 16 个源文件) | 175 | 498 |
| 保留的留出片段(236 个声音,每个最多 60 条) | 14,160 | 最多 14,160 |
| 本仓库文件数 | 32,939 | - |
| 大小 | 195.6 GB | 约 525.5 GB |
- 数据仍在处理中,每 50 个新组更新一次页面。
- 最后更新:2026-10-01 00:23:26 UTC。
数据内容
每个片段包含三类数据,前两类均为 25 帧/秒:
| 特征 | 说明 | 具体形式 | 目录 |
|---|---|---|---|
| Codec latents(模型学习生成的目标) | 音频的压缩表示;codec 解码器可还原为声音 | Semantic-DACVAE 后验均值,25 Hz x 128 个数值,float16(codec Aratako/Semantic-DACVAE-Japanese@737fbad2a679f880) |
tts_en/latents/ |
| REPA targets(训练辅助) | 大型语音理解模型每帧听到的内容;用于加速 TTS 模型学习 | w2v-BERT 2.0 第 16 层,通过 PCA 从 1,024 降至 128 个数值(tts_en/ssl/pca.npz),float16 |
tts_en/ssl/ |
| 文本与质量检查 | 每段说的句子、语音识别结果、静音位置;用于剔除劣质片段 | 源文本(.meta.parquet、manifests);Parakeet CTC 1.1B 转录 + CER / WER / NLL;2 % 采样的 Whisper-large-v3-turbo;边缘静音、最长停顿、是否触及 EchoTTS 长度上限 |
tts_en/annotations/ |
此外还包含 236 个留出声音的原始音频和英语评估集(仅用于评估)。
明确不属于本数据集的内容
- 不是用于聆听的音频:latents 是数字。要听语音需播放源数据集片段、在模型页听样本,或用 codec 解码 latents。唯一的音频是留出声音片段和评估集。
- 不是源数据集:原始音频和文本位于 SynDataLab-EN/echo-clones-4m-en。
- 不是训练列表本身:它包含所有片段;经过质量过滤后实际训练的片段列于
tts_en/catalogs/。 - 不能搭配其他 codec 使用:latents 属于此特定 codec 版本,REPA targets 属于
tts_en/ssl/pca.npz。 - 训练数据中无真实录音:所有训练语音均为合成(EchoTTS 声音克隆)。仅
eval/en/下的评估集含真实录音(LibriSpeech、AMI、Seed-TTS-eval 的 Common Voice prompts)。
目录结构
| 目录 | 内容 | 用途 | 文件数 | 大小 |
|---|---|---|---|---|
tts_en/latents/echo_en/ |
每个训练片段的 codec latents | 训练 | 525 | 87.9 GB |
tts_en/ssl/echo_en/ |
每个训练片段的 REPA targets | 训练 | 350 | 87.7 GB |
tts_en/ssl/ |
pca.npz、info.json |
训练 | 2 | 529.8 kB |
tts_en/annotations/asr2/echo_en/ |
每片段的 Parakeet CTC 1.1B 转录及 CER / WER / NLL | 训练(片段过滤) | 175 | 160.6 MB |
tts_en/annotations/asr/echo_en/ |
2 % 采样的 Whisper-large-v3-turbo 转录(交叉核对) | 分析 | 175 | 8.0 MB |
tts_en/annotations/edges/echo_en/ |
每片段首尾静音 | 训练(片段边缘) | 175 | 69.0 MB |
tts_en/annotations/silence/echo_en/ |
每片段最长停顿、生成长度上限及是否触及(EchoTTS 失败片段) | 训练(片段过滤) | 175 | 37.0 MB |
tts_en/manifests/ |
每片段一行 JSON:id、文本、声音、许可证、源行 hf://datasets/<source>@<revision>/<file>#<row> |
溯源 | 175 | 532.6 MB |
tts_en/catalogs/ |
过滤后的训练片段列表(<name>/catalog.parquet + version.json、构建日志、泄漏检查) |
训练 | 8 | 9.8 MB |
tts_en/ |
latent_stats.json、splits.json、文件列表、留出声音列表 |
训练 | 7 | 213.7 kB |
tts_en/ingest/ |
ingest 状态(运行规格、已完成源文件)和 ledger | 记账 | 2 | 646.9 kB |
tts_en/manifests_local/ |
Tier-1 筛选子集的 manifest(本地原始路径;仅溯源) | 记账 | 1 | 12.9 MB |
tts_en/latents/echo_en_heldout/ |
留出声音片段的 codec latents | 留出:仅评估 | 111 | 946.5 MB |
tts_en/ssl/echo_en_heldout/ |
留出声音片段的 REPA targets | 留出:仅评估 | 74 | 944.3 MB |
tts_en/annotations/*/echo_en_heldout/ |
留出片段的四项标注(每项均有 Whisper) | 留出:仅评估 | 148 | 5.0 MB |
eval/en/echo_heldout_audio/ |
每个留出声音最多 60 个片段的原始音频 | 留出:仅评估 | 14,160 | 5.5 GB |
eval/en/echo_heldout/ |
留出声音的 echo 测试:列表、prompt 抽取、prompt 对 | 仅评估 | 212 | 111.4 MB |
eval/en/echo_heldout_ann/ |
保留留出音频的标注与 manifest | 仅评估 | 7 | 1.6 MB |
eval/en/seedtts_testset/ |
Seed-TTS-eval 测试集(en、zh),CC BY 4.0 | 仅评估 | 5,134 | 1.2 GB |
eval/en/LibriSpeech/ |
LibriSpeech test-clean / dev-clean 音频,CC BY 4.0 | 仅评估 | 5,512 | 727.8 MB |
eval/en/ami/ |
AMI Meeting Corpus 片段(ihm、sdm),CC BY 4.0 | 仅评估 | 996 | 336.5 MB |
eval/en/validation/ |
验证门:真实测试音频及其 codec 重合成的评估运行 | 仅评估 | 4,732 | 1.8 GB |
eval/en/voice_emb/ |
评估 prompt 与参考的说话人嵌入 | 仅评估 | 8 | 83.2 MB |
eval/en/ |
评估列表(*.jsonl)和保护列表 |
仅评估 | 8 | 3.0 MB |
tts_en_hubl18/ |
筛选子集的 HuBERT-large 第 18 层 REPA targets(EN-25 教师筛选) | 实验(v1 未使用) | 25 | 2.5 GB |
tts_en_hubl24/ |
筛选子集的 HuBERT-large 第 24 层 REPA targets(EN-25) | 实验(v1 未使用) | 25 | 2.5 GB |
tts_en_hubl24_fp32/ |
同上,以 fp32 计算(EN-25) | 实验(v1 未使用) | 17 | 2.5 GB |
backup/ |
manifest.jsonl、status.json、symlinks.json |
记账 | 3 | - |
注:<tag> 格式为 g<time_ns>-<group>,标识一个 ingest 组(16 个源文件,约 8,000 片段)。echo_en 为训练源,echo_en_heldout 为留出声音。
留出与仅评估部分(不可用于训练)
- 留出声音:所有
echo_en_heldout目录和eval/en/echo_heldout_audio/。4,000 个声音中的 236 个从不进入训练,每个最多保留 60 条用于 echo 测试(EN-08)。 - 评估集:
eval/en/下所有内容。Seed-TTS test-en、LibriSpeech(-PC)、AMI 来自其他语料库,保留各自许可证。 - Echo-unseen 声音:另外 177 个声音(EN-56)位于
echo_en中,但不被任何训练 catalog 包含。
数据加载方式
下载
- 完整数据较大(当前 195.6 GB)。尝试一个组即可:使用
huggingface_hub.snapshot_download,指定allow_patterns=[f"tts_en/*/echo_en/*{tag}*", "tts_en/ssl/pca.npz", "tts_en/latent_stats.json"]。 - 全部训练数据:
allow_patterns=["tts_en/*"]。
读取单个片段(仅需 numpy)
使用 parquet 读取 .meta.parquet,读取 .idx.json 获取 keys、offsets、n_frames、dim、dtype,通过 memmap 读取 .bin 并 reshape 为 [-1, dim],取第 i 段得到 [frames, 128] 张量(25 帧/秒)。同一片段的 REPA targets 位于 tts_en/ssl/echo_en/shard-<tag>-t0-000000.{bin,idx.json},key 与帧相同。
使用项目代码(mytts)
通过 mytts.config.DataConfig、mytts.data.catalog.build_catalog / CatalogFilters、mytts.data.dataset.Catalog / TTSDataset 构建并读取。
Catalog:精确训练列表
tts_en/catalogs/<name>/catalog.parquet 每行对应一个通过质量过滤的片段:key、文本、声音、长度、latents 与 REPA targets 路径、split(train/val);version.json 记录过滤器和小时数。echo_en_v1 是主运行 catalog:Parakeet CER ≤ 0.3(用 en-v2 文本归一化重打分)、无长停顿(> 6 s)、无因静音卡在长度上限的片段、排除 echo-unseen 声音、0.1 % 作为 val。en_t1 是 88.8 h 筛选子集。当前已有 catalog:en_t1、en_t1_x56。
聆听片段
使用 mytts.codec.DACVAECodec 加载 Aratako/Semantic-DACVAE-Japanese@737fbad2a679f880,对 latents 解码得到 48 kHz 波形,可用 soundfile 写出。
制作流程
- Stream:源数据集的 7,967 个 parquet 文件(1.51 TB)按固定打乱顺序,每次 16 个(一组)下载。
- Decode:每个片段解码一次。236 个留出声音的片段(每个声音前 60 条,保留音频)归入
echo_en_heldout,其余归入echo_en。 - Encode:GPU 上编码 codec latents(48 kHz 音频,精确 fp32 编码器,存为 float16)和 w2v-BERT 2.0 第 16 层特征,用一次性拟合的 PCA 投影到 128 个数值(REPA targets)。
- Annotate:每片段 Parakeet CTC 转录及 CER / WER / NLL;对留出片段和 2 % 采样使用 Whisper;边缘静音、最长停顿、长度上限。
- Check and commit:输出覆盖所有片段才计为一组,写入 ledger 并删除下载的源文件。
- Upload:每 50 个提交组上传一次,每文件与 Hub 记录核对(大小和 sha256)。
- Curate:stream 结束后用过滤器生成训练 catalog
echo_en_v1。
溯源与许可证
- 本数据集:apache-2.0(所有者决定,2026-09-29)。
- 来源:SynDataLab-EN/echo-clones-4m-en;其数据卡声明 apache-2.0。其语音由 EchoTTS(jordand/echo-tts-base,数据卡为 cc-by-nc-sa-4.0)从 SynData-2/echo-ref-speakers-4k-en 的参考声音和 SynData-2/echo-4m-text-en 的文本生成(后两者数据卡未声明许可证)。商用前请自行核查这些条款。
- 制作特征所用模型(各有许可证,权重均不在本仓库):Aratako/Semantic-DACVAE-Japanese(MIT)、facebook/w2v-bert-2.0(MIT)、nvidia/parakeet-ctc-1.1b(CC BY 4.0)、openai/whisper-large-v3-turbo(MIT);facebook/hubert-large-ll60k(Apache-2.0,仅用于
tts_en_hubl*根)。 - 评估音频(
eval/en/)保留各自许可证与署名:Seed-TTS-eval(CC BY 4.0,Common Voice prompts)、LibriSpeech(CC BY 4.0)、AMI Meeting Corpus(CC BY 4.0,University of Edinburgh / AMI consortium)。
备份与恢复(维护者)
本仓库同时也是项目数据根的备份。scripts/hub_backup.py 仅上传 ingest 已提交的内容,提交后核对每个文件(大小,以及 LFS sha256 或小文件的 git blob sha1),并在每次状态更新前核对 backup/manifest.jsonl 中每个文件已在仓库且大小与哈希一致。提供 restore 命令用于验证样本或全部恢复,恢复仅写入空目录(可选项允许非空),并始终拒绝运行中 ingest 的数据根。manifests 与 ingest 状态记录 /workspace/data 下的绝对路径,交换后可再次成立,ingest 从 tts_en/ingest/echo_en.json 恢复。
相关链接
- 模型:VoiceHub/mytts-en-v1
- 源音频与文本:SynDataLab-EN/echo-clones-4m-en
- 代码:kadirnar/dacvae-next(
roadmap/en-echo分支):scripts/ingest_stream.py、mytts/data/、scripts/hub_backup.py - 项目早期页面(筛选阶段存档,使用本数据不需要):VoiceHub/mytts-en、VoiceHub/mytts-en-samples、VoiceHub/mytts-en-ablations、VoiceHub/mytts-en-eval、VoiceHub/mytts-en-base