tts_farm
收藏资源简介:
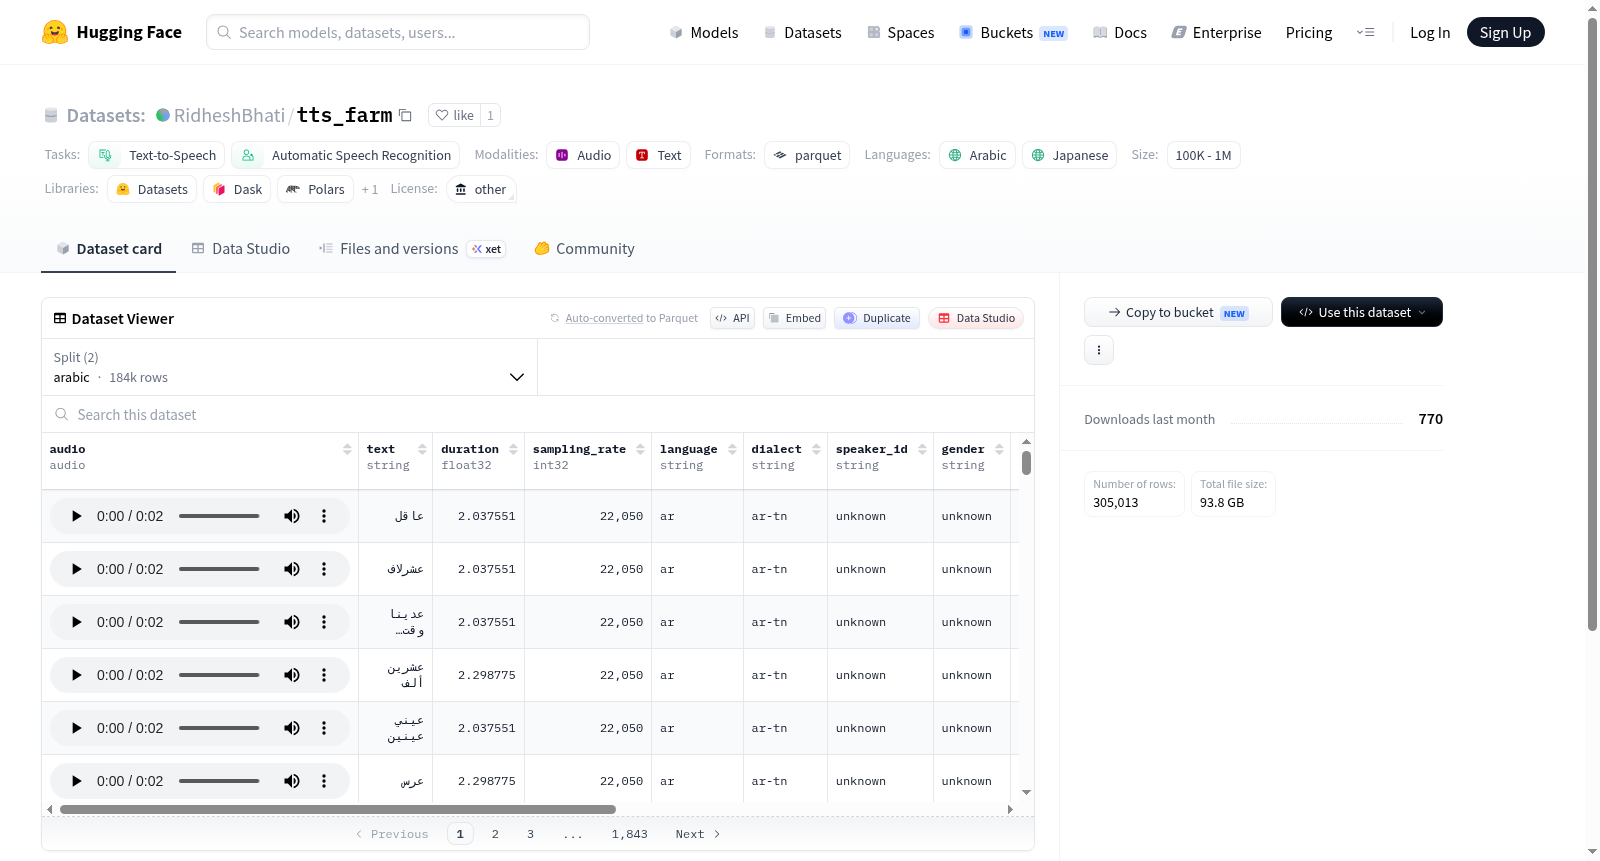
阿拉伯语和日语 TTS/ASR 聚合数据集是一个专门用于文本转语音(TTS)和自动语音识别(ASR)任务的多语言语音数据集。该数据集汇集了阿拉伯语和日语两种语言的语音数据,总体规模在10万到100万个样本之间。数据经过清洗、去重和响度归一化处理(针对阿拉伯语部分),以确保质量。每个数据样本包含核心的音频-文本对:音频为16位PCM WAV格式,采样率为22050 Hz;文本为对应的转录内容。此外,数据集还提供了丰富的元数据字段,包括音频时长、采样率、语言、方言、说话人ID、性别、来源数据集名称、数据划分(如训练/验证/测试)、唯一标识符(uid)以及多项音频质量指标(RMS、LUFS、SNR)。这些元数据有助于进行深入的数据分析、模型训练和评估。数据集通过Hugging Face平台提供,配置了阿拉伯语和日语两个独立的数据子集。
The Arabic and Japanese TTS/ASR aggregated dataset is a multilingual speech dataset specifically designed for text-to-speech (TTS) and automatic speech recognition (ASR) tasks. It aggregates speech data in Arabic and Japanese languages, with an overall scale ranging from 100,000 to 1,000,000 samples. The data has been cleaned, deduplicated, and normalized for loudness (for the Arabic portion) to ensure quality. Each data sample consists of core audio-text pairs: audio in 16-bit PCM WAV format with a sampling rate of 22050 Hz, and text as corresponding transcriptions. Additionally, the dataset provides rich metadata fields, including audio duration, sampling rate, language, dialect, speaker ID, gender, source dataset name, data splits (e.g., train/validation/test), unique identifier (uid), and multiple audio quality metrics (RMS, LUFS, SNR). This metadata facilitates in-depth data analysis, model training, and evaluation. The dataset is available via the Hugging Face platform, configured with two independent subsets for Arabic and Japanese.
- 数据集名称: Arabic and Japanese TTS/ASR Aggregated Dataset
- 数据集地址: https://huggingface.co/datasets/RidheshBhati/tts_farm
- 语言: 阿拉伯语 (ar)、日语 (ja)
- 许可: 其他 (other)
- 任务类别: 文本转语音 (text-to-speech)、自动语音识别 (automatic-speech-recognition)
- 数据集大小: 100,000 到 1,000,000 个样本 (100K<n<1M)
- 配置:
- config_name: default
- 数据文件:
- 分裂: arabic → 路径: data/arabic/*.parquet
- 分裂: japanese → 路径: data/japanese/*.parquet
- 数据文件:
- config_name: default
- 数据特征:
- audio: 音频,采样率 22050 Hz
- text: 文本 (字符串)
- duration: 时长 (浮点数)
- sampling_rate: 采样率 (整数)
- language: 语言 (字符串)
- dialect: 方言 (字符串)
- speaker_id: 说话人ID (字符串)
- gender: 性别 (字符串)
- dataset_name: 数据集名称 (字符串)
- split: 分裂 (字符串)
- uid: 唯一标识符 (字符串)
- rms: 均方根值 (浮点数)
- lufs: 响度单位 (浮点数)
- snr: 信噪比 (浮点数)
- 描述: 经过清理、去重和响度归一化的阿拉伯语语音数据。训练集包含
audio(16位PCM WAV, 22050 Hz) 和text列;其余列包含质量和来源元数据。