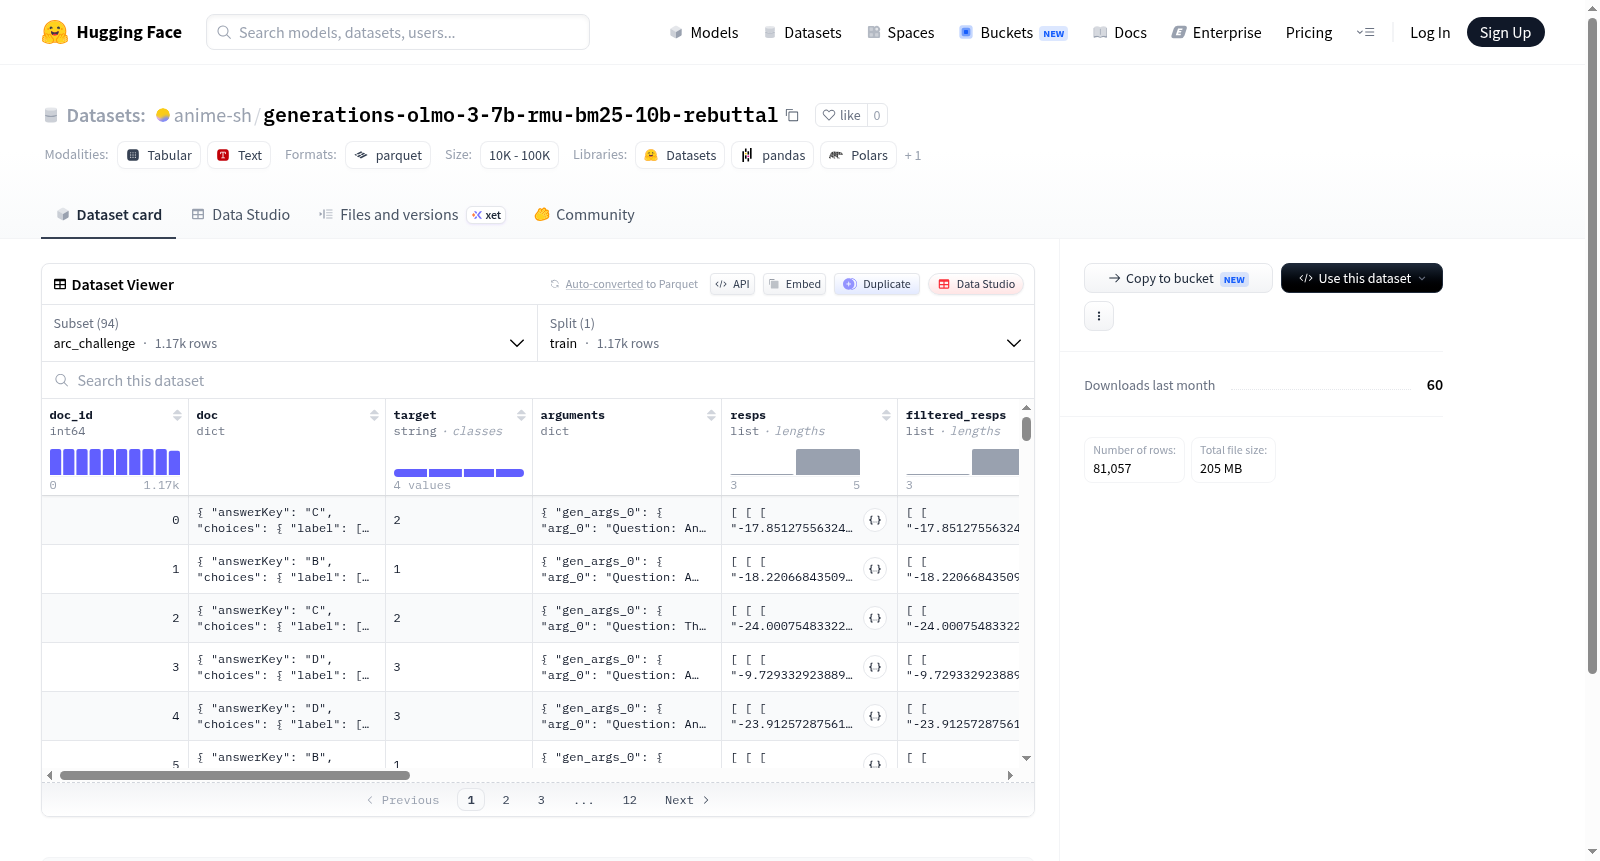
generations-olmo-3-7b-rmu-bm25-10b-rebuttal
收藏资源简介:
本数据集是一个包含多个子任务配置的集合,旨在评估和训练语言模型在复杂推理与问答任务上的能力。数据源自多个知名的基准测试,包括ARC挑战赛(ARC Challenge)和BIG-Bench Hard(BBH)中的多个思维链(Chain-of-Thought, CoT)少样本(few-shot)任务。具体涵盖的任务类型广泛,例如:布尔表达式、因果判断、日期理解、消歧问答、Dyck语言、形式谬误、几何形状、超常语序、多对象逻辑演绎、电影推荐、多步算术、导航、物体计数、表格信息处理(企鹅)、有色物体推理以及名称损毁等。每个数据样本通常包含一个输入问题(或提示)、一个目标答案(或参考解答)、以及模型生成的多个响应及其对应的生成参数(如采样温度、最大生成长度等)。此外,数据集还记录了过滤后的响应、评估指标(如分数)以及用于数据溯源的哈希值。数据集规模因配置而异,例如ARC Challenge配置包含1172个训练样本,而多数BBH的CoT少样本配置各包含250个训练样本。该数据集适用于语言模型评估、推理能力研究、少样本学习、思维链生成以及模型响应分析等场景。
This dataset is a collection of multiple subtask configurations designed to evaluate and train language models on complex reasoning and question-answering tasks. The data is derived from several well-known benchmarks, including ARC Challenge and multiple Chain-of-Thought (CoT) few-shot tasks from BIG-Bench Hard (BBH). It covers a wide range of task types, such as: Boolean expressions, causal judgment, date understanding, disambiguation QA, Dyck languages, formal fallacies, geometric shapes, hyperbaton, logical deduction with multiple objects, movie recommendation, multi-step arithmetic, navigation, object counting, penguin table processing, colored object reasoning, and name corruption. Each data sample typically includes an input question (or prompt), a target answer (or reference solution), multiple model-generated responses with corresponding generation parameters (e.g., sampling temperature, maximum generation length), as well as filtered responses, evaluation metrics (e.g., scores), and hash values for data provenance. The dataset size varies by configuration; for example, the ARC Challenge configuration contains 1172 training samples, while most BBH CoT few-shot configurations each contain 250 training samples. This dataset is suitable for language model evaluation, reasoning capability research, few-shot learning, chain-of-thought generation, and model response analysis.
数据集详情总结
数据集概述
该数据集名为 anime-sh/generations-olmo-3-7b-rmu-bm25-10b-rebuttal,托管于 Hugging Face 平台,主要用于评估语言模型在多种推理任务上的生成性能。
数据集结构
数据集包含多种配置(config),涵盖不同的评测基准任务,主要分为以下类别:
1. ARC Challenge(挑战性推理)
- 配置名:
arc_challenge - 样本数: 1172
- 特点: 包含多选题(含答案选项、问题和正确答案),并记录模型生成的多个候选回答及过滤后的回答。
2. BIG-Bench Hard (BBH) 少样本思维链任务(CoT Few-shot)
包含多个子任务,每个子任务的样本数通常为 250(个别任务例外),所有子任务共享类似的数据结构:
| 子任务配置 | 样本数 | 下载大小 | 数据集大小 |
|---|---|---|---|
bbh_cot_fewshot_boolean_expressions |
250 | 662,627 | 673,859 |
bbh_cot_fewshot_causal_judgement |
187 | 1,193,894 | 1,201,772 |
bbh_cot_fewshot_date_understanding |
250 | 529,645 | 541,857 |
bbh_cot_fewshot_disambiguation_qa |
250 | 1,343,169 | 1,342,111 |
bbh_cot_fewshot_dyck_languages |
250 | 1,039,311 | 1,039,928 |
bbh_cot_fewshot_formal_fallacies |
250 | 1,880,151 | 1,895,221 |
bbh_cot_fewshot_geometric_shapes |
250 | 1,652,494 | 1,667,387 |
bbh_cot_fewshot_hyperbaton |
250 | 1,185,765 | 1,188,011 |
bbh_cot_fewshot_logical_deduction_five_objects |
250 | 1,180,990 | 1,183,848 |
bbh_cot_fewshot_logical_deduction_seven_objects |
250 | 1,322,147 | 1,321,706 |
bbh_cot_fewshot_logical_deduction_three_objects |
250 | 1,015,656 | 1,019,806 |
bbh_cot_fewshot_movie_recommendation |
250 | 820,132 | 828,511 |
bbh_cot_fewshot_multistep_arithmetic_two |
250 | 929,747 | 921,241 |
bbh_cot_fewshot_navigate |
250 | 802,002 | 809,633 |
bbh_cot_fewshot_object_counting |
250 | 555,877 | 566,859 |
bbh_cot_fewshot_penguins_in_a_table |
146 | 619,769 | 612,209 |
bbh_cot_fewshot_reasoning_about_colored_objects |
250 | 937,509 | 942,983 |
bbh_cot_fewshot_ruin_names |
250 | — | — |
数据字段说明
数据集包含统一的字段结构,主要体现在以下方面:
通用字段
- doc_id: 文档标识符(整数)
- target: 标准答案(字符串)
- filter: 过滤方法(字符串)
- doc_hash、prompt_hash、target_hash: 哈希值(字符串)
- score: 模型得分(浮点数)
- metrics: 评估指标(可为空或字符串列表)
模型生成相关字段
- arguments: 生成参数,包含
gen_args_0(生成配置,如采样开关、最大生成token数、温度、停止条件等) - resps: 模型原始生成的回答(嵌套列表)
- filtered_resps: 过滤后的回答(列表)
- bypass: 旁路标记(可为空)
特定于任务(ARC)的字段
- doc 中包含:问题(
question)、答案选项(choices:标签和文本)、正确答案(answerKey)和任务ID(id)
数据划分
- 所有配置均只包含 train 划分,未提供验证集或测试集。
- 各子任务的样本量从 146 到 1172 不等,总样本量合计约 5,000+ 条。
数据集用途
该数据集用于综合评测模型在以下方面的能力:
- 多选题推理(ARC Challenge)
- 逻辑推理、数学运算、常识判断、自然语言理解等(BBH 系列任务)
- 记录模型的多次生成结果及过滤后的回答,支持在推理过程中进行多轮采样评估
总数据规模
- 总下载大小: 约 16.5 MB(根据已列出的子集汇总)
- 总数据集大小: 约 17.5 MB(根据已列出的子集汇总)
注:由于 README 内容未完整提供,部分配置(如
bbh_cot_fewshot_ruin_names)的完整信息可能缺失。