freesound-commercial-50k-noise-only
收藏资源简介:
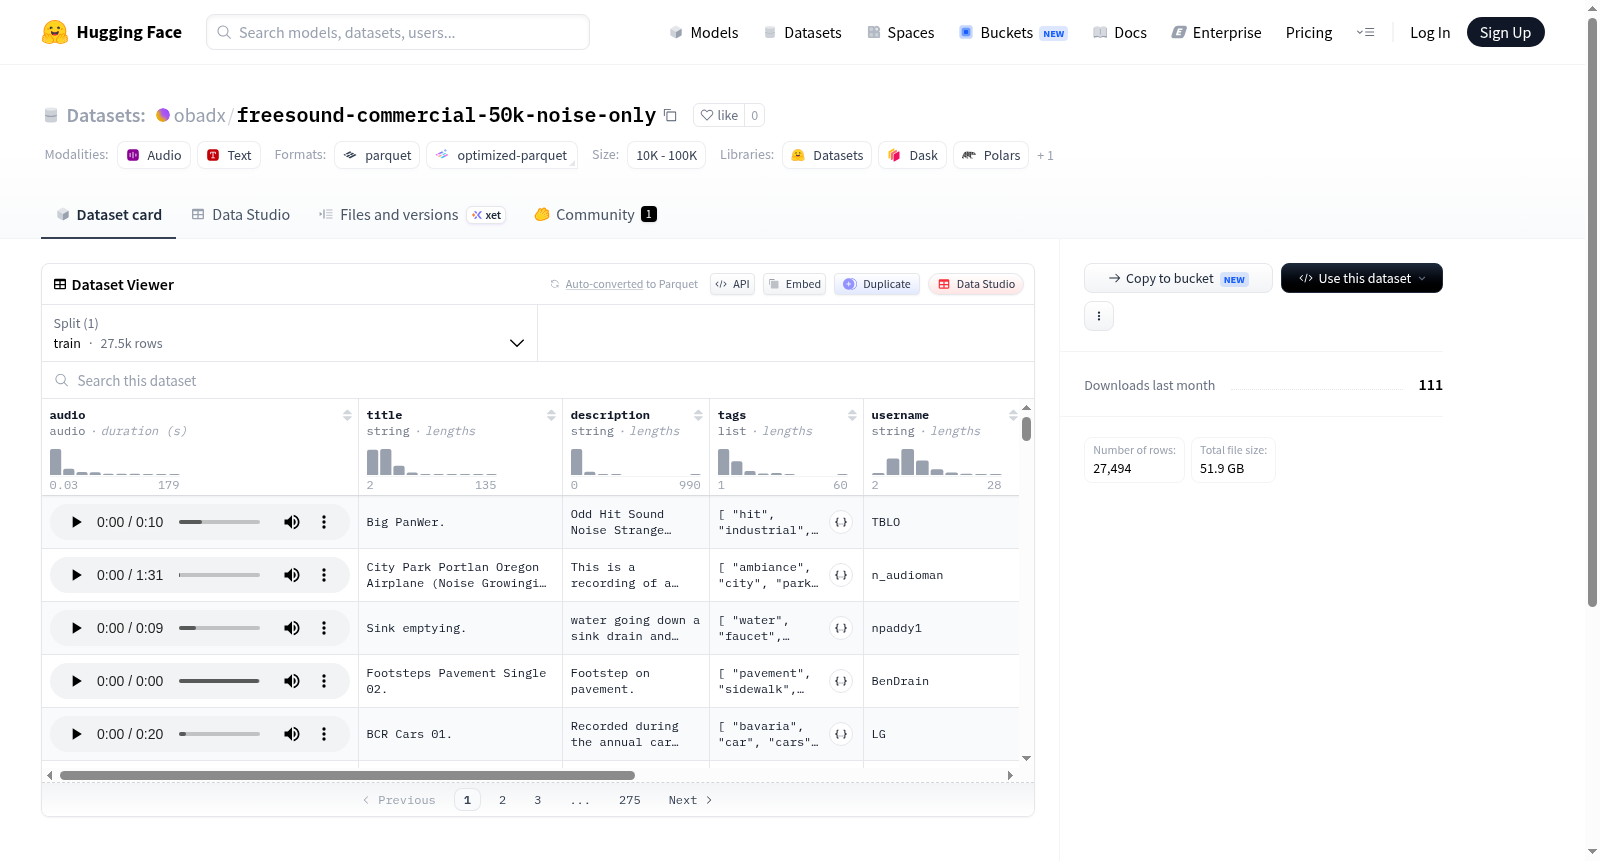
Freesound Commercial Noise数据集是从Freesound.org爬取的噪声音频集合的商业用途子集。原始数据集为benjamin-paine/freesound-laion-640k,经过过滤和筛选后得到包含约5万样本的MoamenElSayed/freesound-commercial-50k,本数据集进一步剔除了可能干扰语音数据增强的音乐或语音内容,保留纯噪声样本。数据集包含27,494个音频样本,总时长为213.30小时,总大小约51.94GB。每个样本包含音频文件以及标题、描述、标签、上传者用户名、Freesound ID、许可证类型(包括CC0-1.0、CC-BY-4.0等多种Creative Commons许可)、是否要求署名以及是否允许商业使用等元数据。该数据集专门设计用于语音数据增强等需要纯净噪声背景的应用场景。
The Freesound Commercial Noise dataset is a commercial-use subset of noise audio collections crawled from Freesound.org. It originates from the original dataset benjamin-paine/freesound-laion-640k, which was filtered and refined to produce MoamenElSayed/freesound-commercial-50k with approximately 50,000 samples. This dataset further removes music or speech content that might interfere with speech data augmentation, retaining pure noise samples. It contains 27,494 audio samples, with a total duration of 213.30 hours and a total size of approximately 51.94 GB. Each sample includes audio files along with metadata such as title, description, tags, uploader username, Freesound ID, license types (including various Creative Commons licenses like CC0-1.0 and CC-BY-4.0), whether attribution is required, and whether commercial use is permitted. This dataset is specifically designed for applications like speech data augmentation that require clean noise backgrounds.
数据集名称
Freesound Commercial Noise
数据集来源
- 原始数据集:benjamin-paine/freesound-laion-640k
- 经筛选后中间数据集:MoamenElSayed/freesound-commercial-50k
- 本数据集进一步过滤了可能干扰原始语音数据的音乐或语音噪声,仅保留纯噪声样本。
数据集规模
- 总样本数:27,494 条
- 总时长:213.30 小时
- 数据大小:约 51.94 GB
数据集划分
- 仅包含训练集(train),共 27,494 个样本。
数据字段
| 字段名 | 类型 | 说明 |
|---|---|---|
| audio | 音频(未解码) | 音频文件 |
| title | 字符串 | 音频标题 |
| description | 字符串 | 音频描述 |
| tags | 字符串列表 | 标签 |
| username | 字符串 | 上传者用户名 |
| freesound_id | 无符号64位整数 | Freesound 平台 ID |
| license | 分类标签 | 许可协议(如 CC0-1.0, CC-BY-4.0 等) |
| attribution_required | 分类标签 | 是否需要署名(是/否) |
| commercial_use | 分类标签 | 是否允许商业使用(是/否) |
许可协议
- 支持多种 Creative Commons 许可协议:CC0-1.0、CC-BY-4.0、CC-BY-3.0、CC-BY-NC-3.0、CC-BY-NC-4.0、CC-Sampling+。
- 所有样本均为商业可用子集。
用途
- 适用于数据增强场景,特别是需要添加无音乐、无语音的纯噪声作为干扰源,以不影响原始语音数据。