koren2018-orfeome14756-emb
收藏资源简介:
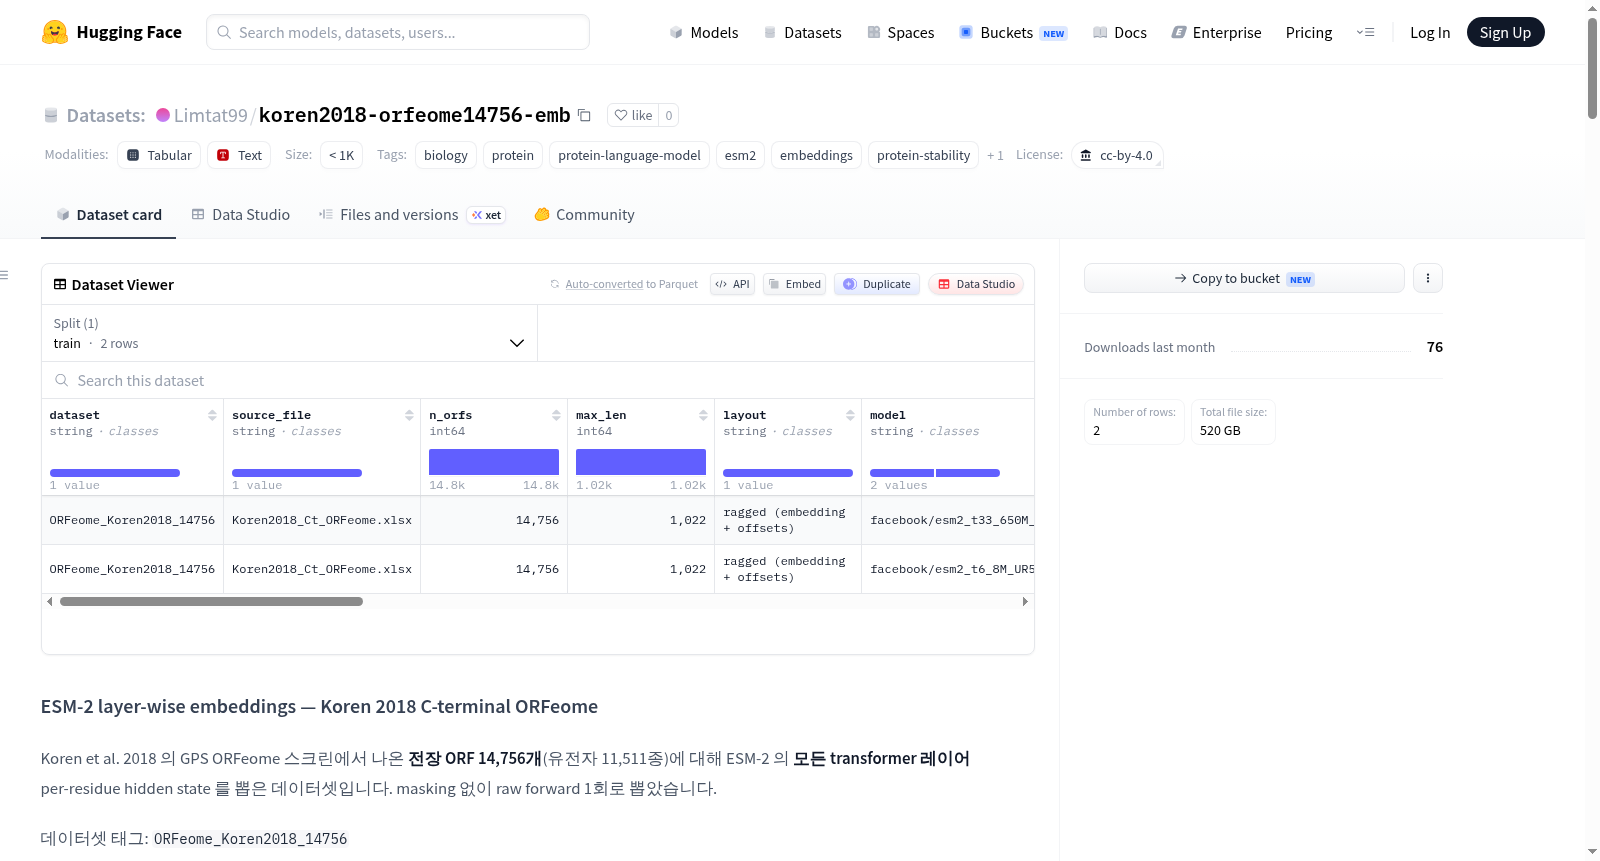
本数据集源自 Koren 等(2018)发表于 Cell 的 GPS ORFeome 筛选实验,包含 14,756 个全长开放阅读框(ORF),对应 11,511 个基因。使用 ESM-2 650M 参数模型(facebook/esm2_t33_650M_UR50D)进行无掩码前向传播,提取了所有 35 个 transformer 层(含嵌入层和最终层归一化前后)的每个残基隐藏状态,并以 float16 精度存储。为应对 ORF 长度差异(25–1022 个氨基酸,中位数 331),数据采用 ragged 格式存储,将嵌入沿 token 轴拼接,并记录偏移量,有效避免了填充带来的空间浪费。每个 npz 文件包含:拼接后的嵌入矩阵(形状 (ΣT, 1280))、偏移量数组、序列长度、IOH_ID、基因 ID、是否含硒代半胱氨酸(U)标志、原始序列等字段。该数据集适用于蛋白质稳定性预测、C 端降解子(degron)分析等任务。注意:PSI 标签未包含在此数据集中,用户需从原始论文的补充材料 Table S2B 中获取,并通过 IOH_ID 进行匹配。建议在训练/验证分割时使用基因 ID 进行 GroupKFold 交叉验证,以避免同一基因的不同亚型间的信息泄露。
This dataset is derived from the GPS ORFeome screening experiment published by Koren et al. (2018) in Cell, containing 14,756 full-length open reading frames (ORFs) corresponding to 11,511 genes. Using the ESM-2 650M parameter model (facebook/esm2_t33_650M_UR50D) for unmasked forward propagation, the hidden states of each residue from all 35 transformer layers (including the embedding layer and before/after final layer normalization) were extracted and stored in float16 precision. To handle the varying lengths of ORFs (25–1022 amino acids, median 331), the data is stored in a ragged format, concatenating embeddings along the token axis and recording offsets, effectively avoiding space waste from padding. Each npz file contains: concatenated embedding matrix (shape (ΣT, 1280)), offset array, sequence length, IOH_ID, gene ID, selenocysteine (U) flag, original sequence, and other fields. This dataset is suitable for tasks such as protein stability prediction and C-terminal degron analysis. Note: PSI labels are not included in this dataset; users need to obtain them from Table S2B in the supplementary materials of the original paper and match them via IOH_ID. It is recommended to use GroupKFold cross-validation with gene IDs for training/validation splits to avoid information leakage between different isoforms of the same gene.
ESM-2 层级嵌入数据集 — Koren 2018 C末端 ORFeome
数据集概述
本数据集包含来自 Koren et al. 2018 年 GPS ORFeome 筛选的 14,756 个全长开放阅读框(ORF)(涵盖 11,511 种基因),使用 ESM-2 蛋白质语言模型提取了所有 transformer 层的逐残基隐藏状态。数据通过无掩码的原始前向传播计算一次获得,数据集标签为 ORFeome_Koren2018_14756。
数据构成
| 文件夹 | 模型 | 层数 | 维度 | 每层大小 | 总计 |
|---|---|---|---|---|---|
ESM2_8M/ |
facebook/esm2_t6_8M_UR50D |
8(L0–L6, L6_pre) |
320 | 3.56 GB | 28.5 GB |
ESM2_650M/ |
facebook/esm2_t33_650M_UR50D |
35(L0–L33, L33_pre) |
1280 | 14.05 GB | 491.6 GB |
两个模型均已完成全部层的上传(8M 共 8 个文件,650M 共 35 个文件,总计 520.1 GB)。每个文件夹包含 _manifest.json,记录层列表、维度和 dtype 信息。每层对应一个独立文件。
存储格式
由于 ORF 长度在 25–1022 氨基酸之间变化(中位数为 331),数据采用 ragged 存储方式,沿 token 轴拼接嵌入并通过 offsets 记录边界:
embedding:(ΣT, dim),ΣT = 5,462,554offsets:(N+1,),N = 14,756- 第 i 个 ORF 的嵌入 =
embedding[offsets[i]:offsets[i+1]]
该方式避免了固定长度填充造成的约 2.8 倍空间浪费。
npz 文件结构
embedding (ΣT, dim) float16 拼接的嵌入 offsets (N+1,) int64 边界索引 seq_len (N,) int32 残基数(不含 BOS/EOS) ioh_id (N,) <U 标识符,如 IOH10003 gene_id (N,) <U 基因标识,用于 GroupKFold has_sec (N,) bool 是否含硒代半胱氨酸(U) sequence (N,) <U 可变长度序列 row_offset / n_rows / n_tokens int layer / model / dataset / token_layout bytes
注意:PSI 标签不包含在此数据集中,需从原论文补充材料获取后通过 ioh_id 进行连接。
层键说明
| 键 | 含义 |
|---|---|
L0 |
transformer 块输入前,即 embed_tokens(x) * 0.88(ESM-2 的 token dropout 校正项) |
L1 … L(n-1) |
各块输出 |
Ln |
最终块输出 + emb_layer_norm_after,即最终嵌入 |
Ln_pre |
final norm 应用前的结果 |
已通过计算验证 LayerNorm(Ln_pre) == Ln。
数据过滤规则
| 条件 | 处理方式 |
|---|---|
| 长度 > 1022 aa | 排除(超出 ESM-2 上下文限制) |
含未知残基 X |
排除(X 为占位符非氨基酸) |
| 含硒代半胱氨酸(U) | 保留(共 21 个 ORF),U 为真实第 21 种氨基酸 |
包含 U 的 21 个 ORF 涉及 SEPP1、GPX1-4、DIO1/3、SELENOF/M/S/T 等人类硒蛋白,其中 SEPP1 单序列含 10 个 U。如需排除,可用 has_sec 字段过滤。
使用建议
- 训练/验证划分:因同一基因存在多个异构体,建议使用基于
gene_id的 GroupKFold 进行划分,避免数据泄漏。 - 读取方式:数据集的 HF viewer 不可用(因 ragged npz 结构),需使用
np.load直接加载。 - 标签获取:PSI 值位于原论文补充材料 Table S2B,需下载后按
ioh_id进行连接。
数据完整性验证
上传后对全部 43 个文件进行了远程验证:
- ORF 数量及
offsets[-1]:全部为 14,756 和 5,462,554 diff(offsets) == seq_len + 2:全部区间一致- 文件间
offsets数组完全一致 - 嵌入实际大小与理论值精确匹配
- 无空区间、NaN 或 Inf
- 抽查重算(首/中/末 ORF)与原始提取值在 fp16 精度内一致,
L0层级逐位相同
引用信息
使用本数据集请引用原始论文:
Koren I, Timms RT, Kula T, Xu Q, Li MZ, Elledge SJ. The Eukaryotic Proteome Is Shaped by E3 Ubiquitin Ligases Targeting C-Terminal Degrons. Cell. 2018;173(7):1622-1635.e14. doi:10.1016/j.cell.2018.04.028 · PMID 29779948
| 组件 | 来源 / 许可 |
|---|---|
| ORF 序列 | 人类 ORFeome(Koren 2018 Table S2B) |
| PSI 测量值 | Koren et al. 2018 — 不包含在此存储库 |
| ESM-2 嵌入 | 本存储库产物,模型来自 Lin et al., Science 2023 (MIT) |
原始论文非开放获取(Copyright © 2018 Elsevier Inc.),因此 PSI 标签未包含在数据集中,需自行获取。