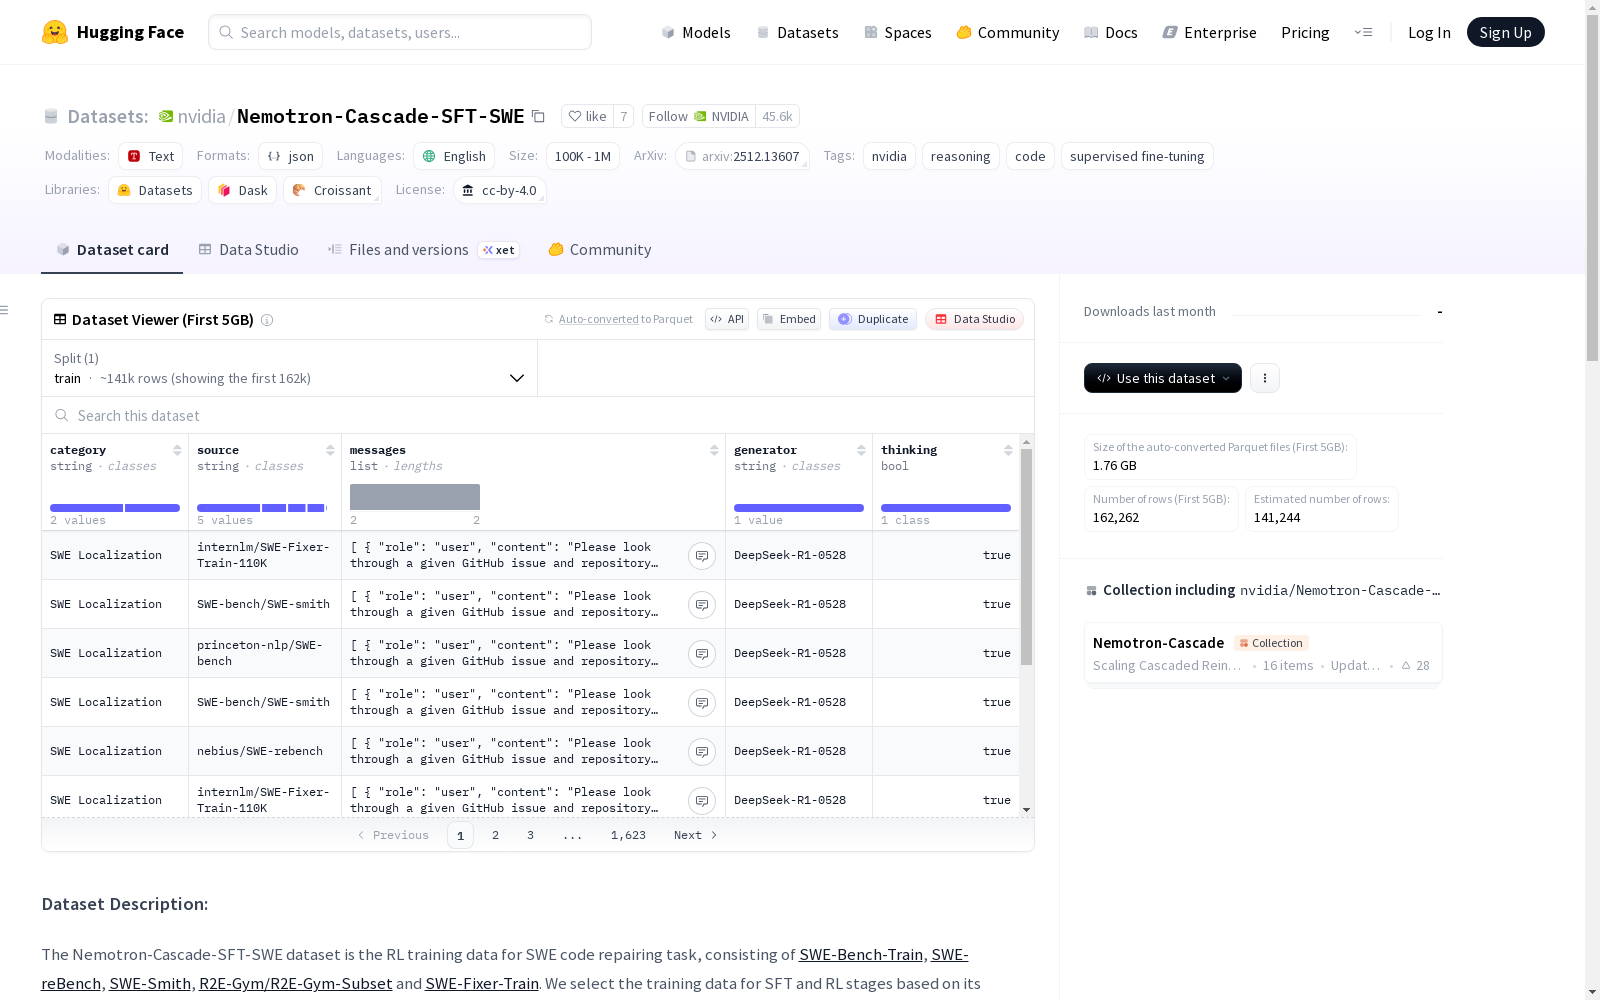
Nemotron-Cascade-SFT-SWE
收藏资源简介:
Nemotron-Cascade-SFT-SWE数据集是用于软件工程(SWE)代码修复任务的强化学习训练数据,由多个子数据集组成,包括SWE-Bench-Train、SWE-reBench、SWE-Smith、R2E-Gym/R2E-Gym-Subset和SWE-Fixer-Train。数据集根据难度选择用于监督微调(SFT)和强化学习(RL)阶段的训练数据,并排除了可能引起数据污染的实例。数据集的提示遵循agentless mini框架,包含三个任务:错误代码定位、代码修复和测试用例生成。响应是通过DeepSeek-R1-0528模型生成的。
The Nemotron-Cascade-SFT-SWE dataset is reinforcement learning training data for software engineering (SWE) code repair tasks, which comprises multiple sub-datasets including SWE-Bench-Train, SWE-reBench, SWE-Smith, R2E-Gym/R2E-Gym-Subset, and SWE-Fixer-Train. The dataset selects training data for the supervised fine-tuning (SFT) and reinforcement learning (RL) stages based on task difficulty, and excludes instances that may lead to data contamination. The prompts within the dataset follow the agentless mini framework, covering three tasks: faulty code localization, code repair, and test case generation. All responses are generated using the DeepSeek-R1-0528 model.
Nemotron-Cascade-SFT-SWE 数据集概述
数据集基本信息
- 名称:Nemotron-Cascade-SFT-SWE
- 许可证:CC-BY-4.0
- 主要标签:NVIDIA, 推理, 代码, 监督微调
- 语言:英语 (en)
数据集描述
该数据集是用于软件工程(SWE)代码修复任务的强化学习(RL)训练数据。它由多个现有数据集组合而成,包括 SWE-Bench-Train、SWE-reBench、SWE-Smith、R2E-Gym/R2E-Gym-Subset 以及 SWE-Fixer-Train。数据根据难度被筛选用于监督微调(SFT)和强化学习(RL)阶段。为避免数据污染,已排除所有源自评估数据集 SWE-Bench_Verified 中存在的仓库的实例。
数据构建方法
- 提示构建:遵循“无代理迷你框架”,包含三个任务:错误代码定位、代码修复和测试用例生成。
- 响应生成:使用 DeepSeek-R1-0528 模型生成。
- 性能成果:使用本数据集及其对应的 RL 数据集进行训练后,8B 和 14B 模型在 SWE-Bench 上(不使用 TTS)的 pass@1 解决率分别达到 37.2 和 43.1。
- 技术细节:更详细的数据创建过程可查阅技术报告(https://arxiv.org/abs/2512.13607)。
- 数据混合说明:所有 SWE 数据集在并入第二阶段 SFT 数据混合前,均进行了 3 倍上采样。
训练数据统计
代码定位任务
| 数据源 | 问题数量 | 样本数量 |
|---|---|---|
| SWE-Fixer-Train | 52,702 | 53,230 |
| SWE-Smith | 9,707 | 9,714 |
| SWE-Bench-Train | 10,251 | 16,184 |
| SWE-reBench | 9,654 | 9,693 |
| R2E-Gym/R2E-Gym-Subset | 3,444 | 3,444 |
代码修复任务
| 数据源 | 问题数量 | 样本数量 |
|---|---|---|
| SWE-Fixer-Train | 22,311 | 33,301 |
| SWE-Smith | 2,822 | 17,625 |
| SWE-Bench-Train | 3,660 | 19,540 |
| SWE-reBench | 2,822 | 16,441 |
测试用例生成任务
| 数据源 | 问题数量 | 样本数量 |
|---|---|---|
| SWE-Fixer-Train | 18,792 | 19,678 |
| SWE-Smith | 2,731 | 2,881 |
| SWE-Bench-Train | 4,797 | 6,066 |
| SWE-reBench | 3,021 | 3,026 |
数据结构
每个数据示例包含以下字段:
- category (str):任务类别,例如 SWE Repair / SWE Localization / SWE TestGen。
- source (str):实例原始来源的数据集名称。
- messages (list):遵循无代理迷你框架的用户提示和模型响应。
- generator (str):用于生成响应的模型。
- patch (str):在解决方案 PR 的第一个提交创建日期之前,对问题所做的评论。
- thinking (bool):是否为思考模式。