
遇见数据集

SINAI/ALIA-es-legal-administrative-synthetic-instructions

收藏
Hugging Face2026-06-15 更新2026-06-14 收录
官方服务:

资源简介:

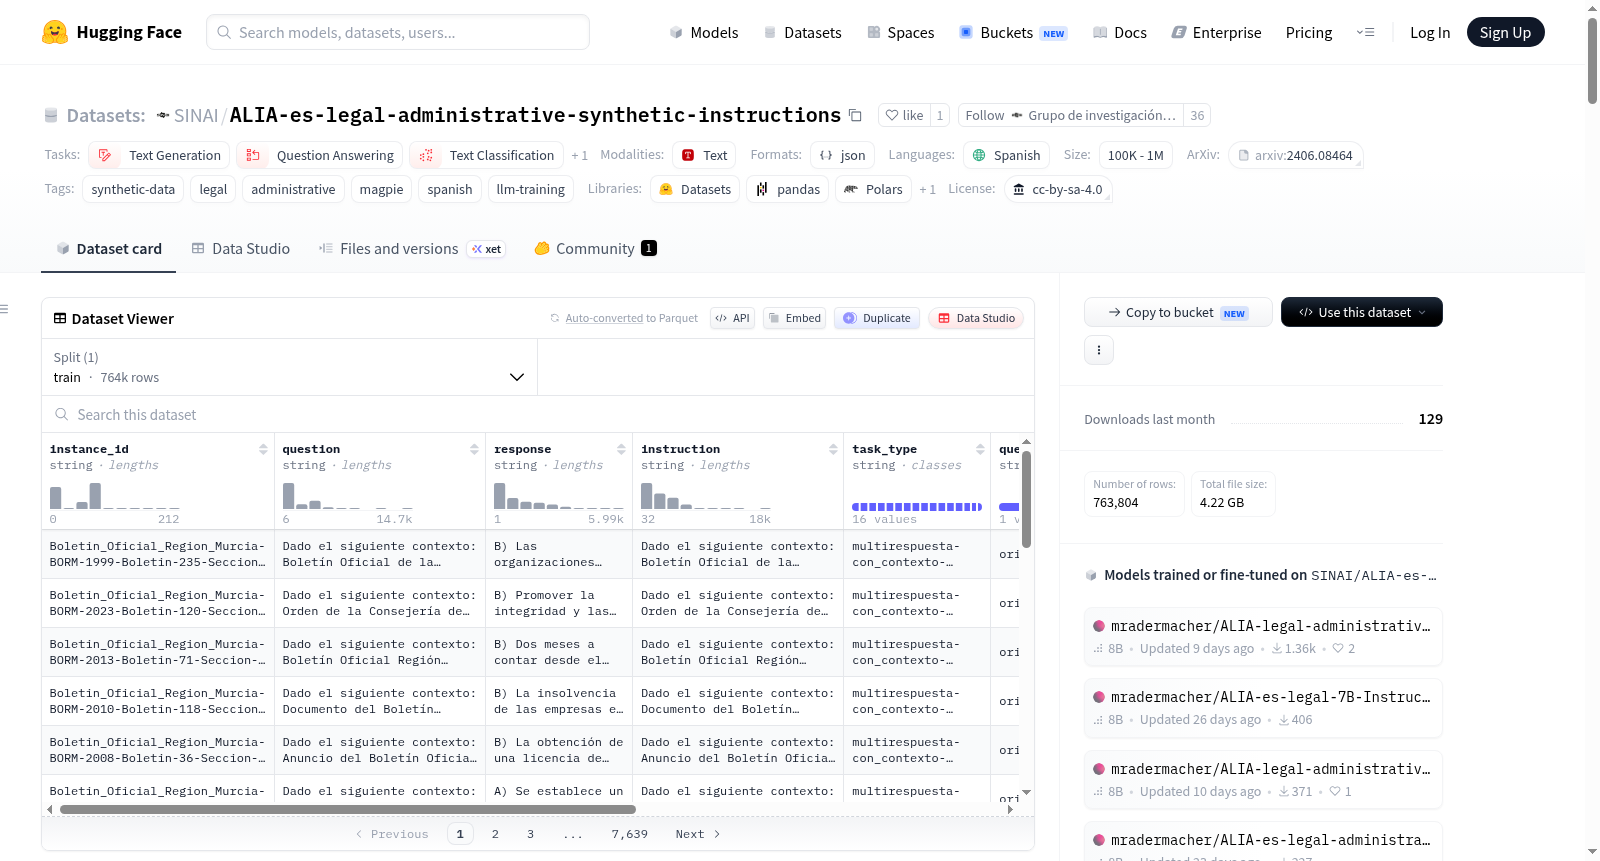
ALIA西班牙法律与行政合成指令语料库是一个西班牙语合成指令调优资源,由ALIA项目使用Magpie方法创建。它旨在通过受控格式和大规模监督来训练和评估语言模型在法律和行政任务中的表现。数据集包含764,180个实例和534,721,446个令牌,涵盖16种任务模态,包括问题、指令、多项选择、真/假等,并区分有无上下文和有无理由。该语料库包含合成生成的法律-行政指令-响应对,通过指令模型生成,并经过多步骤质量管道筛选。生成过程遵循Magpie方法,模型首先生成用户侧查询(问题或指令),然后生成相应的答案。语料库包括一般提示(无上下文)和基于西班牙法律和行政文档构建的上下文条件提示,还包含结构化评估友好格式(如多项选择和真/假变体),并明确控制理由。数据集适用于西班牙语法律大语言模型的指令调优、法律和行政问答、推理和受控响应格式的评估,以及领域适应和RAG导向训练的合成监督。

The ALIA Spanish Legal and Administrative Synthetic Instructions Corpus is a synthetic instruction-tuning resource in Spanish created under the ALIA project using the Magpie methodology. It was designed to train and evaluate language models in legal and administrative tasks with controlled formats and large-scale supervision. It contains 764,180 instances, 534,721,446 tokens, and 16 task modalities (questions, instructions, multiple-choice, true/false; with and without context; with and without justification). This dataset contains synthetic legal-administrative instruction-response pairs generated with an instruction model and curated through a multi-step quality pipeline. The generation process follows Magpie, where the model first produces a user-side query (question or instruction) and then generates the corresponding answer. The corpus includes both general prompts (without context) and context-conditioned prompts built from Spanish legal and administrative documents. It also includes structured evaluation-friendly formats such as multiple-choice and true/false variants, with explicit control over justification. The dataset is intended for instruction tuning of legal LLMs in Spanish, legal and administrative question answering, evaluation of reasoning and controlled response formats, and synthetic supervision for domain adaptation and RAG-oriented training.
提供机构:
SINAI
搜集汇总
数据集介绍
SINAI/ALIA-es-legal-administrative-synthetic-instructions 数据集图片
构建方式
该数据集依托ALIA项目,采用Magpie方法论构建,旨在为西班牙语法律与行政领域的大语言模型提供大规模的指令微调资源。构建过程首先向模型注入法律领域的系统提示,令其自主生成用户侧的查询,进而产生对应的回答。在此基础上,通过注入西班牙官方公报、法规等公共法律文档作为上下文,衍生出上下文依赖的生成模式。为增强评估友好性,数据集还设计了多项选择、真假判断等结构化变体,并精细控制了是否包含论证环节。最终,所有合成样本经由Galtea平台基于大语言模型的多步质量筛选流程进行净化与重构,以确保数据质量。
使用方法
用户可通过HuggingFace Datasets库直接加载该数据集,推荐以流式模式处理大规模数据以节省内存。加载后可访问每个样本的实例标识符、任务类型、问题、回答、完整指令文本及词元数等字段。该数据集适用于西班牙语法律大模型的指令微调、法律领域的问答系统构建、推理能力与受控响应格式的评测,以及领域自适应与检索增强生成的相关训练。研究者亦可依据task_type字段筛选特定任务子集,以满足定制化的训练或评估需求。
背景与挑战
背景概述
在自然语言处理领域,法律与行政文本的自动化处理因其高度结构化、术语严谨及推理要求复杂而长期面临挑战。为应对这一需求,西班牙SINAI研究团队于ALIA项目框架下,基于Magpie合成方法论,构建了ALIA-es-legal-administrative-synthetic-instructions语料库。该数据集诞生于2026年前后,核心研究问题聚焦于如何通过大规模合成指令数据,驱动西班牙语法律大语言模型在指令遵循、受限问答与结构化评估场景中的能力提升。它涵盖了76万余条实例、超5亿token,并设计了包含16种任务模态的精细格式,显著推进了法律人工智能的语料建设,对西语法律领域的模型微调与评估具有范式影响力。
当前挑战
该数据集主要解决两大层面挑战。领域层面,法律与行政文本的自动理解面临术语歧义、逻辑推理复杂与格式严苛等固有难题,传统通用语料难以适配此类专有场景的指令微调。构建过程中,核心挑战在于确保合成数据的高质量与真实性:采用Magpie方法虽能实现大规模生成,但原始输出存在法律逻辑偏差与风格同质化问题;为此,团队引入了Galtea平台进行基于大语言模型的多步质量过滤,以剔除不合理的问答对。此外,基于上下文生成的片段可能继承原始公文中的OCR残缺或排版异常,需精细处理才能维持语料可靠性。
常用场景
经典使用场景
ALIA-es-legal-administrative-synthetic-instructions数据集专为西班牙语法律与行政领域的大语言模型指令微调而设计,其经典使用场景涵盖法律问答、多项选择与是非判断等结构化任务的训练与评测。通过融合基于上下文与无上下文的提示生成方式,该数据集提供了超过76万条高质量指令-响应对,覆盖16种任务模态,使研究者能够在立法咨询、行政程序解读、法规条款理解等复杂场景中系统性地提升模型的指令遵循能力与推理准确性。
解决学术问题
该数据集致力于解决西班牙语法律与行政领域大语言模型在专家知识匮乏、标注数据稀缺及任务形式单一等方面的学术困境。通过系统性合成指令数据,它有效弥补了法律文本的高专业性与低资源语言模型的鸿沟,推动了面向结构化推理、多选判断与上下文感知回答能力的可控评估方法发展。其大规模、多模态的构造策略为领域自适应、检索增强生成及法律合规性验证等前沿研究方向提供了坚实的数据基础与实验基准。
实际应用
在实际应用层面,该数据集为构建智能化法律咨询服务系统提供了核心支撑,可用于开发能够自动解读官方公报、解答公民行政疑问、辅助法规检索与合规审查的西班牙语对话代理。例如,公民可通过自然语言询问社会保障政策或商业登记流程,模型依据上下文生成准确、结构化的答复。此外,该资源还可用于法院文书辅助撰写、行政流程自动化引导及法律教育领域的模拟考试生成,显著提升公共服务效率与法律信息可及性。
数据集最近研究
最新研究方向
数据集ALIA-es-legal-administrative-synthetic-instructions聚焦于西班牙语法律行政领域的指令微调与评估,其前沿研究正着力于利用Magpie方法论生成大规模、多模态的合成指令数据,涵盖问答、多项选择、真假判断等多样化任务形式,并融入上下文与无上下文的控制实验设计。这一资源紧密结合了当前法律科技(LegalTech)与自然语言处理交叉领域的热点事件,如欧盟数字转型议程和ALIA项目对西班牙语大语言模型的本土化推动。通过结构化质量控制与基于LLM的过滤流程,该数据集显著提升了模型在法律文书理解、行政推理及规范化输出方面的能力,为构建可信、可控的法律AI助手奠定了数据基石,对促进西班牙语法律服务的智能化与普及化具有深远意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

