
lintonsui/treatment_val
收藏搜集汇总
数据集介绍
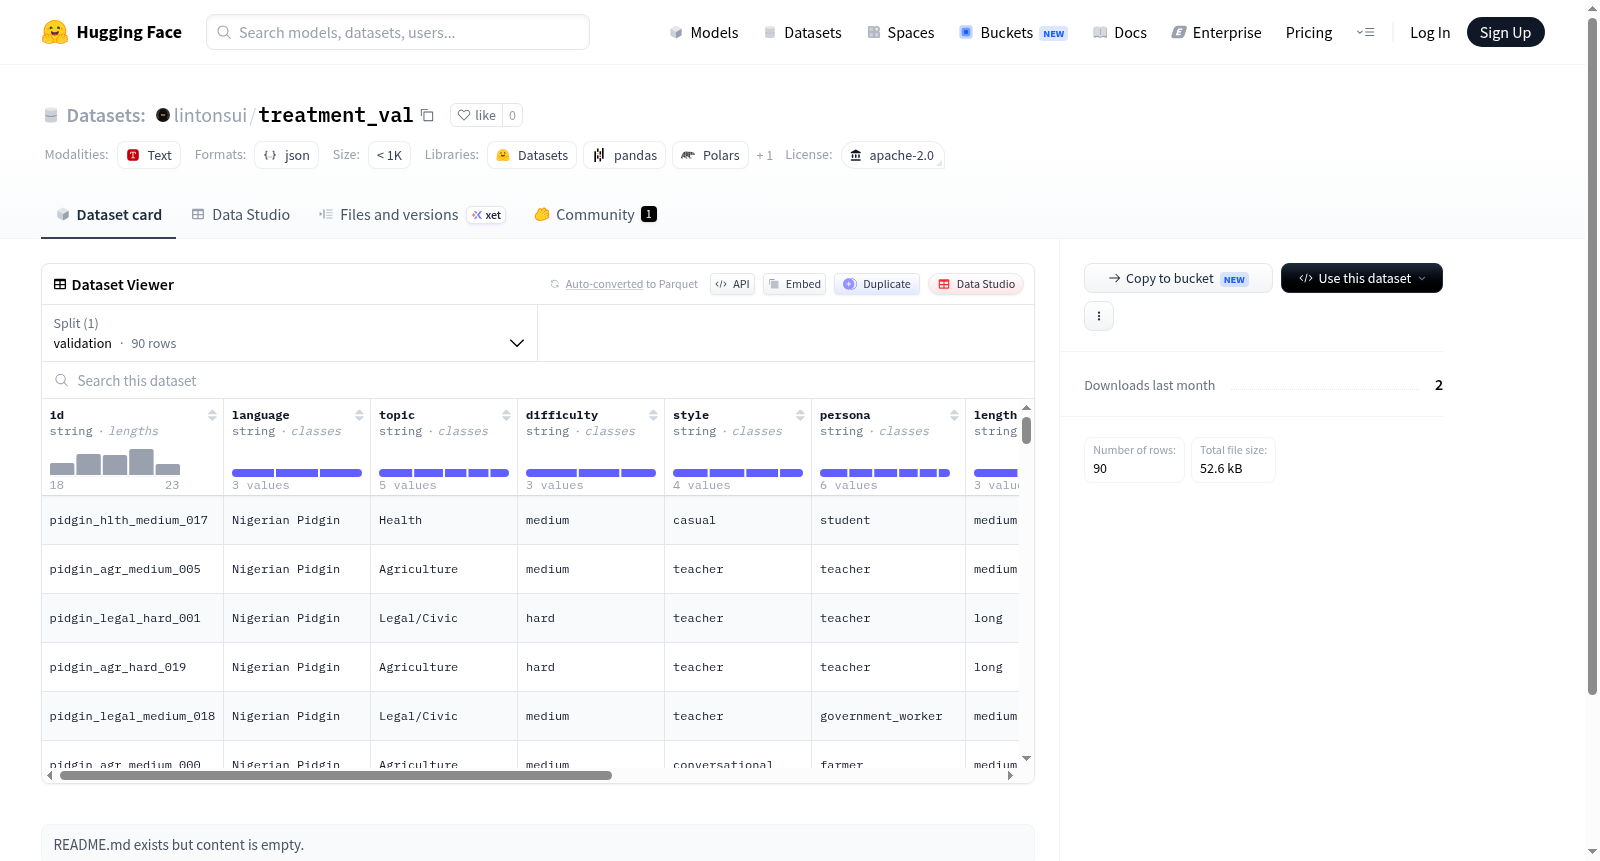
构建方式
treatment_val数据集的构建基于Apache-2.0开源许可协议,确保了其在学术与工业场景中的广泛可用性与法律合规性。该数据集专注于治疗领域,可能通过整合临床文献、电子健康记录或标准化医疗术语库,经专家标注与清洗后形成结构化资源。其构建过程遵循数据隐私保护与伦理规范,适用于治疗效果的验证与模型评估。
使用方法
使用该数据集时,用户可直接通过HuggingFace Datasets库加载,借助标准接口进行数据分割、特征提取与批处理。推荐将其作为治疗相关NLP任务的验证集,评估模型在诊断推荐、方案匹配等子任务上的泛化能力。开发者可结合Apache-2.0许可发布衍生作品,但需保留原始版权声明。数据预处理需注意标签格式一致性,可参考社区示例代码快速入门。
背景与挑战
背景概述
treatment_val数据集诞生于近期,由研究团队构建,旨在为医疗领域的治疗方案评估提供标准化的验证基准。随着精准医疗和人工智能在临床决策支持中的深入应用,如何系统性地评估不同治疗策略的有效性与安全性成为核心研究问题。该数据集通过整合患者特征、治疗干预与结果变量,为模型验证提供了结构化数据资源,有望推动治疗推荐系统的可重复性研究与临床可解释性发展。
当前挑战
该数据集所解决的领域问题主要围绕治疗方案的个性化评估与泛化能力验证,挑战在于医疗数据固有的稀疏性与异质性导致模型难以捕捉复杂治疗效应。构建过程中,数据标注的一致性难以保证,不同来源的临床记录存在术语差异与缺失值问题,增加了数据清洗与标准化的难度。此外,隐私保护与数据安全法规限制了原始数据的共享与复用,使得构建大规模、高质量的治疗验证数据集面临伦理与技术双重障碍。
常用场景
经典使用场景
在医疗健康与因果推断交叉的研究领域中,treatment_val数据集构建了一个用于评估治疗效果估计方法的标准基准。研究者通常借助该数据集验证因果效应识别算法在观测数据上的表现,特别是在处理混杂变量、选择偏差以及反事实推理等挑战性任务时。它常作为对照实验的验证集,用以检验不同模型在平均处理效应(ATE)或条件平均处理效应(CATE)估计上的准确性与鲁棒性,是因果机器学习方法开发中不可或缺的测试平台。
解决学术问题
该数据集的引入有效攻克了因果推断研究中长期存在的评估困境——在真实观测数据中缺乏反事实真值。通过提供明确标记的治疗分配与潜在结果,treatment_val使得研究者能够客观量化不同因果效应估计方法的偏差与方差,从而推动了对双稳健估计、倾向得分匹配、逆概率加权以及元学习器等前沿技术的系统性比较与改进。这一基准的建立,为验证理论创新在复杂现实场景中的有效性提供了关键手段,促进了因果推理从理论至实践的可信跨越。
实际应用
在实际医疗场景中,treatment_val数据集可模拟临床决策支持系统的核心验证环节,精准评估不同疗法对患者预后的差异影响。例如,它被用于训练与测试个性化治疗推荐算法,帮助医生在众多可选方案中甄别出对特定患者群体最有效的干预措施。此外,在药物疗效监测、公共卫生政策评估以及精准医疗方案优化等任务中,该数据集作为因果效果评估的可靠参考,能有效降低因不可观测混杂因素导致的决策风险,提升医疗资源配置的科学性与公平性。
数据集最近研究
最新研究方向
治疗数据集(treatment_val)作为生物医学领域的重要资源,正为精准医疗与个性化治疗方案的研究提供坚实的数据基础。在肿瘤学中,该数据集被广泛用于验证新型靶向药物与免疫治疗组合的疗效,尤其是在转录组学与临床结局关联分析中展现出关键作用。近期研究倾向于利用该数据集构建多模态融合模型,将基因表达谱与患者表型数据结合,以提升治疗反应预测的准确性。此外,随着大规模语言模型在医疗领域的渗透,treatment_val也被用于微调领域专用模型,以辅助临床决策。其开放许可协议(Apache 2.0)进一步加速了跨机构协作,推动了从实验室到临床的转化研究,为攻克耐药性及罕见病治疗提供了可复现的基准。
以上内容由遇见数据集搜集并总结生成


