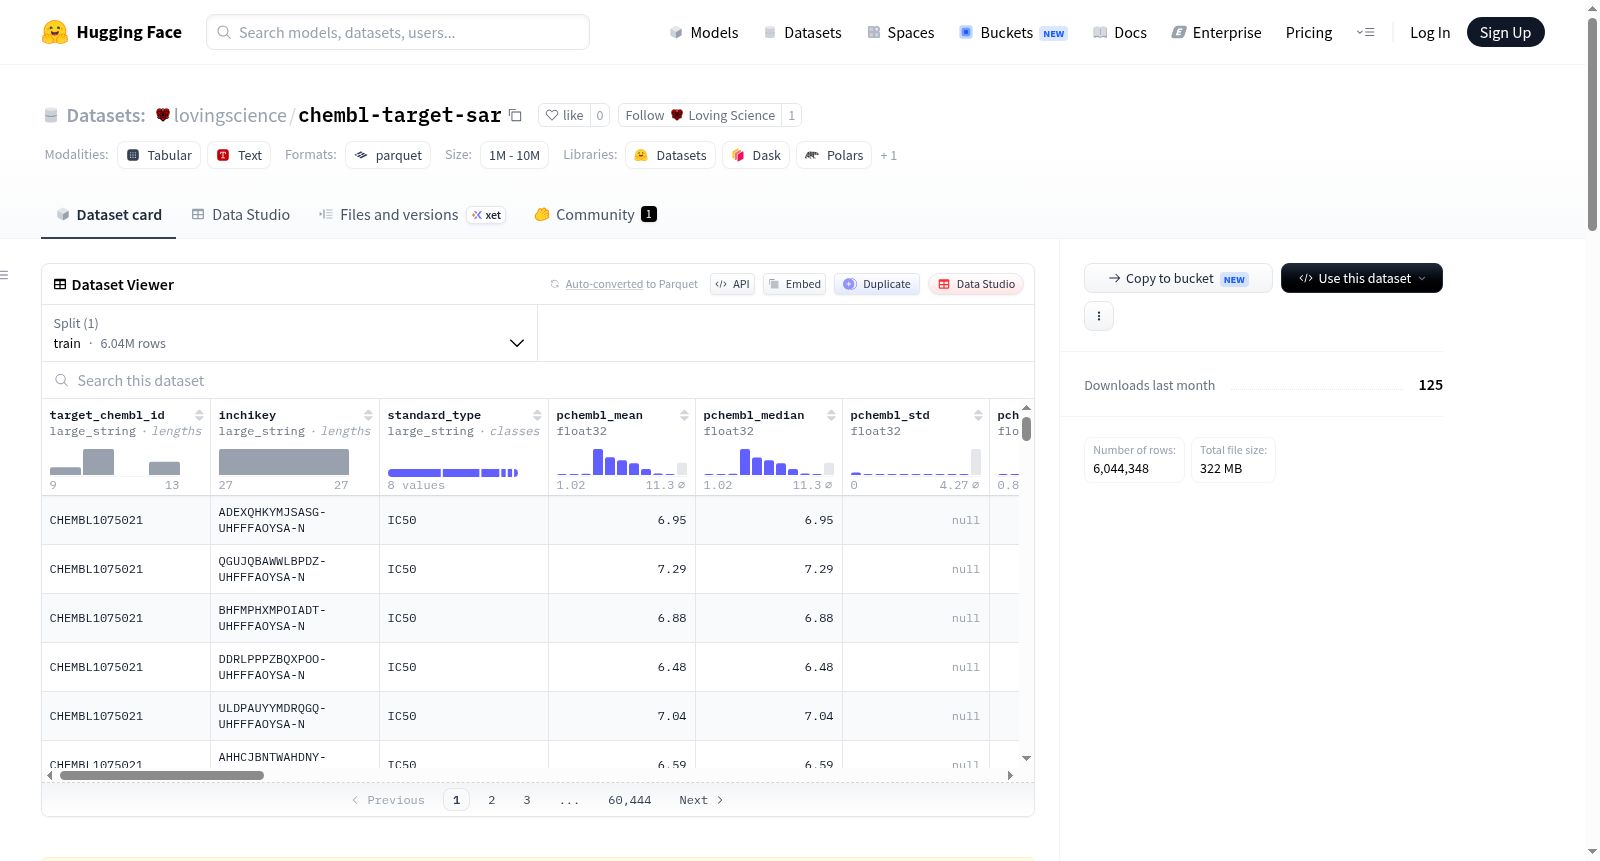
chembl-target-sar
收藏资源简介:
该数据集是基于ChEMBL Release 37构建的向量化、聚合的结构-活性关系(SAR)矩阵,旨在将目标-配体对与其主要生物活性值和分类边界关联起来。数据集中包含3,022,174对独特的靶标-配体对,其中活性测量值(active_measured)有2,618,182条,非活性(inactive)有379,604条,截尾高活性(active_censored)有24,388条。主要端点选择层次为:Kd > Ki > IC50 > EC50 > AC50,每个对选取最高置信度的端点。活性分类规则:active_measured为精确测量值;inactive表示结构关系大于10 µM(pChemBL <= 5.0);active_censored表示结构关系小于1 nM(pChemBL >= 8.0)。数据集包含丰富的字段:目标ChEMBL ID、标准化InChIKey、标准InChIKey、规范SMILES、分子ChEMBL ID、主要端点类型、活性分类、pChemBL统计量(均值、中位数、标准差、最小值、最大值、上下截尾边界)、测量次数、目标类型、单蛋白标志、目标注释(生物体、UniProt登录号、首选名称)以及计算分子描述符(分子量、logP、氢键供体/受体数量、极性表面积、QED)。该数据集适用于药物发现中的SAR分析、活性预测模型训练、目标-配体关系挖掘等任务。
This dataset is a vectorized and aggregated structure-activity relationship (SAR) matrix built from ChEMBL Release 37, designed to associate target-ligand pairs with their primary bioactivity values and classification boundaries. It contains 3,022,174 unique target-ligand pairs, including 2,618,182 active_measured, 379,604 inactive, and 24,388 active_censored entries. The primary endpoint selection hierarchy is Kd > Ki > IC50 > EC50 > AC50, with the highest confidence endpoint chosen for each pair. Activity classification rules: active_measured indicates precise measured values; inactive indicates structural relationships >10 µM (pChemBL <= 5.0); active_censored indicates structural relationships <1 nM (pChemBL >= 8.0). The dataset includes rich fields: target ChEMBL ID, standardized InChIKey, standard InChIKey, canonical SMILES, molecule ChEMBL ID, primary endpoint type, activity classification, pChemBL statistics (mean, median, standard deviation, min, max, upper/lower censoring boundaries), measurement count, target type, single protein flag, target annotations (organism, UniProt accession, preferred name), and computed molecular descriptors (molecular weight, logP, H-bond donors/acceptors, polar surface area, QED). This dataset is suitable for SAR analysis in drug discovery, activity prediction model training, and target-ligand relationship mining.
数据集概述
基本信息
- 数据集名称:Aggregated ChEMBL Target-SAR Matrix
- 数据集版本:基于 ChEMBL Release 37
- 规模:包含 3,022,174 个独特的靶点-配体对
数据来源与构建规则
- 来源:ChEMBL 数据库第 37 版
- 主端点选择层级:
Kd>Ki>IC50>EC50>AC50,每个靶点-配体对选择置信度最高的端点
活性分类统计
| 活性类别 | 数量 |
|---|---|
| active_measured(精确测量) | 2,618,182 |
| inactive(> 10 µM,pChemBL ≤ 5.0) | 379,604 |
| active_censored(< 1 nM,pChemBL ≥ 8.0) | 24,388 |
主要端点分布
| 主要端点 | 数量 |
|---|---|
| IC50 | 1,254,639 |
| Potency | 883,939 |
| Ki | 456,365 |
| EC50 | 146,413 |
| AC50 | 145,722 |
| Kd | 134,648 |
| ED50 | 411 |
| XC50 | 37 |
单蛋白靶点
- 具有至少一个置信度-9(confidence-9)测量的配对:2,217,209(占 73.4%)
- 筛选单蛋白靶点应使用
target_type == SINGLE PROTEIN字段,而非is_single_protein(后者表示配对层面的检测置信度)
列结构说明
- 标识字段:
target_chembl_id、molecule_chembl_id、inchikey、standard_inchikey、canonical_smiles - 活性字段:
primary_endpoint、activity_class - pChemBL 统计字段:
pchembl_mean、pchembl_median、pchembl_std、pchembl_min、pchembl_max、pchembl_lower_bound、pchembl_upper_bound - 检测数量:
n_measurements(uint32) - 靶点注释字段:
target_type、is_single_protein、target_organism、uniprot_accession、target_pref_name - 分子描述符字段:
mw_freebase、alogp、hba、hbd、psa、qed