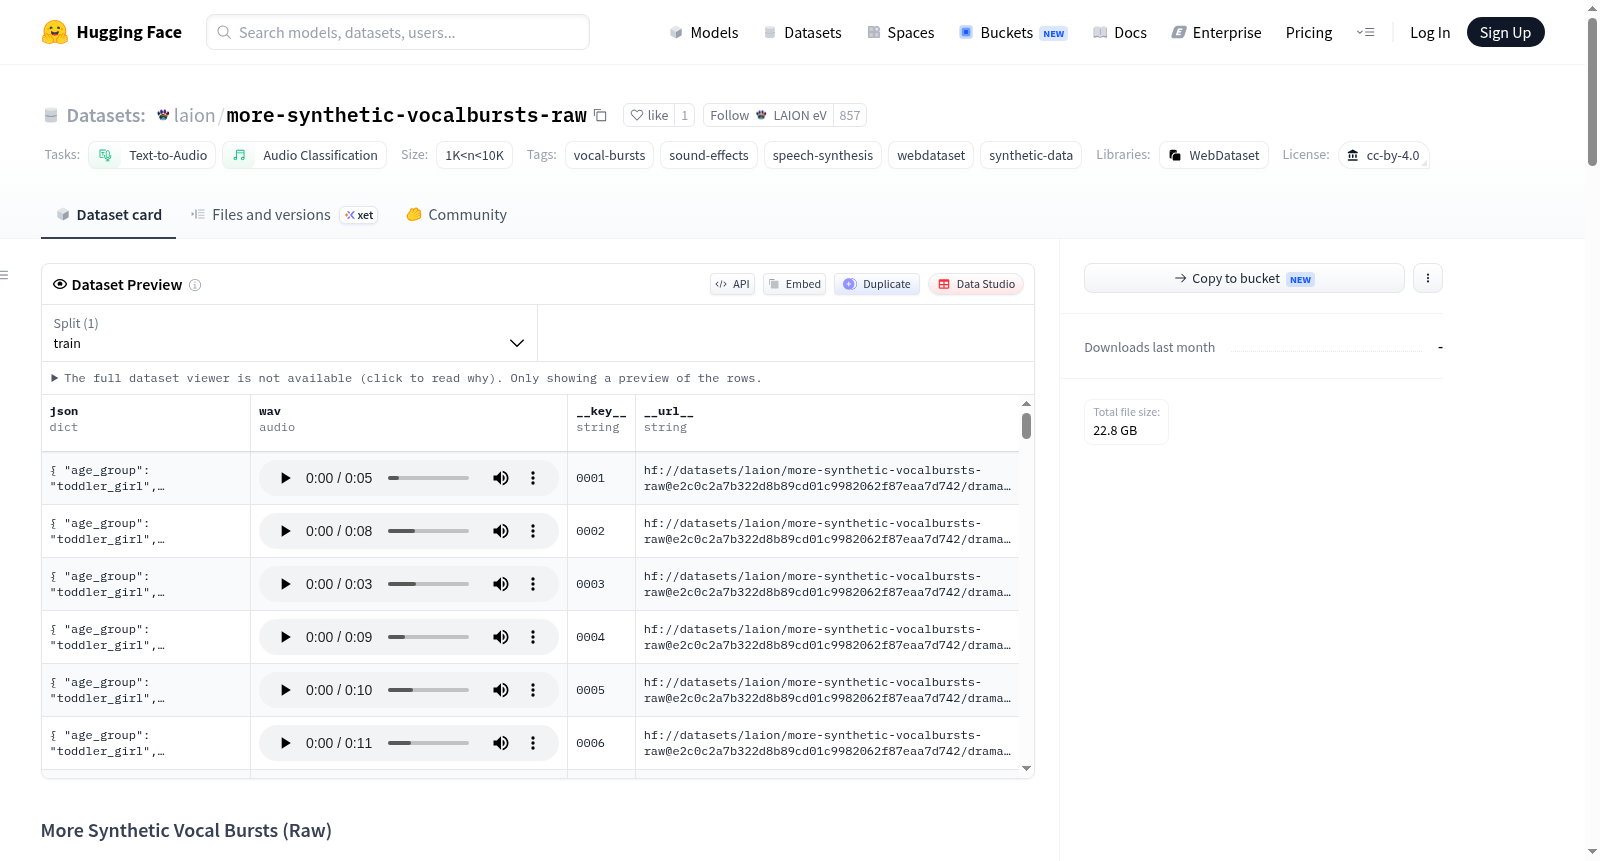
more-synthetic-vocalbursts-raw
收藏资源简介:
该数据集名为More Synthetic Vocal Bursts (Raw),是一个包含合成人声爆发音频样本的集合。这些样本由三种不同的文本到音频和TTS模型(DramaBox、Stable Audio 3 Small SFX、MOSS SoundEffect v2.0)生成,基于一个涵盖202种人声爆发类型的分类法。每个样本是短时(3-10秒)的非语音人声,如笑声、哭声、喘息声、叹息声、咆哮声等,通过描述爆发类型、性别和年龄组的文本提示生成。数据集总样本量超过4781个,其中DramaBox和SA3各2000个,MOSS为781个。所有输出还提供了经过NVIDIA RE-USE(9.6M参数语音增强模型)处理的增强版本。数据以WebDataset的.tar格式组织,每个分片包含.wav音频文件和对应的.json元数据文件。元数据包括样本ID、提示词、时长、性别、年龄组、人声爆发类型键和详细描述。样本覆盖10个人口统计组(男/女,从幼儿到中年)。人声爆发分类法包含23个类别,如笑声、哭泣、呼吸、惊讶、厌恶、疼痛、努力、沟通信号等,其中包含22种NSFW类型。数据集适用于文本到音频生成研究、语音合成、声音效果生成、音频分类和情感计算等任务。数据集采用CC-BY-4.0许可证。
The dataset is named More Synthetic Vocal Bursts (Raw), a collection of synthetic vocal burst audio samples. These samples are generated by three different text-to-audio and TTS models (DramaBox, Stable Audio 3 Small SFX, MOSS SoundEffect v2.0) based on a taxonomy covering 202 vocal burst types. Each sample is a short (3-10 seconds) non-speech vocalization, such as laughter, crying, gasps, sighs, growls, etc., generated through text prompts describing the burst type, gender, and age group. The total sample size exceeds 4781, with 2000 each from DramaBox and SA3, and 781 from MOSS. All outputs also include enhanced versions processed by NVIDIA RE-USE (a 9.6M-parameter speech enhancement model). The data is organized in WebDataset .tar format, with each shard containing .wav audio files and corresponding .json metadata files. Metadata includes sample ID, prompt, duration, gender, age group, vocal burst type key, and detailed description. Samples cover 10 demographic groups (male/female, from toddlers to middle-aged). The vocal burst taxonomy includes 23 categories, such as laughter, crying, breathing, surprise, disgust, pain, exertion, communication signals, etc., with 22 NSFW types included. The dataset is suitable for tasks like text-to-audio generation research, speech synthesis, sound effect generation, audio classification, and affective computing. It is licensed under CC-BY-4.0.
数据集概述:More Synthetic Vocal Bursts (Raw)
这是一个合成声音爆发(Vocal Burst)音频数据集,包含使用多种文本到音频(TTS/Text-to-Audio)模型生成的、涵盖202种类别的声音样本,如笑声、哭声、喘息、叹息、怒吼等非言语发声。
- 许可协议:CC-BY-4.0
- 任务类别:文本到音频、音频分类
- 标签:vocal-bursts, sound-effects, speech-synthesis, webdataset, synthetic-data
- 样本数量:1000到10000之间
生成模型
数据集样本由三种不同模型生成,并提供了经NVIDIA RE-USE增强的版本:
| 模型 | 类型 | 样本数 | 采样率 | 备注 |
|---|---|---|---|---|
| DramaBox (ResembleAI/Dramabox) | TTS DiT | 2000 | 44.1 kHz | cfg=2.5, stg=1.5, 30步 |
| Stable Audio 3 Small SFX (cocktailpeanut/stable-audio-3-small-sfx) | 文本到音频 | 2000 | 44.1 kHz | 8步, cfg_scale=1.0 |
| MOSS SoundEffect v2 (OpenMOSS-Team/MOSS-SoundEffect-v2.0) | 文本到音频 DiT 1.3B | 781 | 48 kHz | 100步, cfg_scale=4.0 |
所有输出均提供经NVIDIA RE-USE(9.6M参数语音增强模型)处理后的增强版本,分别存放在 *-reuse 目录中。
数据集结构
数据以WebDataset .tar 格式存储,每个分片包含成对的 .wav(音频)和 .json(元数据)文件。目录结构如下:
dramabox/(2000样本,4分片)sa3/(2000样本,4分片)moss/(781样本,2分片)dramabox-reuse/(2000样本,4分片)sa3-reuse/(2000样本,4分片)moss-reuse/(781样本,2分片)nsfw/(每模型变体78个样本,含原始与增强版本)
元数据格式
每个 .json 文件包含以下字段:
id: 样本编号prompt: 生成提示文本duration_s: 音频时长(秒)gender: 性别(male/female)age_group: 年龄组(如 teenage_girl、young adult man 等)vocal_burst_key: 声音爆发类型键(如 belly_laugh)vocal_burst_description: 声音爆发描述
分类体系(Taxonomy)
共涵盖202种声音爆发类型,按类别组织,主要类别包括:
- 笑声(8种):如 belly laugh, chuckle, giggle
- 哭泣与痛苦(10种):如 sobbing, whimpering, wailing
- 呼吸与叹息(11种):如 heavy panting, exasperated sigh
- 惊讶与震惊(6种):如 startled yelp, dramatic gasp
- 厌恶与不赞同(8种):如 retching, scoff, tsk
- 疼痛与不适(8种):如 sharp yelp, prolonged groan
- 努力与用力(8种):如 heavy lifting grunt, battle cry
- 交流信号(11种):如 shush, psst, wolf whistle
- 吃喝(6种):如 slurping, lip smacking
- 睡眠与无意识(5种):如 snoring, sleep talking
- 动物模仿(6种):如 growling, purring, hissing
- 音乐与节奏(7种):如 humming, beatboxing
- 紧张与焦虑(7种):如 nervous laughter, teeth chattering
- 年龄相关(6种):如 baby cooing, elderly wheeze
- 身体功能(9种):如 hiccup, sneeze, burp
- 口哨(6种):如 casual whistle, wolf whistle
- 口腔/口音(8种):如 tongue click, teeth sucking
- 喉咙音(7种):如 throat clearing, gargling
- 鼻音(5种):如 sniffling, snorting
- 发声抽搐与反射(6种):如 hiccup, involuntary yelp
- 温度与环境(4种):如 shivering chatter, heat exhaustion panting
- 表达性感叹(7种):如 eureka exclamation, frustrated argh
- NSFW(22种):成人内容相关亲密发声
SFW版本(180种,已移除NSFW)可在 Voice-Acting-Pipeline 仓库 中找到。
人口统计学分布
样本覆盖10个年龄/性别组:
- 女性:toddler girl, pre-puberty girl, teenage girl, young adult woman, middle-aged woman
- 男性:toddler boy, pre-puberty boy, teenage boy, young adult man, middle-aged man
使用示例(Python)
使用WebDataset加载数据,通过 soundfile 和 io 解析音频与元数据:
import webdataset as wds import soundfile as sf import io
dataset = wds.WebDataset("dramabox/shard-{0000..0003}.tar") for sample in dataset: audio_bytes = sample["wav"] metadata = json.loads(sample["json"]) audio, sr = sf.read(io.BytesIO(audio_bytes)) print(f"{metadata[vocal_burst_key]} - {metadata[gender]} - {sr}Hz - {len(audio)/sr:.1f}s")
相关资源