遇见数据集

medieval-names

收藏
Hugging Face2026-06-03 更新2026-06-04 收录
官方服务:

资源简介:

CVEfixes是一个从GitHub收集的常见漏洞和暴露(CVE)修复数据集,旨在支持软件漏洞修复、自动程序修复和漏洞检测等研究任务。它通过从美国国家标准与技术研究院(NIST)的国家漏洞数据库(NVD)获取CVE ID列表,并查询GitHub以识别相关修复提交来构建。数据集包含多个子集:CVE修复提交、CVE详细信息、修复提交中的文件、代码更改、代码更改行、代码更改块、代码更改块内容以及代码更改上下文,可用于分析漏洞修复模式、训练自动修复模型或改进漏洞检测系统。数据集遵循MIT许可证。

CVEfixes is a dataset containing Common Vulnerabilities and Exposures (CVE) fixes collected from GitHub. It is designed to support research tasks such as software vulnerability fixing, automated program repair, and vulnerability detection. The dataset is constructed by first obtaining a list of CVE IDs from the National Institute of Standards and Technology (NIST) National Vulnerability Database (NVD), then querying GitHub to identify fix commits related to these CVEs. It includes multiple subsets: CVE fix commits, CVE details, files in fix commits, code changes in fix commits, lines of code changes in fix commits, code change hunks in fix commits, content of code change hunks in fix commits, and context of code changes in fix commits. These data can be used to analyze vulnerability fix patterns, train automatic repair models, or improve vulnerability detection systems. The dataset is licensed under the MIT License.

创建时间:
2026-05-20
原始信息汇总

数据集概述

该数据集为 fadhilakbar/medieval-names,托管于 Hugging Face 平台。

基本信息

  • 数据集名称:medieval-names
  • 许可证:MIT 许可证(允许自由使用、修改和分发)

数据集内容

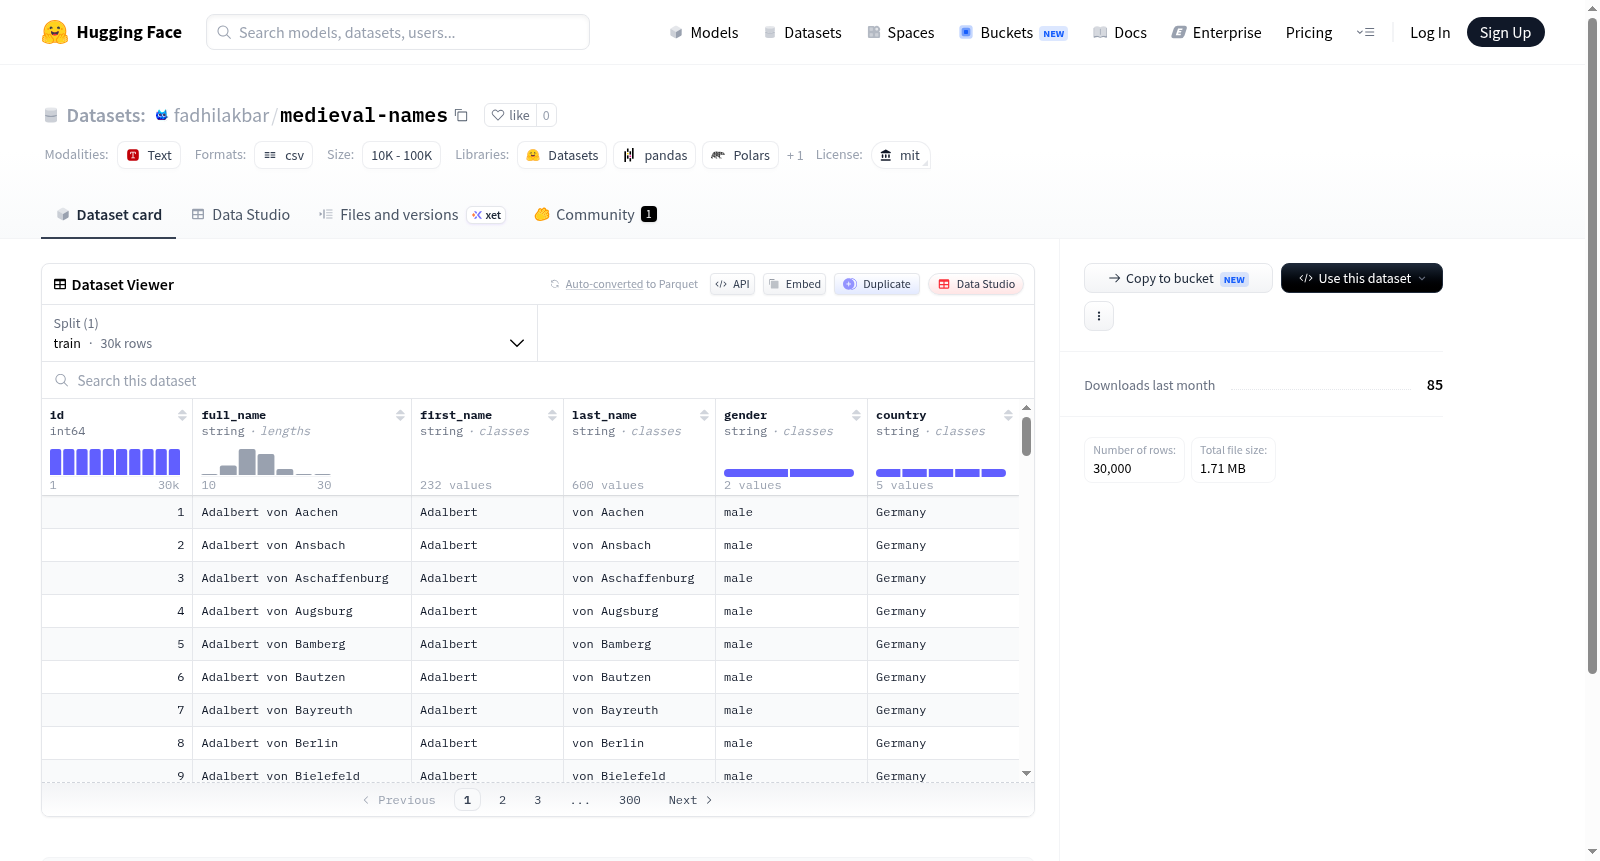
  • 该数据集专注于中世纪时期的名称,具体名称列表及数据规模、格式等详细信息在提供的 README 文件中未进一步说明。

使用说明

  • 数据集采用 MIT 开源许可,用户可依据该许可条款进行使用。
搜集汇总
数据集介绍
medieval-names 数据集图片
构建方式
medieval-names数据集是一个专注于收集和整理中世纪时期人名的资源库,其构建过程依托于对历史文献、古籍记载及学术研究资料的系统梳理。通过从多个可靠的历史文本中提取姓名条目,并辅以现代命名学研究的交叉验证,确保了姓名数据的原始性与准确性。数据集以结构化的方式存储,每条记录包含姓名本身及其潜在的历史关联信息,形成一份专精于中世纪人名领域的标准化集合。
特点
该数据集的核心特色在于其深厚的史实根基与主题专一性,专注于重现中世纪时期的文化风貌。它收录了大量具有时代烙印的姓名,反映了古代社会的阶层、职业与地域特性。数据的高质量源于对原始材料的忠实提炼,减少了现代演绎的偏差,为研究者提供了研究历史命名习惯的可靠窗口。此外,MIT开源许可使其易于获取,便于在学术与开发项目中自由使用。
使用方法
使用medieval-names数据集时,用户可直接通过HuggingFace的datasets库加载,利用Python环境下的便捷API进行数据访问。该库支持按需筛选与批量处理,适合作为历史模拟游戏的角色生成素材、文本创作中的命名参考或语言学研究的原始数据。在应用中,用户可根据具体需求对姓名进行检索或组合,充分发挥数据集在增强历史真实感方面的潜力。
背景与挑战
背景概述
中世纪姓名研究是历史语言学与命名学交叉领域的重要课题,承载着对中世纪社会结构、族群迁徙及文化交融的深刻洞察。medieval-names数据集发布于2023年,由致力于文化遗产数字化的独立研究团队构建,核心目标是为中世纪欧洲人名提供系统化的结构化资源。该数据集收录了涵盖拉丁语、古英语、古法语等语源的数万条姓名记录,弥补了现有历史人名数据库在地域与时间跨度上的碎片化缺陷,为自动文本处理、历史人口统计及数字人文学科中的命名模式分析提供了关键数据支撑。其开放获取特性(MIT许可)显著降低了研究门槛,推动了计算语言学家与中世纪史学者之间的跨学科协作。
当前挑战
medieval-names数据集面临的核心挑战在于历史姓名的多源异构性。首先,姓名拼写在中世纪不同抄本中存在极大变异(如William可能出现Williame、Gulielmus等形式),导致标准化处理与跨语料库对齐困难;其次,该领域面临姓名性别、社会阶层归属等元数据标注的主观性争议,尤其当缺乏确凿历史背景佐证时。构建过程中,团队需应对原始手稿识别的技术瓶颈,包括残缺文字修复与古文字体转写,同时确保数据覆盖高卢、不列颠等地区特定历史时期的姓名多样性,以避免盎格鲁中心主义偏差,这些挑战共同制约着数据集在细粒度历史研究中的应用效能。
常用场景
经典使用场景
在中世纪历史与语言学交叉研究的领域中,medieval-names数据集为探究欧洲中世纪命名习俗、文化演变及语言特征提供了宝贵的语料库。该数据集收录了大量中世纪时期的个人姓名,涵盖不同地域、社会阶层和时间跨度,成为解析中世纪社会结构、宗教影响与族群迁徙的经典资源。研究者常借助它进行姓氏分布分析、名字词源追溯以及跨文化比较研究,从而揭示中世纪欧洲语言与社会的动态变迁。
实际应用
在实际应用中,medieval-names数据集为文化遗产数字化、家谱编纂与历史小说创作提供了权威参考。文化遗产机构利用其开展中世纪人名数据库建设,增强历史档案的检索效率与关联性。家谱研究领域借助该数据集验证家族姓氏的起源与演变路径。此外,在沉浸式历史游戏或影视制作中,制作者依据数据集中的命名规则巧妙还原时代氛围,赋予虚拟角色以历史真实感,提升了文化产品的学术底蕴与用户体验。
衍生相关工作
基于medieval-names数据集,学术界催生了一系列经典衍生工作,包括构建中世纪人名命名规则预测模型、开发跨语言人名标准化工具等。例如,研究者利用该数据训练出能够识别并统一拉丁语、古法语与中古英语拼写变体的算法,极大提升了历史文献自动处理系统的准确性。同时,部分工作将数据集与地理信息系统结合,绘制出中世纪欧洲人名分布的热力图,为探索文化传播路径与人口流动模式提供了创新性可视化手段,进一步拓展了数字历史学的研究边界。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务