
QCRI/Fanar-Sadiq-Classifier-Datasets
收藏官方服务:
资源简介:
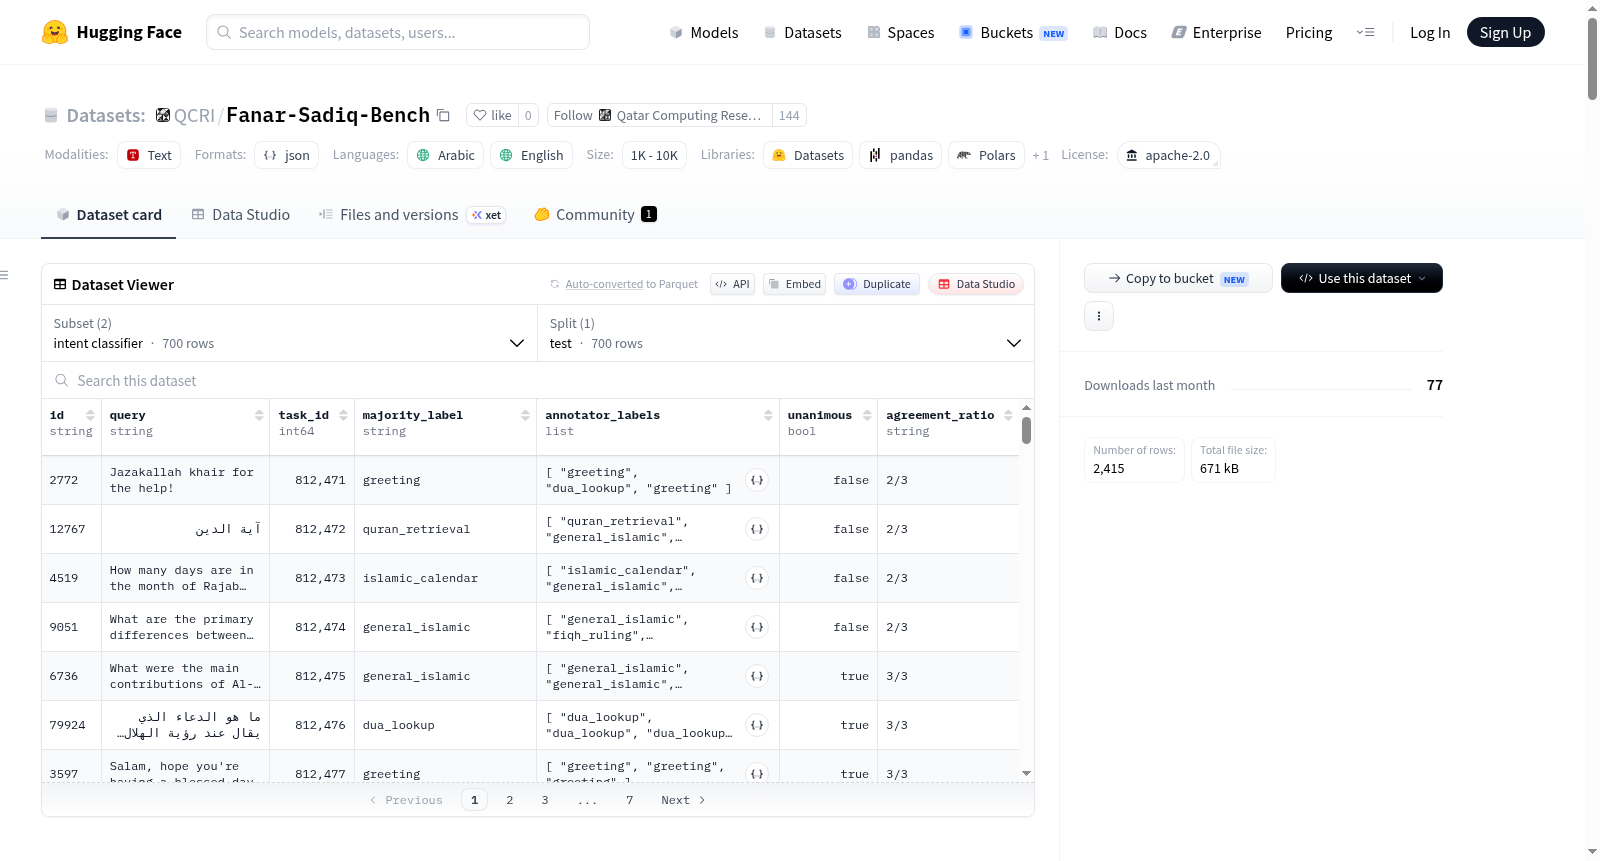
该数据集包含两个子集:意图分类器和提示分类器,分别用于意图分类和提示分类任务。数据以JSONL格式存储,支持阿拉伯语和英语两种语言,样本数量在1千到1万之间。
This dataset contains two subsets: intent classifier and prompt classifier, used for intent classification and prompt classification tasks respectively. The data is stored in JSONL format, supports Arabic and English languages, and has a sample size between 1K and 10K.
提供机构:
QCRI搜集汇总
数据集介绍
构建方式
该数据集源于《Fanar-Sadiq: A Multi-Agent Architecture for Grounded Islamic QA》一文,旨在支撑伊斯兰问答系统中查询路由组件的分类需求。数据集包含两个子集:Prompt分类器从真实用户查询中筛选出约1.72k条,以二分类方式区分伊斯兰内容与非伊斯兰内容;Intent分类器则通过三位独立标注者对700条匿名用户查询进行多数投票,最终形成九类细粒度伊斯兰意图标签,并记录了标注一致性比例与是否达成一致的信息。
特点
数据集兼具双语性与任务多样性,涵盖阿拉伯语与英语的自然表达、代码切换、长句与短句、事实性与教法性查询,以及工具导向型请求。Prompt分类器聚焦伊斯兰查询的二元判定,而Intent分类器则细致区分了教法裁决、古兰经检索、天课计算、遗产分配、祈祷词查询、礼拜时间、伊斯兰历法等九类意图,为多智能体系统中的精准路由提供结构化支撑。
使用方法
用户可通过Hugging Face的datasets库直接加载该数据集,分别以'intent classifier'和'prompt classifier'配置名获取测试集。典型用法包括训练或评估模型以判断用户查询是否属于伊斯兰领域、识别其特定意图类别,进而路由至检索增强型问答、确定性计算工具或结构化组件。数据集附带基线任务示例,支持二分类与多类别文本分类的标准化实验流程。
背景与挑战
背景概述
Fanar-Sadiq-Classifier-Datasets 是由卡塔尔计算研究所(QCRI)的 Ummar Abbas、Mourad Ouzzani 等多位研究人员于2026年发布的 bilingual 阿拉伯语/英语查询分类数据集,与发表于 ACL 2026 的论文《Fanar-Sadiq: A Multi-Agent Architecture for Grounded Islamic QA》相伴而生。该数据集旨在支持 Fanar-Sadiq 多智能体伊斯兰问答系统的路由组件,核心研究问题聚焦于如何通过精确的查询分类将用户请求高效路由至检索增强式伊斯兰问答、古兰经检索、杜阿查询、礼拜时间计算、伊斯兰日历、天课计算及遗产计算等专用模块。作为首个面向伊斯兰领域多智能体系统的公开分类基准,该数据集为宗教信仰领域的自然语言处理研究提供了关键资源,推动了阿拉伯语与英语文本分类、跨语言查询路由及工具增强型问答系统的发展。
当前挑战
该数据集面临的领域挑战主要表现为:伊斯兰查询分类需处理涵盖法律裁决、古兰经检索、一般知识、问候、天课计算、遗产计算、杜阿查询、伊斯兰日历及礼拜时间等九类细粒度意图,且查询常包含阿拉伯语与英语的语码混合、自然口语化表达及工具导向需求,对模型的多语言理解与语义区分能力构成严峻考验。构建过程中的挑战则包括:从真实用户查询中匿名化收集数据时需严格去除个人身份信息以保护隐私;每一条查询需由三位独立标注者进行标注,通过多数投票确定最终标签,但部分查询因标注者分歧(如仅达2/3一致率)而被丢弃,导致数据规模受限(意图分类仅700条);同时,伊斯兰法律问题常涉及学派差异、地域习俗及上下文细节,简单分类难以完全反映查询的真实意图,容易引发路由误差。
常用场景
经典使用场景
在伊斯兰领域智能问答系统的构建中,该数据集被经典地用于训练和评估查询分类与路由模块。具体而言,Prompt Classifier子集负责二分类任务,区分用户查询是否涉及伊斯兰内容,从而决定将请求导向宗教专用系统还是通用助手;而Intent Classifier子集则执行细粒度意图分类,将伊斯兰查询精确地路由至教法裁决、古兰经检索、遗产计算、祈祷时间查询等九个专业化组件。这种双层级分类架构支撑了多智能体系统的高效协作,是面向领域知识问答的典型应用范式。
解决学术问题
该数据集直接回应了宗教领域智能系统中查询理解与任务路由这一核心学术难题。传统单一流水线问答模型难以处理伊斯兰知识的多元性,例如教法问题需推理检索、遗产问题需结构化计算、历法查询需确定性函数调用。该数据集通过构建双语(阿拉伯语/英语)标注的意图分类体系,促使研究者探索非线性、多模态的路由策略,解决了从自然语言查询到异构工具组件映射的挑战。其意义在于为跨语言、跨任务的宗教域推理提供了标准化评测基准,推动了多智能体架构在垂直领域落地的方法论创新。
衍生相关工作
该数据集催生了多项宗教领域自然语言处理的衍生研究,包括基于大语言模型的零样本意图检测、小样本跨语言分类、以及多智能体一致性路由算法。通过分析标注者之间的分歧(例如2/3多数一致与3/3全票一致),研究者发展出置信度感知的拒斥机制,用于处理歧义查询。此外,该数据集推动了伊斯兰数字人文学科的发展,如构建教法判决知识图谱时,利用其意图标签进行实体与关系的自动抽取。相关工作已扩展至其他亚伯拉罕宗教领域的问答系统路由设计,形成了跨领域迁移学习的验证基准。
以上内容由遇见数据集搜集并总结生成


