
遇见数据集

SakanaAI/lm-wheels

收藏
Hugging Face2026-05-28 更新2026-05-10 收录
官方服务:

资源简介:

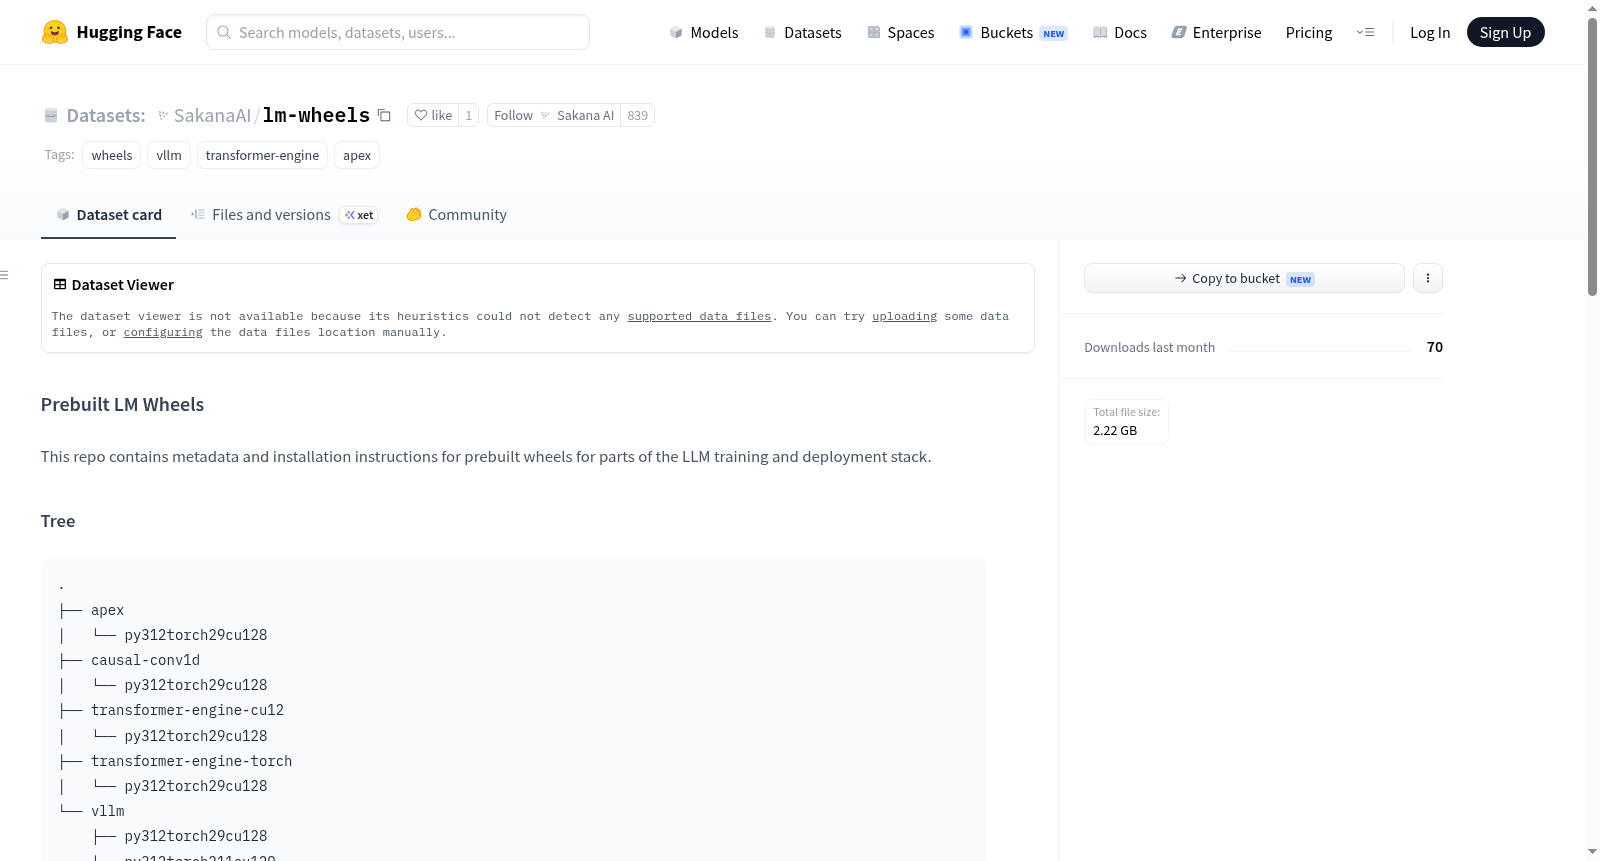
该数据集是一个预构建语言模型(LM)轮子(wheels)的仓库,包含用于LLM训练和部署堆栈的多个软件包的预编译安装文件。它提供了针对不同环境配置(如Python 3.12、Torch 2.9/2.11、CUDA 12.8/12.9)的轮子,涵盖apex、causal-conv1d、transformer-engine-cu12、transformer-engine-torch和vllm等包。数据集的结构以子文件夹组织,每个子文件夹对应特定包和环境组合,并附有详细的安装指令。其主要目的是简化这些软件包的安装过程,支持用户在特定环境下快速部署LLM相关工具。

This dataset is a repository of prebuilt language model (LM) wheels, containing precompiled installation files for various packages in the LLM training and deployment stack. It offers wheels for different environment configurations, such as Python 3.12, Torch 2.9/2.11, and CUDA 12.8/12.9, covering packages like apex, causal-conv1d, transformer-engine-cu12, transformer-engine-torch, and vllm. The dataset is organized into subfolders, each corresponding to a specific package and environment combination, with detailed installation instructions provided. Its primary purpose is to simplify the installation process of these software packages, enabling users to quickly deploy LLM-related tools in specific environments.
提供机构:
SakanaAI
搜集汇总
数据集介绍
SakanaAI/lm-wheels 数据集图片
构建方式
在深度学习模型快速迭代的背景下,预训练与大语言模型部署所需的底层依赖库往往面临编译复杂、环境兼容性差等挑战。为简化这一流程,构建者将vLLM、Transformer Engine、Apex及causal-conv1d等关键组件的预编译轮子(wheels)按照Python版本(如3.12)、Torch版本(如2.9、2.11)及CUDA版本(如12.8、12.9)进行结构化组织与托管,形成清晰的目录树。每个子文件夹名称以编码形式精确对应目标环境,例如“py312torch29cu128”即代表Python 3.12、PyTorch 2.9与CUDA 12.8的组合,确保用户可依据自身环境快速定位所需包文件。
特点
该数据集的核心特征在于其高度的针对性与实用性。它聚焦于大模型训练与推理链路中若干个编译门槛较高的核心库,通过预编译的方式直接提供适配特定软硬件组合的轮子文件,从而大幅降低环境搭建的时间成本与出错概率。数据集遵循严格的命名规范,每个包的路径明确标识了其适用的Python、PyTorch与CUDA版本,消除了版本兼容性的模糊性。此外,集成的组件覆盖了从模型推理引擎(vLLM)、混合精度训练(Apex)、高效注意力机制(causal-conv1d)到加速库(Transformer Engine)等关键环节,为规模化机器学习工作流提供了完整的底层支持。
使用方法
使用者需首先确认自身环境中Python、PyTorch与CUDA的版本组合,随后在数据集目录树的相应子文件夹中找到对应的轮子文件。安装过程可直接借助pip工具配合指向HuggingFace资源链接的URL完成。例如,若环境为Python 3.12、PyTorch 2.9与CUDA 12.8,则通过访问“vllm/py312torch29cu128”子文件夹下的.whl文件链接,执行“python -m pip install <URL>”命令即可一键安装vLLM。对于Transformer Engine这类包含独立CUDA与Torch组件的库,需同时安装两个关联的轮子文件,命令格式同样简明,无需额外编译步骤,显著提升了部署效率。
背景与挑战
背景概述
lm-wheels数据集由SakanaAI团队于近年创建,旨在解决大型语言模型(LLM)训练与部署栈中关键组件的预编译二进制分发问题。随着LLM技术的迅猛发展,诸如vLLM、Transformer Engine、Apex等底层库的编译安装成为阻碍研究者高效复现与迭代的瓶颈。该数据集系统性收录了针对Python 3.12、PyTorch 2.9、CUDA 12.8等特定环境预构建的wheel包,通过结构化目录组织不同依赖组合,为LLM生态的统一部署提供了标准化方案。其核心研究问题聚焦于消除环境配置差异,降低安装复杂度,从而显著提升LLM相关工具链的可移植性与复用效率,对加速行业内的研究与应用部署具有里程碑意义。
当前挑战
该数据集面临的核心挑战在于LLM领域依赖关系的动态性与碎片化。首先,不同模型架构对vLLM、Transformer Engine等库的版本要求高度耦合,且CUDA与PyTorch的快速迭代导致兼容性矩阵呈指数级增长,难以覆盖所有环境场景。其次,预编译轮子的构建过程本身充满工程挑战,如causal-conv1d等依赖混合了C++与CUDA内核,需针对特定GPU架构进行编译优化,而Apex等库的复杂源码结构常导致构建失败。此外,分发策略需平衡二进制文件大小与下载效率,同时确保在异构硬件上的稳定运行,这些因素共同构成了lm-wheels在构建与维护中亟待攻克的技术壁垒。
常用场景
经典使用场景
在大型语言模型(LLM)的研发与部署领域,计算环境的快速搭建与精准配置始终是制约效率的关键瓶颈。lm-wheels数据集以预编译二进制包(wheels)的形式,为核心组件如vLLM推理引擎、Transformer Engine加速库、Apex混合精度训练工具及Causal-Conv1D因果卷积模块提供即装即用的安装方案。研究者仅需根据Python版本、PyTorch版本及CUDA版本匹配子目录,通过pip命令即可直接获取与当前环境严格兼容的二进制文件,彻底摆脱从源码编译可能带来的依赖冲突与耗时问题,尤其适用于高频迭代的LLM实验场景。
衍生相关工作
围绕lm-wheels数据集衍生的相关工作主要集中在工具链生态优化与自动化构建系统领域。其文件组织方式——通过版本号编码环境特征的目录结构(如py312torch29cu128),为后续的LLM组件索引库(如HuggingFace的模型仓库与数据集目录之间的交叉引用)提供了标准化范例。在此基础上,社区涌现了一批环境感知的包管理辅助工具,它们自动读取系统版本信息并匹配最接近的预编译包。此外,该数据集的设计理念也启发了更广泛的学界工作,包括面向不同GPU架构的二进制矩阵构建策略,以及针对CUDA可微分编程库的预处理分发方案。
数据集最近研究
最新研究方向
聚焦于大语言模型(LLM)训练与部署生态中的基础组件兼容性优化,该数据集通过提供针对特定Python、PyTorch及CUDA版本预编译的wheels包(如vLLM、Transformer Engine、Apex等),显著降低了前沿研究中的环境配置门槛。其最新研究方向紧密围绕加速推理框架(如vLLM)与混合精度训练库(如Transformer Engine)的版本对齐,尤其关注vLLM 0.21.0版本中引入的Sakana工具前缀等定制化功能,体现了对LLM高效推理与模型并行化的前沿探索。该数据集的出现响应了行业内对大模型部署效率与复现性的迫切需求,通过标准化预编译包的形式,推动了LLM研究从实验环境向生产环境的平滑过渡,对加速模型迭代与社区协作具有基础性支撑作用。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

