
natural-qa-random-67-with-AI-search-answers
收藏数据链接:
官方服务:
资源简介:
该数据集是'Natural Questions'数据集的精选子集,经过手动筛选,仅包含高质量的答案。数据集包括被定义为正确、清晰且足以回答给定问题的'好'答案的真实示例。此外,还包含了由三个AI搜索引擎(Perplexity、Gemini、Exa AI)生成的答案,以提供原始和解析后的输出,用于比较和评估。数据集适用于评估AI生成答案的质量、训练生成高质量搜索答案的模型,以及基准测试AI搜索引擎并改进其响应解析能力。
创建时间:
2024-12-10
原始信息汇总
数据集概述
数据集描述
该数据集是“Natural Questions”数据集的精炼子集,经过手动筛选,仅包含高质量答案。数据集包括“好”答案的基准示例,定义为正确、清晰且足以回答给定问题的答案。此外,还包含了三个AI搜索引擎(Perplexity、Gemini、Exa AI)生成的答案,提供了原始和解析后的输出,以便进行比较和评估。
- 语言(NLP): 英语
- 来源数据集: Natural Questions
数据集结构
数据集包含以下字段:
| 字段名称 | 数据类型 | 描述 |
|---|---|---|
url |
string |
问题来源文档的URL。 |
input_text |
string |
原始数据集中的输入问题文本。 |
completion |
string |
Quotient团队标注的基准“好”答案。 |
label |
string |
二进制标签(good),表示答案的质量。 |
feedback |
string |
标注者提供的反馈或理由,解释为什么答案是好的。 |
perplexity_raw |
string |
Perplexity AI生成的原始响应。 |
perplexity_parsed |
string |
从Perplexity的原始响应中提取的解析答案。 |
gemini_raw |
string |
Gemini AI生成的原始响应。 |
gemini_parsed |
string |
从Gemini的原始响应中提取的解析答案。 |
exa_raw |
string |
Exa AI生成的原始响应。 |
exa_parsed |
string |
从Exa的原始响应中提取的解析答案。 |
数据集创建
数据收集和处理
- 数据集源自“Natural Questions”数据集的验证集。
- 仅包含通过手动评估标注为
good的答案。 - 为每个问题生成了三个AI搜索引擎的响应,捕获了原始和解析后的输出。
来源数据生产者
- 原始数据集由Google Research创建。
- 标注由Quotient AI完成。
偏差、风险和限制
建议
用户应注意:
- 数据集可能包含原始“Natural Questions”数据集中的固有偏差。
- “好”答案的定义是主观的,基于手动标注。
引用
@dataset{quotientai_natural_qa_2024, title = {Natural QA with Good Answers and AI Search Engines}, author = {Quotient AI Team}, year = {2024}, publisher = {Hugging Face}, url = {https://huggingface.co/datasets/quotientai/natural-qa-random-100-with-AI-search-answers/ }
搜集汇总
数据集介绍
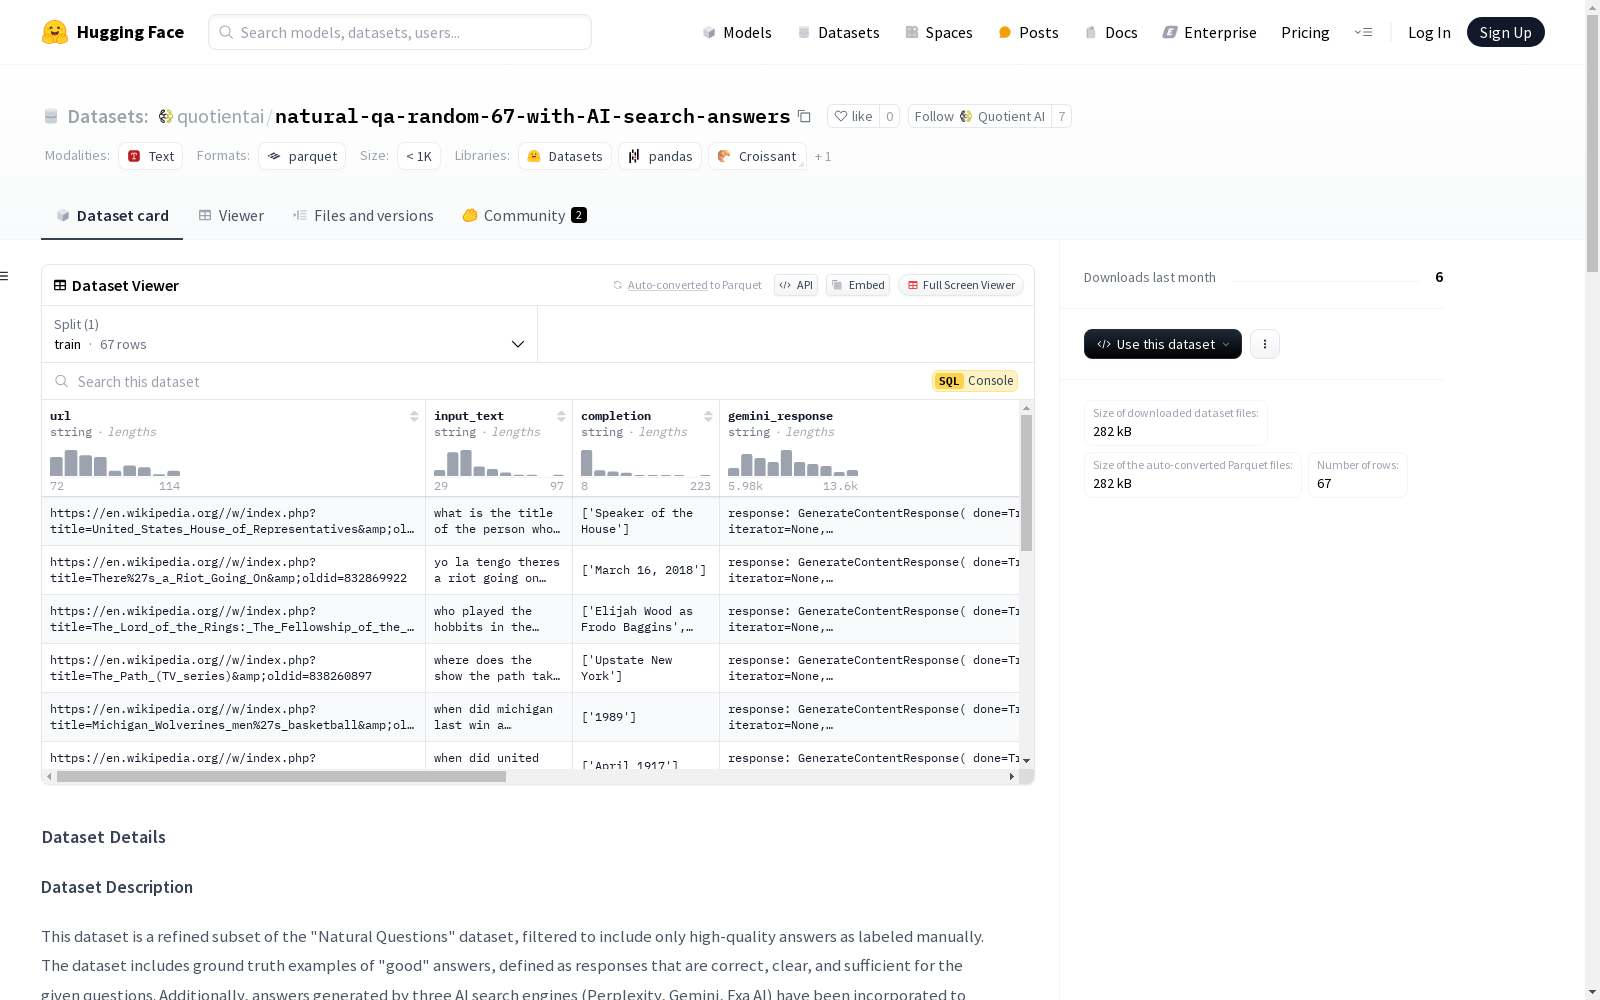
构建方式
该数据集是从‘Natural Questions’数据集的验证部分中精心筛选出的高质量答案子集,由Quotient AI团队手动标注为‘good’答案。此外,数据集还整合了来自三大AI搜索引擎(Perplexity、Gemini、Exa AI)的原始及解析后的答案,以供对比和评估。数据集的构建过程包括从源数据集中提取高质量答案,并为每个问题生成AI搜索引擎的响应,确保了数据的多维度和全面性。
特点
该数据集的显著特点在于其高质量的答案标注和多源AI搜索引擎的响应对比。通过手动筛选和标注,确保了答案的正确性和充分性,同时引入了AI生成的答案,提供了丰富的对比数据。此外,数据集结构清晰,包含问题来源的URL、输入文本、标注答案及AI生成的原始和解析答案,便于进行多维度的分析和评估。
使用方法
该数据集适用于评估AI生成答案的质量,训练基于搜索的高质量答案生成模型,以及对AI搜索引擎的响应解析能力进行基准测试。用户可以通过对比标注答案与AI生成答案的差异,优化模型性能。同时,数据集的结构化设计使得用户可以方便地提取和分析不同来源的答案,从而推动AI搜索引擎的改进和优化。
背景与挑战
背景概述
在自然语言处理领域,高质量问答系统的构建一直是研究的核心目标之一。natural-qa-random-67-with-AI-search-answers数据集由Quotient AI团队精心打造,基于Google Research的'Natural Questions'数据集,经过严格的手动筛选,保留了被标注为'good'的高质量答案。该数据集不仅包含人工标注的正确、清晰且充分的答案,还引入了来自Perplexity、Gemini和Exa AI三个AI搜索引擎的原始及解析后的回答,旨在为问答系统的评估与改进提供可靠的基准。这一数据集的创建时间为2024年,其核心研究问题在于如何通过对比AI生成的答案与人工标注的答案,提升问答系统的准确性与实用性。
当前挑战
该数据集在构建过程中面临多项挑战。首先,如何定义并筛选出'good'答案是一个主观且复杂的过程,依赖于人工标注的准确性。其次,AI搜索引擎生成的答案质量参差不齐,如何有效解析并评估这些答案的正确性与清晰度是一大难题。此外,数据集可能继承了原始'Natural Questions'数据集中的固有偏见,这需要在实际应用中加以注意和纠正。最后,尽管该数据集为问答系统的评估提供了有力支持,但其主观性标注和潜在偏见仍需进一步研究和改进。
常用场景
经典使用场景
该数据集的经典使用场景主要集中在对AI生成答案质量的评估与比较。通过提供高质量的手动标注答案以及来自多个AI搜索引擎(如Perplexity、Gemini和Exa AI)的生成答案,研究者能够系统地评估不同AI系统在回答自然语言问题时的表现。此外,该数据集还可用于训练和优化生成高质量搜索答案的模型,尤其是在需要精确、清晰且充分的回答场景中。
解决学术问题
该数据集解决了在自然语言处理领域中,如何有效评估和提升AI生成答案质量的核心问题。通过提供高质量的基准答案和AI生成的对比答案,研究者能够量化不同AI系统在回答问题时的准确性、清晰度和充分性。这不仅有助于推动AI搜索引擎的性能提升,还为构建更加智能和可靠的问答系统提供了重要的数据支持。
衍生相关工作
基于该数据集,研究者已经开展了一系列相关工作,包括开发新的AI搜索引擎评估框架、改进答案解析算法以及设计更加智能的问答模型。例如,有研究利用该数据集对不同AI搜索引擎的响应解析能力进行了深入分析,提出了优化解析流程的新方法。此外,还有工作基于该数据集训练了生成高质量答案的深度学习模型,进一步提升了AI在问答任务中的表现。
以上内容由遇见数据集搜集并总结生成


