遇见数据集

saraiki-english-dataset

收藏
Hugging Face2026-08-17 更新2026-08-18 收录
官方服务:

资源简介:

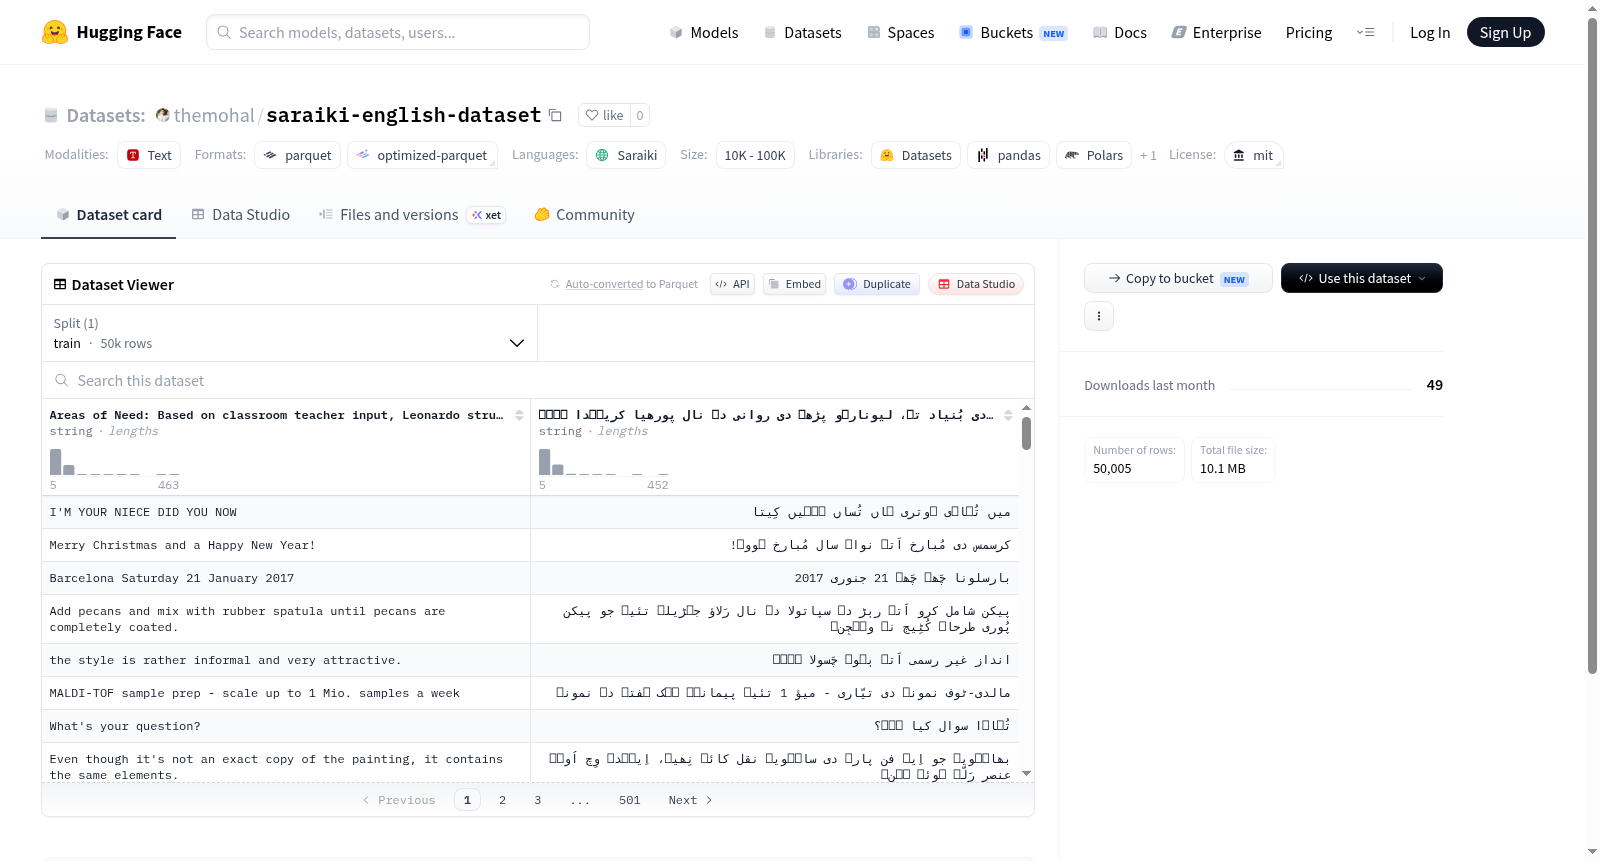
该数据集是一个面向教育领域的学生需求识别数据集,包含英文和旁遮普语(Shahmukhi字体)双语文本。每个样本包含一个英文句子描述学生Leonardo在课堂中表现出的阅读流畅性困难,以及对应的旁遮普语翻译。数据集共包含50005个训练样本,可用于多语言文本分类、翻译或教育需求分析等相关任务。数据来源为课堂教师输入,旨在支持对特殊教育需求学生的识别与干预。

This dataset is an education-oriented student needs identification dataset, containing bilingual text in English and Punjabi (Shahmukhi script). Each sample includes an English sentence describing the reading fluency difficulties exhibited by student Leonardo in the classroom, along with its Punjabi translation. The dataset contains a total of 50,005 training samples, which can be used for tasks such as multilingual text classification, translation, or educational needs analysis. The data source is teacher input from the classroom, aiming to support the identification and intervention of students with special educational needs.

创建时间:
2026-08-08
原始信息汇总

Saraiki-English 数据集概述

基本信息

  • 许可证:MIT 许可证
  • 主要语言:Saraiki(斯科特语,语言代码:skr)
  • 数据集类型:双语对齐文本数据集(Saraiki-英语)

数据内容

该数据集包含两条主要特征字段:

  1. Areas of Need(英语):基于课堂教师反馈,描述学生Leonardo在阅读流利度方面的困难。
  2. لوڑ دے شعبے(Saraiki语):为上述英语内容的Saraiki语对应翻译,同样描述Leonardo在阅读流利度方面的学习需求。

数据集规模

项目 数值
训练集样本数 50,005 条
数据集总大小 6,706,006 字节(约6.4 MB)
下载大小 3,471,685 字节(约3.3 MB)

数据划分

  • 仅包含一个划分:train(训练集),所有数据均用于训练。

文件结构

  • 数据文件路径:data/train-*(默认配置为 default,使用通配符匹配多个分片文件)。
搜集汇总
数据集介绍
saraiki-english-dataset 数据集图片
构建方式
该数据集的构建基于课堂教学实践,以一名学生(Leonardo)的阅读能力问题为切入点,通过教师反馈收集其具体困难,并翻译成萨莱基语(Saraiki)形成双语对照条目。数据集包含50005个训练样本,每个样本由英语原文和对应的萨莱基语译文组成,覆盖教育场景中的实际需求表达。构建过程中强调了语言资源的本地化处理,确保译文准确反映原文语义及语境,为低资源语言的自然语言处理任务提供基础数据支持。
特点
数据集突出体现了双语对齐的特点,每一条目均包含英语与萨莱基语的对照,便于跨语言学习与模型训练。其内容聚焦于教育领域的具体问题描述,具有高度的场景针对性和实用性,有助于开发面向课堂支持或教育辅助的工具。此外,数据规模适中(约5万条),且采用MIT许可证开放,确保了数据的可获取性与科研应用潜力,为萨莱基语这一低资源语言的研究提供了宝贵资源。
使用方法
数据集可直接用于训练序列到序列模型,如机器翻译系统,将英语教育内容自动转换为萨莱基语。同时,它也可应用于文本分类或信息抽取任务,以识别教育需求领域。研究者可利用HuggingFace的datasets库加载该数据,结合预设的训练/验证分割进行模型微调。数据格式简洁,包含两个字符串字段,便于进行数据清洗或增强。此外,该数据集可作为低资源语言NLP研究的基准,促进相关算法的改进与评估。
背景与挑战
背景概述
该数据集名为saraiki-english-dataset,创建于近期,由致力于低资源语言处理的机构或研究人员开发,旨在推动萨莱基语(Saraiki)与英语之间的机器翻译研究。萨莱基语是巴基斯坦旁遮普省南部地区的主要语言,使用人口超过两千万,但长期缺乏数字化资源和自然语言处理工具。此数据集包含50,000余条训练样本,每对样本提供英语句子及其萨莱基语翻译,内容涵盖教育领域的实际需求,如学生评语。该数据集的发布填补了萨莱基语与英语平行语料库的空白,为低资源语言翻译模型、跨语言迁移学习和教育信息处理提供了宝贵资源,对推动南亚地区语言技术发展具有重要意义。
当前挑战
该数据集面临的挑战源于萨莱基语的低资源特性。首先,萨莱基语缺乏统一的书写规范和标准化拼写,尤其在以阿拉伯-波斯文字书写时,存在大量变体,增加了数据清洗和模型训练的难度。其次,本数据集仅包含单一领域(教育评语)的短文本,限制了模型的泛化能力,难以覆盖更广泛的日常对话或专业文本。在构建过程中,收集高质量双语平行句对需要精通萨莱基语和英语的双语专家,且因语言使用者的数字素养不均,导致原始数据来源有限,必须依赖人工翻译和审核,耗费大量人力与时间。此外,数据规模相对较小(约5万条),可能不足以训练高性能的神经机器翻译模型,易产生过拟合问题。最后,萨莱基语单词形态丰富,词形变化复杂,加之阿拉伯-波斯文字的双向书写特性,给数据预处理和模型设计带来额外挑战。
常用场景
经典使用场景
该数据集面向旁遮普语(Saraiki)与英语的跨语言翻译与自然语言处理任务,其核心用途在于构建和评估机器翻译系统,尤其是在低资源语言场景下。数据集包含逾五万条平行语料,覆盖课堂教育领域中的学生评语,为神经机器翻译模型提供了宝贵的训练与测试素材。研究者常利用此数据集进行序列到序列模型的训练,以提升Saraiki至英语的翻译质量,同时也用于跨语言词向量对齐、多语言预训练模型的微调等经典实验。该数据集的特色在于其领域限定性,使得模型能够在特定语义空间中表现出更高精度,为低资源语言翻译研究树立了标杆。
衍生相关工作
自该数据集发布以来,衍生出多项相关研究。一方面,它成为多篇低资源机器翻译论文的基准测试集,激发了针对Saraiki-英语的多种神经架构实验,包括基于Transformer的模型改进、多任务学习框架以及预训练语言模型的适应性微调。另一方面,研究者基于此数据开发了Saraiki语言工具包,涵盖分词器、词性标注器及语音识别前序任务,进而促进了该语言基本NLP组件的丰富。此外,该数据集还催生了关于数据增强技术的评估研究,例如回译和语义保持的噪声注入,验证了这些方法在极端资源匮乏时的效果。这些衍生工作不仅提升了Saraiki的语言资源生态,也为其他低资源语言研究提供了可复现的路径。
数据集最近研究
最新研究方向
该数据集聚焦于低资源语言中的机器翻译与多语自然语言处理,尤其针对莎拉基语与英语的平行语料构建,最新研究趋势在于开发基于Transformer架构的神经机器翻译模型,利用迁移学习与数据增强技术缓解低资源困境,并探索跨语言预训练模型的微调策略。同时,研究亦关注教育场景下的文本简化与可读性评估,旨在提升莎拉基语学习者的阅读理解能力,其意义在于推动语言平等与数字包容,为濒危语言的技术支持树立典范。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务