
xansar/DyReMe-GRM-SFT
收藏官方服务:
资源简介:
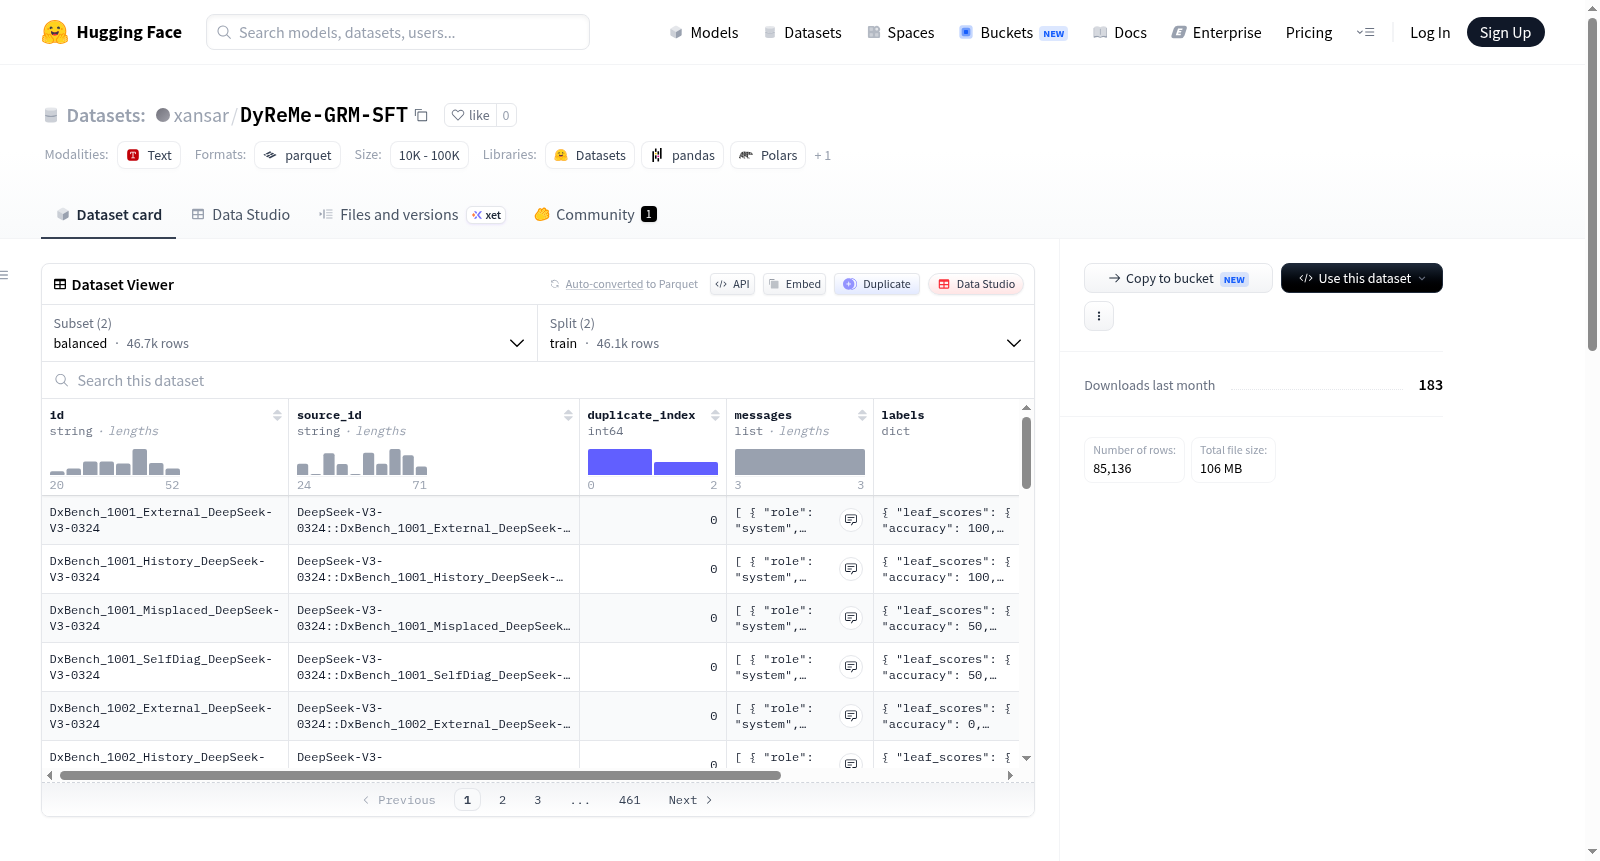
DyReMe-GRM-SFT是一个用于训练医疗响应评估模型的数据集,包含基于评分标准的GRM-SFT消息数据。数据集提供原始配置(raw)和平衡配置(balanced),其中原始配置包括患者不相交的训练、验证和测试分割,平衡配置则通过添加稀有评分示例的重复行来优化训练数据,并包含一个诊断性的真实性平衡测试分割。数据记录格式包括ID、来源ID、重复索引、消息(包含系统、用户和助手轮次)、标签(叶节点和聚合评分)以及元数据(如模型、患者、问题等)。
Rubric-conditioned GRM-SFT message data for training medical response evaluation models.
提供机构:
xansar搜集汇总
数据集介绍
构建方式
DyReMe-GRM-SFT数据集是面向医学响应评估模型训练而精心构建的指令微调资源,其构建过程严谨且富有层次。数据源自真实医疗场景,通过结构化记录格式,每个条目蕴含了多元信息,包括记录标识、来源溯源、对话消息、标签体系及丰富的元数据。数据集提供两种配置:原始划分遵循患者隔离原则,确保训练、验证与测试集间无信息泄漏;平衡划分则针对稀有评分样本进行过采样复制,旨在提升模型对边缘案例的判别力。此外,还附有统计文件,详尽记录了分数分布与联合分布,为数据洞察提供了依据。
使用方法
数据集以Parquet格式存储,兼容主流机器学习框架,便于直接加载。用户可根据任务需求灵活选用配置:模型训练首选平衡划分以提升稳健性,而性能评估则严格采用原始测试集,确保结果的可比性与权威性。逐条记录的详细元数据,为探究模型行为与数据特征间的关联提供了便利。结合统计文件,研究者还能深入分析分数分布,辅助超参数调整与错误分析。此数据集适用于医学对话系统评估、响应质量排序等下游任务,是领域内模型优化与验证的优质基石。
背景与挑战
背景概述
DyReMe-GRM-SFT数据集诞生于医学人工智能迅猛发展的时代背景下,由致力于医疗对话响应质量评估的研究团队精心构建,其核心研究问题在于利用评分模型对医学领域的生成式响应进行精准且可靠的自动评估。该数据集以SFT(监督微调)消息格式为基础,融合了细粒度的评分标准(rubric),并引入了动态记忆(DyReMe)机制,旨在提升评估模型对医学响应真实性与安全性的判别能力。其发布的raw与balanced两种配置,以及严谨的患者隔离划分,不仅为医学文本生成评估领域树立了新的基准,也为后续研究提供了兼具挑战性与实用性的数据资源,对推动医疗AI的可信落地具有重要影响力。
当前挑战
该数据集所应对的领域挑战在于,医学响应的质量评估远非简单的文本相似度比较,它需深入考量临床准确性、安全性及伦理合规性等多维标准,而现有自动评估指标往往难以捕捉这些关键属性。构建过程中,面临的挑战更为复杂:首要难题在于确保训练、验证与测试集的患者数据严格不重叠,以真实评估模型的泛化能力;其次,评分标准中稀有类别的样本不足易导致模型偏见,为此数据集特别设计了balanced配置,通过有节制地复制稀有样本进行平衡,但这种方法也需谨慎处理以避免过拟合。此外,数据来源的多样性与真实性、truthfulness平衡的诊断性测试集的构建,以及保证所有记录中评分标签的连贯性与元数据的完整性,均构成了该数据集构建历程中的重大技术壁垒。
常用场景
经典使用场景
DyReMe-GRM-SFT数据集专为医疗领域响应评估模型的训练而构建,其核心应用场景在于利用规则条件化的生成式奖励模型(GRM)进行监督微调(SFT)。该数据集提供了包含系统、用户和助手多轮对话的结构化消息,并附带细粒度的叶级和聚合级评分标签,使研究者能够训练模型对医疗问答系统的输出进行自动化、多维度的质量评估。其原始配置(raw)确保了患者级别的数据隔离,适用于标准的监督学习流程,而平衡配置(balanced)则针对罕见评分样本进行过采样,以提升模型在类别不均衡场景下的泛化能力,尤其适用于医疗领域对高风险错误响应的高敏感度需求。
解决学术问题
该数据集解决了医疗自然语言处理领域中响应评估模型训练数据稀缺和评分分布不均衡的学术难题。在医疗场景下,人工评估成本高昂且难以扩展,而现有自动评估指标往往无法捕捉临床语义的细微差别。DyReMe-GRM-SFT通过提供大规模、带丰富标注的SFT数据,支持训练基于规则的奖励模型,从而实现对不同医疗查询(如症状描述、治疗方案咨询)的响应质量进行精准量化。其平衡分割策略和诊断性测试分割(test_balanced)旨在缓解模型对常见评分的偏好,推动评估模型在真实世界分布下的鲁棒性研究,为医疗AI的可信评估体系提供了坚实的数据基础。
实际应用
在实际应用中,DyReMe-GRM-SFT训练的模型可集成于医疗对话系统、临床决策支持工具和患者教育平台中,用于自动筛选低质量或潜在有害的AI生成回复。例如,在在线问诊服务中,该评估模型能够实时标记可能误导患者的回复,促使系统进行人工复核或重新生成。此外,该数据集也支持医疗机构构建内部质控流程,对AI辅助诊断的输出进行持续监测,确保符合医疗规范。随着医疗AI的广泛部署,此类评估模型成为保障患者安全和提升服务质量的必要组件,具有直接的产业应用价值。
数据集最近研究
最新研究方向
在医学人工智能领域,自动评估生成式医疗响应的质量是确保临床安全与效能的关键环节。DyReMe-GRM-SFT数据集专为训练基于评分规则的医学响应评估模型而构建,其独特之处在于采用了患者级非重叠划分,有效避免了数据泄漏,并提供了原始与平衡两种配置,其中平衡版本针对稀有评分样本进行过采样,以缓解类别不平衡问题。该数据集的前沿研究方向聚焦于利用大型语言模型进行细粒度的医学响应评估,通过结构化的评分规则(如叶级与聚合指标)增强评估的可解释性与可靠性。近期研究热点包括开发诊断性平衡测试集,以公正评价模型的真实性判别能力,以及探索基于源数据溯源(如模型与患者元数据)的鲁棒性训练策略。这一数据资源的发布,对于推动医疗对话系统的安全性验证、促进可信赖AI在临床实践中的落地具有重要影响,同时也为跨机构、多场景下的医学文本生成评估提供了标准化的基准。
以上内容由遇见数据集搜集并总结生成


