遇见数据集

law-instructions-dataset

收藏
Hugging Face2026-09-12 更新2026-09-13 收录
官方服务:

资源简介:

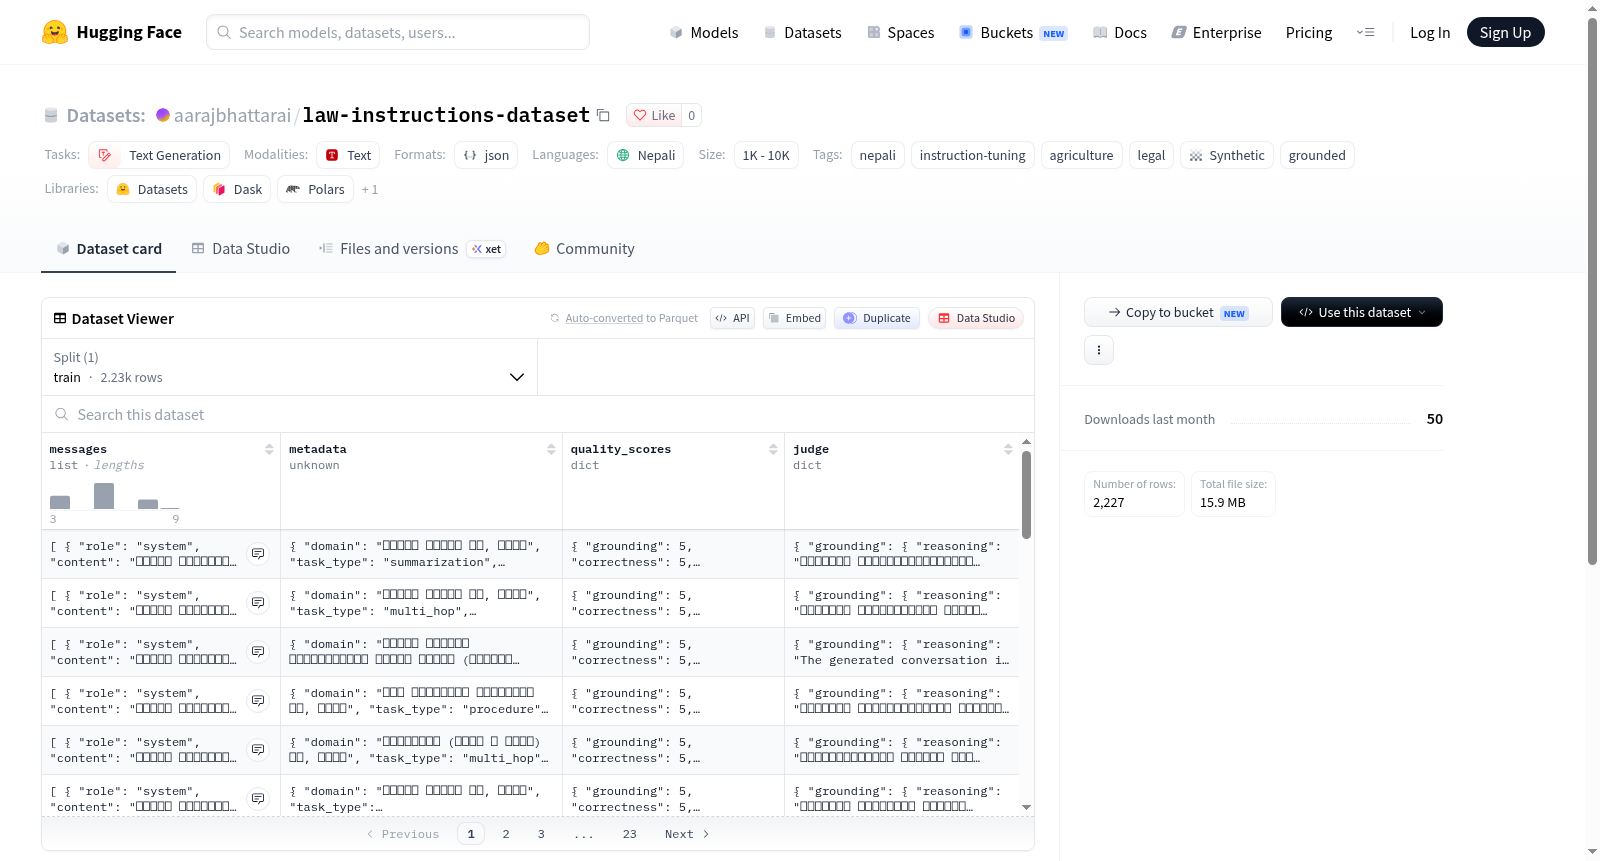
该数据集是一个尼泊语源文档约束的指令微调数据集,使用NVIDIA NeMo Data Designer从权威的尼泊尔文档(包括农业手册和法律文本)中合成生成。数据集中问题的回答严格基于源文档内容,对于无法从文档中找到答案的问题,模型会被训练为明确拒绝回答。每条记录采用聊天消息格式,并附带元数据以及针对每条记录的质量评分,包括基础性、正确性和自然性,评分范围为1-5,由LLM作为评判者给出。每个源文档对应一个data/train-<shard>.jsonl文件,多次运行会幂等地覆盖。该仓库为训练仓库,仅包含通过质量门限的记录(基础性>=4, 正确性>=3, 自然性>=3)。

This dataset is a Nepali source-document-constrained instruction fine-tuning dataset, synthetically generated from authoritative Nepali documents (including agricultural manuals and legal texts) using NVIDIA NeMo Data Designer. Answers to questions in the dataset are strictly based on the source document content; for questions that cannot be answered from the document, the model is trained to explicitly refuse to answer. Each record is in chat message format, accompanied by metadata and quality scores for each record, including grounding, correctness, and naturalness, with scores ranging from 1 to 5, given by an LLM as judge. Each source document corresponds to a data/train-<shard>.jsonl file, and multiple runs are idempotently overwritten. This repository is for training and contains only records that pass the quality thresholds (grounding>=4, correctness>=3, naturalness>=3).

创建时间:
2026-09-12
原始信息汇总

Nepali Source-Grounded Instruction Dataset

数据集概述

  • 合成尼泊尔语指令微调数据集
  • 使用 NVIDIA NeMo Data Designer 生成
  • 来源于权威尼泊尔语文档(农业手册、法律文本)
  • 答案为严格基于来源的grounded回答
  • 无法回答的问题会给予明确拒绝

语言与任务

  • 语言:尼泊尔语(ne)
  • 任务类别:文本生成(text-generation)

标签

  • nepali
  • instruction-tuning
  • agriculture
  • legal
  • synthetic
  • grounded

数据格式

  • 记录使用聊天 messages 格式
  • 包含 metadata
  • 每条记录包含 quality_scores(grounding / correctness / naturalness,1-5 分,LLM-as-judge)

数据组织

  • 每份来源文档对应一个 data/train-<shard>.jsonl
  • 分片在重跑时会幂等地被覆盖

质量门槛

  • 本仓库为训练仓库(TRAINING repo)
  • 记录需通过质量门槛:
    • grounding >= 4
    • correctness >= 3
    • naturalness >= 3

配套仓库

  • rejected-*:存放未通过质量门槛的记录
  • unjudged-*:存放 judge 调用失败的记录
搜集汇总
数据集介绍
law-instructions-dataset 数据集图片
构建方式
该数据集依托NVIDIA NeMo Data Designer框架,从尼泊尔语权威文档——涵盖农业手册与法律文本——中合成指令微调数据。构建过程严格遵循源文本锚定原则,通过自动化管道生成问答对,确保每一条回答均可在源文档中找到直接依据;对于源文本无法支撑的问题,系统显式生成拒答响应,以此杜绝模型幻觉,保障数据的事实一致性。
使用方法
该数据集适用于尼泊尔语指令微调与文本生成任务。使用时可直接加载data/train-<shard>.jsonl文件,每个分片对应一份源文档,便于按领域或文档粒度组织训练。训练前可依据quality_scores字段进一步筛选样本,或结合rejected与unjudged配套仓库进行数据质量对比研究。分片在重复运行时采用幂等覆写机制,确保数据版本的一致性与可复现性。
背景与挑战
背景概述
尼泊尔语作为低资源语言,长期缺乏高质量指令微调数据,制约了当地语言模型在专业领域的应用。为弥合这一数字鸿沟,研究者依托NVIDIA NeMo Data Designer框架,从尼泊尔农业手册与法律文本等权威文档中,合成出严格基于来源的指令数据集。该数据集聚焦农业与法律两大民生领域,采用聊天格式并附质量评分,以可溯源、可拒答的机制确保答案的忠实性。其创建回应了低资源语言在专业场景下数据稀缺的核心问题,为尼泊尔语自然语言处理研究提供了可信赖的训练资源,推动了源 grounded 指令微调范式在边缘语言中的实践。
当前挑战
该数据集所应对的领域问题在于尼泊尔语专业领域指令数据的极度匮乏,以及现有模型在农业与法律咨询中易产生无依据幻觉的缺陷。构建过程中的挑战则体现为:如何从权威但非结构化的尼泊尔语文档中精准提取可回答与不可回答的问题,并生成严格依据来源的答案;如何设计有效的质量门控机制,通过大模型裁判对 grounding、正确性与自然度进行多维评分,确保仅高置信记录进入训练集;以及如何在合成数据中嵌入显式拒答行为,以抑制模型对无解问题的臆测。这些挑战共同构成了低资源语言源 grounded 指令数据构建的典型难题。
常用场景
经典使用场景
在尼泊尔语自然语言处理领域,低资源语言的指令微调数据长期匮乏,该数据集以权威农业手册与法律文本为源,通过NVIDIA NeMo Data Designer合成具有源依据的指令数据,其经典使用场景为大语言模型的指令遵循能力训练。每条记录以聊天格式组织,配以元数据与质量评分,模型在学习过程中被引导严格依据源文档作答,对无法回答的问题明确拒绝,从而在低资源语境下培养可靠的指令响应行为。
解决学术问题
该数据集缓解了尼泊尔语指令微调数据稀缺与质量参差的问题,通过源依据标注与LLM-as-judge质量门控,为研究提供了可验证的高质量训练资源。它使学者能够探究低资源语言中指令遵循、源依据生成与拒答行为的联合建模,并支撑跨语言迁移与领域适应的实证研究,对推动尼泊尔语乃至其他低资源语言的指令微调研究具有积极意义。
实际应用
在实际应用中,该数据集可服务于尼泊尔语智能问答、农业技术咨询与法律条文检索等场景。基于此训练的模型能够依据权威文档提供有据可查的回答,降低幻觉风险,适用于面向尼泊尔语用户的公共信息服务、政务咨询与教育辅助系统,为低资源语言地区的数字化服务提供技术支撑。
数据集最近研究
最新研究方向
在低资源语言指令微调的研究浪潮中,该数据集聚焦于尼泊尔语的法律与农业领域,借助NVIDIA NeMo Data Designer从权威文档中合成严格基于来源的指令数据,并引入LLM-as-judge对扎根性、正确性与自然度进行多维评分,以质量门控筛选训练样本。这一方向呼应了当前大语言模型对事实一致性与可追溯推理的迫切需求,推动了 grounded instruction tuning 在低资源场景下的方法论创新。其拒绝不可回答问题的设计,为缓解幻觉、提升模型可信度提供了可复用的数据构建范式,对南亚语言技术生态及法律、农业等垂直领域的知识服务具有显著的支撑意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务