遇见数据集

Artificial Knowledge Collection 6.0

收藏
github2026-07-14 更新2026-07-19 收录
官方服务:

资源简介:

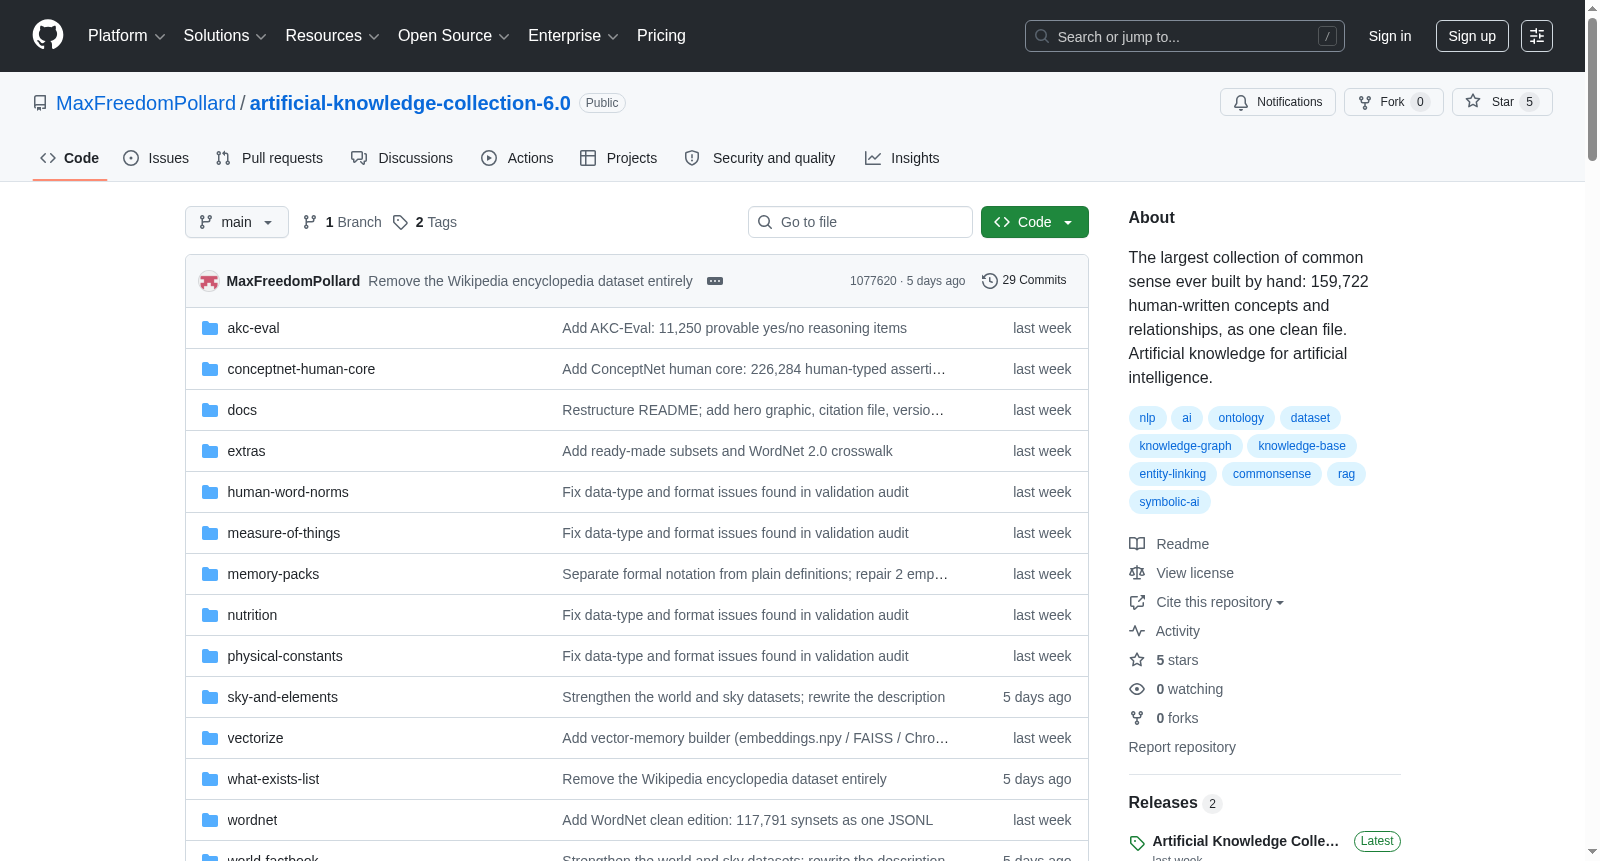
这是最大的人工构建常识集合:包含159,722个人工编写的概念和关系,作为一个干净的文件。为人工智能提供人工知识,包括知识图谱、词汇网络、日常事实、物理常数、天体元素、地理数据和人类词汇规范等多个数据集。

This is the largest manually constructed commonsense collection, containing 159,722 manually written concepts and relationships, and is provided as a clean dataset file. It supplies manually curated knowledge for artificial intelligence, encompassing multiple datasets including knowledge graphs, lexical networks, everyday facts, physical constants, astronomical elements, geographic data, and human lexical norms.

创建时间:
2026-07-09
原始信息汇总

数据集概述

Artificial Knowledge Collection 6.0 是一个持续扩充的人工知识集合,旨在为人工智能的构建与使用提供经过清洗、稀有且难以获取的、可直接使用的知识文件。该数据集共有 159,722 条记录,支持 JSONL、Parquet、TXT、CSV 四种格式。


核心组成部分

组成部分 描述 数据规模
The What Exists List (what-exists-list/) 所有数据集已知事物的合并主文件,包含概念、名称、定义及人类陈述的事实及其关联。是唯一在其他地方找不到的集合索引。 553,829 个事物,1,003,336 条链接
Founding common-sense knowledge base (max-map.jsonl) 手工构建的最大的常识知识库(源自Cyc项目),逻辑关系清晰,是唯一未受污染的干净版本。 159,722 条人类书写的概念及关系
WordNet (wordnet/) 普林斯顿大学手工构建的英语词汇地图,包含定义及词汇间关联。 117,791 个词义
Human core of ConceptNet (conceptnet-human-core/) 志愿者用简单英语写下的日常事实,描述事物功能。 226,284 条日常事实
Physical constants (physical-constants/) CODATA 2022 物理常数、SI词头、精确单位换算。 415 条记录
Sky and elements (sky-and-elements/) 包含化学元素、同位素、恒星、行星、深空天体及星座的物理宇宙实测数据,源自NIST、NASA/JPL及星表。 12,820 条记录
The world (world-factbook/) 来自 CIA World Factbook 的地理数据,包括国家、城市、河流与湖泊。 261 个国家/地区、7,342 个城市、645 条河流/湖泊
Human word norms (human-word-norms/) 人们对词汇具体性、习得年龄、联想强度等心理语言学特征的实证数据。 85,889 个词汇,72,089 个关联对
AKC-Eval (akc-eval/) 11,250 个是/否推理问题,答案可从知识集中直接验证。 11,250 个问题

数据特点与价值

  • 原创性:绝大部分数据在生成式AI出现之前由人类书写或测量,不含机器生成的文本或结构。
  • 纯净性:作为“低背景钢”,知识库无污染,尤其适用于AI训练和验证。
  • 可追溯性:每条知识均可追溯到人类源头。
  • 可验证性:包含AKC-Eval测试集,答案均基于人类核查的事实。

数据格式与使用

  • 主要格式:JSONL、Parquet、TXT、CSV、向量JSONL。
  • 每个数据集文件夹内附 KEY.md 解释字段,FORMATION.md 记录数据来源与清洗过程。
  • 提供 extras/subsets/ 子集,方便快速使用。

快速启动代码示例(需先下载文件):

python import gzip, json

加载主索引

things = {n["id"]: n for n in (json.loads(l) for l in gzip.open("what-exists-list.jsonl.gz", "rt", encoding="utf-8"))}

加载基础常识知识库

data = [json.loads(line) for line in open("max-map.jsonl", encoding="utf-8")]


许可与引用

  • 编译者:Max Freedom Pollard
  • 许可证:本集合及原创数据集(What Exists List、AKC-Eval)遵循 CC BY-SA 4.0;各组件数据集保留其原始许可,详见 FORMATION.md
  • 下载文件均提供 SHA256SUMS.txt,可使用 shasum -a 256 -c 验证完整性。
搜集汇总
数据集介绍
Artificial Knowledge Collection 6.0 数据集图片
构建方式
Artificial Knowledge Collection 6.0的构建根植于对稀缺、洁净且来源可靠的人类知识体系的系统性整合。该数据集的核心架构围绕一个名为“What Exists List”的独特全局索引展开,该索引通过融合多个独立知识库中的实体与关系,形成一个包含553,829个实体及1,003,336条连接的超大规模语义图谱。其基石是一座由人工历时二十余年编纂的常识知识库(max-map.jsonl),收录了159,722条关于世间万物的逻辑关系,并经过精心清理,以恢复其原始未被污染的面貌。此外,数据集还吸纳了普林斯顿WordNet、ConceptNet的人类核心部分、CODATA物理常数、天体化学元素数据、CIA世界概况以及人类词汇规范等多元异构数据源,所有来源均明确记录于各子集的FORMATION.md文件中,确保了构建过程的透明与可追溯性。
使用方法
使用者可通过解压“What Exists List”的JSONL.gz文件,以逐行读取的方式加载整个知识图谱,作为推理或知识增强的基础索引。对于特定应用,亦可单独加载max-map.jsonl等核心子集,利用其丰富的实体关系进行常识推理。所有数据均附带KEY.md文件以详细解释字段含义,极大降低了使用门槛。数据集支持多种数据处理生态,如max-map.parquet可直接用于pandas或DuckDB进行高效的列式分析。得益于统一的格式和清晰的文档,研究者能够便捷地将这些人类知识源集成到检索增强生成(RAG)管线或作为评估基准,在探索模型理解与知识构建能力时,获得稳固、可靠且可验证的先验知识支持。
背景与挑战
背景概述
Artificial Knowledge Collection 6.0由Max Freedom Pollard于2024年发布,是一个汇聚稀有、洁净且具备高保真度的人工知识库。其核心旨在为人工智能系统提供纯正的人类来源知识,避免模型因自我循环训练而产生污染。该数据集整合了长达二十余年手工构建的常识知识库Cyc、Princeton WordNet、ConceptNet人类核心子集,以及来自NIST、NASA/JPL的物理常数、天文与地理数据,共计159,722条记录。通过构建唯一的“What Exists List”索引图,它将逻辑概念、定义与日常事实联结为可追溯的图结构,成为验证AI推理的重要基准。该数据集在生成式AI时代的价值尤为凸显,被视为如“低本底钢”般纯净的参考标准。
当前挑战
该数据集所解决的领域挑战在于,当前大规模语言模型普遍缺乏可靠的人类知识锚点,极易从自身生成的内容中学习错误关联,导致“模型崩溃”现象。构建过程中则面临多重困难:首先,恢复并清洗Cyc知识库的原始副本,因现存镜像已被严重污染并混入垃圾信息,需重构出唯一无谬误的版本;其次,整合WordNet、ConceptNet等异构数据结构,需统一格式并消除字段歧义;最后,将天文学与地理学等多源数据集归一化,确保单位与术语一致。此外,手工写作常识知识的成本极高,且数据集需持续扩展以覆盖更广领域,维护纯净性成为长期挑战。
常用场景
经典使用场景
在人工智能与认知科学领域,Artificial Knowledge Collection 6.0被广泛用作构建知识增强型语言模型与推理系统的基石。其核心用例在于为模型提供结构化、经人工验证的常识与事实知识,使之具备超越统计模式匹配的符号推理能力。具体而言,研究者常利用其中的‘What Exists List’与‘max-map.jsonl’作为外部知识库,设计检索增强生成(RAG)流程,或直接注入模型训练数据以校正事实性错误。该数据集的独特之处在于其‘低背景污染’特性——所有条目均源自生成式AI出现前的人类劳动,从而避免了模型自生数据导致的退化风险,成为评估模型真值对齐与常识推理鲁棒性的黄金标准。
解决学术问题
该数据集精准回应了当代自然语言处理研究中两大痛点:常识推理缺失与事实一致性飘忽。传统大规模语料虽语义丰富,却充斥隐含偏见、逻辑断裂与未被表达的常识(如‘雨伞不能是家具’)。通过提供Cyc项目近二十余年手工编纂的逻辑知识图谱与ConceptNet的日常功能描述,它填补了模型对‘不言自明’概念的表征空白。学术影响首先体现于推理评估范式——AKC-Eval子集包含11,250道可证明的是非题,构建了无需依赖模型输出的可控测试环境,使研究者得以独立审视模型的知识边界。此外,其低背景噪声特性使其成为分析模型知识遗忘现象与反事实推理的理想参照系,推动了可解释AI与符号-神经混合建模的发展。
实际应用
在实际产业应用中,该数据集充当了高品质知识基座的角色,服务于需要精确事实响应与逻辑一致性的垂直场景。智能客服系统可利用‘世界概况’与‘物理常数’子集,在回答跨语言地理查询或单位换算时提供零幻觉的底层支持。教育领域能借助其中‘单词关联规范’与‘日常事实’构建自适应学习系统,使AI助教在不依赖网络实时搜索的前提下,依据明确的结构化知识生成练习与答疑。此外,该数据集在医疗、法律等高风险领域的知识蒸馏中亦有应用潜力——其无污染的人类来源属性,使其成为审计与合规场景下模型输出的事实锚点,有效缓解因训练数据污染导致的灾难性错误。
数据集最近研究
最新研究方向
在当前大型语言模型普遍依赖互联网爬取数据、面临知识污染与自我循环困境的背景下,Artificial Knowledge Collection 6.0的提出具有里程碑意义。该数据集聚焦于构建人类手工编纂、无机器生成痕迹的纯净知识基座,其核心贡献在于收录了全球最大规模的手写常识知识库、结构化语义网络以及精确的物理与地理事实。前沿研究方向正朝着利用这类“低本底钢”式高质量语料来校正模型输出、增强推理可靠性迈进,尤其是在常识推理、概念关系理解与事实一致性检验等关键领域。该工作呼应了近年来关于大模型知识幻觉与数据污染的热点讨论,为构建具备真正理解与知识组合能力的智能系统提供了不可替代的基准资源,标志着AI数据建设从追求规模向追求纯度与溯源性的范式转变。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务