
遇见数据集

ep-dashboards-qwen27b

收藏
Hugging Face2026-08-09 更新2026-08-10 收录
官方服务:

资源简介:

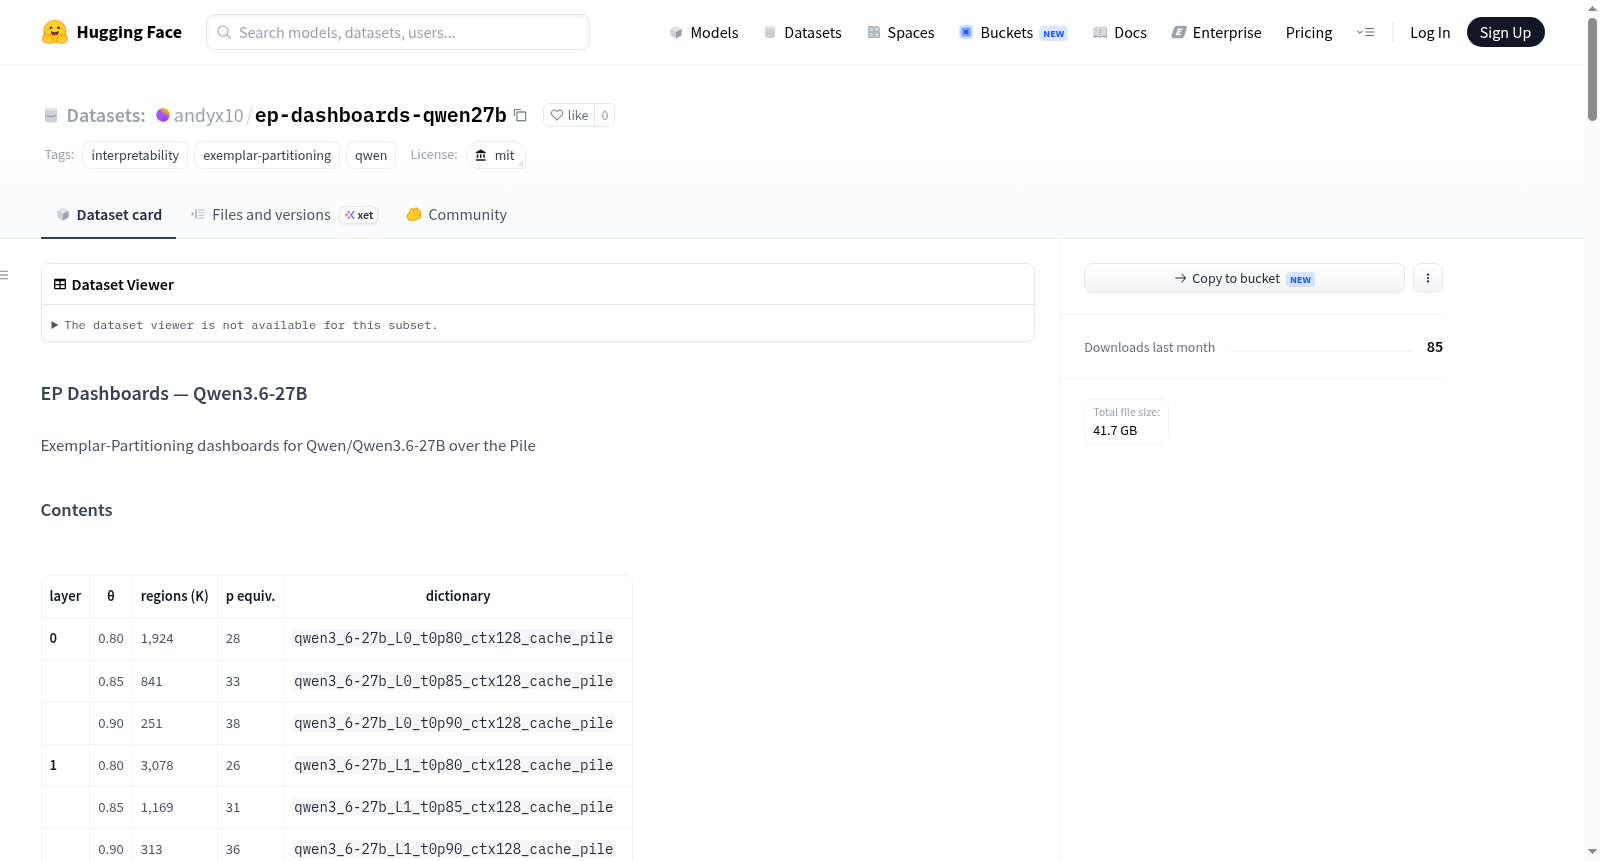
该数据集提供了 Qwen/Qwen3.6-27B 模型在 Pile 数据集上的 Exemplar-Partitioning 仪表板(EP Dashboards)。它通过在不同 Transformer 层(层 0 至层 62)和不同阈值 θ(0.80、0.85、0.90)下进行示例分区,生成多个区域(regions),每个区域对应一个字典。表格中列出了每个配置下的区域数量(K)、p 等价数以及对应的字典名称。每个字典文件夹包含以下文件:regions_NNN.html(区域页面,嵌入 JSON)、regions_NNN.json(区域记录)、header.json(字典元数据、来源、回放检查、每个区域摘要表)、vectors.npz(每个区域的 exemplar 和 mean 方向,以及校准中心向量)。该数据集适用于模型可解释性研究、内部表示分析和激活模式探索。

This dataset provides Exemplar-Partitioning (EP) Dashboards for the Qwen/Qwen3.6-27B model on the Pile dataset. It generates multiple regions by performing exemplar partitioning across different Transformer layers (layer 0 to layer 62) and thresholds θ (0.80, 0.85, 0.90). Each region corresponds to a dictionary. The table lists the number of regions (K), p-equivalence number, and corresponding dictionary name for each configuration. Each dictionary folder contains: regions_NNN.html (region page with embedded JSON), regions_NNN.json (region records), header.json (dictionary metadata, source, playback check, summary table per region), and vectors.npz (exemplar and mean direction per region, plus calibration center vector). The dataset is suitable for model interpretability research, internal representation analysis, and activation pattern exploration.

创建时间:
2026-08-09
原始信息汇总

EP Dashboards — Qwen3.6-27B 数据集总结

  • 数据集名称:EP Dashboards — Qwen3.6-27B
  • 许可证:MIT License
  • 标签:可解释性(interpretability)、示例分区(exemplar-partitioning)、通义千问(qwen)
  • 基础模型:Qwen/Qwen3.6-27B
  • 训练数据:Pile 数据集
  • 工具生成:EPDashboard

数据集内容概述

该数据集为 Qwen3.6-27B 模型在 Pile 数据集上提供基于示例分区(Exemplar-Partitioning)的可视化仪表盘。数据涵盖模型多个层(Layer),并在每个层分别采用三种阈值(θ = 0.80、0.85、0.90)进行分区,对应生成不同的分区字典(dictionary)。

数据规模与分区统计

  • 覆盖层数:45 个层(Layer 0 至 Layer 62,含部分中间层)
  • 每个层包含 3 个阈值设置,共 135 个字典条目
  • 区域数量(regions) 随层和阈值变化:
    • 阈值 θ=0.80 时:区域数约 2K 至 22K
    • 阈值 θ=0.85 时:区域数约 1.2K 至 5.4K
    • 阈值 θ=0.90 时:区域数约 250 至 1.1K
  • p 等价参数(p equiv.) 范围在 2 至 38 之间

字典文件结构

每个字典文件夹包含以下文件:

文件 内容说明
regions_NNN.html 区域页面 — EPDashboard 的输出单元,含 JSON 数据
regions_NNN.json 页面嵌入的区域记录数据
header.json 字典元数据、来源、回放检查、区域摘要表
vectors.npz 每个区域的示例(exemplar)方向向量和均值方向向量,以及校准中心(center)

字典命名规则

字典名称格式为:qwen3_6-27b_L{层数}_t{阈值}_ctx128_cache_pile,例如:

  • qwen3_6-27b_L0_t0p80_ctx128_cache_pile
  • qwen3_6-27b_L31_t0p90_ctx128_cache_pile
  • qwen3_6-27b_L58_t0p85_ctx128_cache_pile

其中 ctx128 表示上下文长度为 128,cache_pile 表示缓存数据集为 Pile。
搜集汇总
数据集介绍
ep-dashboards-qwen27b 数据集图片
构建方式
该数据集是基于Exemplar-Partitioning(EP)方法对Qwen3.6-27B模型在Pile语料库上的隐藏状态进行分区而构建的。研究者选取了模型的多个关键层(如第0、1、2、3层等),在每个层上应用不同阈值θ(0.80、0.85、0.90)进行分区,从而生成数量不等的区域(regions)。每个区域包含了对应的特征向量(exemplar和mean方向)以及校准中心(center),并以HTML和JSON格式存储区域页面,便于可视化与程序化访问。整个构建过程体现了从模型内部表征中提取可解释结构的方法论。
特点
该数据集的一个显著特点是其多粒度覆盖,涵盖了从浅层到深层的62个不同层,每个层在三个阈值下生成不同数量的区域,例如浅层区域较少,深层区域数量显著增加,直至第31层的22,474个区域(θ=0.80)。这种设计反映了模型内部表征随层加深而逐渐分化复杂化的特性。此外,每个区域记录都包含了精确的方向向量和元数据,为研究模型内部语义的演变提供了详实的数据支持。
使用方法
使用者可通过加载每个字典文件夹中的JSON文件或嵌入在HTML页面中的JSON数据,直接获取区域划分及其向量信息。这些数据可用于可解释性分析,如追踪特定层中区域所对应的语义概念,或比较不同层之间表征的演变。由于数据以结构化格式存储,研究者可以方便地使用Python等编程语言进行批量处理,实现自动化分析。务必注意各文件夹的命名规范,以便准确对应模型层与阈值参数。
背景与挑战
背景概述
随着大型语言模型(LLM)规模的急剧扩张,其内部机制的可解释性研究已成为人工智能领域的前沿热点。在此背景下,ep-dashboards-qwen27b数据集于近期由致力于模型透明度探索的研究团队构建,旨在通过Exemplar-Partitioning(EP)技术,对Qwen3.6-27B这一拥有数十亿参数的模型在Pile语料上的内部表征进行细粒度的解剖。该数据集系统性地覆盖了模型60余个关键层,并针对不同的阈值参数(θ)提供了多粒度的区域划分,其核心研究问题在于揭示深层Transformer中信息如何被模块化编码与处理。该资源为可解释性研究提供了前所未有的规模化视角,对于理解LLM的决策逻辑与潜在偏见具有重要推动作用,有望成为该领域后续研究的重要基准。
当前挑战
该数据集所应对的核心挑战在于,LLM参数规模庞大,其内部状态呈现高度复杂性与非直观性,传统探针或特征归因方法难以捕捉模型在不同层次上的分布式语义,而EP方法通过生成海量示例分区,为理解这些隐式结构提供了路径,这本身即是对现有可解释性范式的一次突破。在构建过程中,面临的技术挑战同样严峻:需对模型数十亿参数进行高效的前向传播以收集各层激活,并针对不同阈值参数进行精细调优,以确保区域划分的语义连贯性与统计显著性;数据规模庞大,包含数十万个区域及其对应的向量与元数据,对存储、索引和查询效率提出了极高要求;此外,如何验证分区结果的有效性并避免过度碎片化,也是设计过程中反复权衡的难题。
常用场景
经典使用场景
该数据集为Qwen3.6-27B大语言模型在Pile语料库上的Exemplar-Partitioning(EP)仪表盘集合,提供了从第0层至第62层不同深度、不同阈值(θ=0.80、0.85、0.90)下的区域划分结果,每个区域包含代表性的exemplar向量和平均方向。研究者在探究大型语言模型内部表征的结构化语义时,常利用此类数据剖析模型在不同层级的特征汇聚模式,通过区域数量与等效性指标评估模型表征的稀疏性与层级差异。该数据集的经典使用场景包括:利用区域可视化页面(regions_NNN.html)结合嵌入的JSON记录,定性观察特定层、特定阈值下的语义簇分布;或者通过加载vectors.npz文件中的exemplar与mean方向,定量分析模型在不同层对上下文信息的压缩与抽象方式,从而揭示Transformer内部信息处理的内在规律。
实际应用
在实际应用层面,该数据集可直接服务于多类下游任务。在模型诊断与调试中,工程师可对照特定层的区域分布,快速定位模型对某些输入产生异常反应的内部原因,例如通过查看特定区域的exemplar文本,判断模型是否过度依赖某种表面线索。在可控文本生成场景下,利用区域的方向向量进行激活引导,能够调整输出的风格或内容倾向,而不必重新训练模型。此外,在模型压缩与加速领域,基于区域稀疏性分析,可识别冗余层或低效单元,指导剪枝或量化策略,在保持性能的同时显著降低推理开销。对于教育行业,该数据有助于开发辅助教学工具,直观展示学生与模型在语义理解上的差异,促进更透明的AI素养培养。
衍生相关工作
围绕Exemplar-Partitioning方法及其仪表盘,衍生出了一系列具有影响力的研究与实践工作。在方法层面,后续工作扩展了EP框架,提出了自适应阈值选择算法,以及将EP与自编码器结合的多尺度特征分解技术,进一步提升了区域语义的纯度。在应用层面,已有研究者基于该数据集开展跨模型对比研究,通过统一的分区标准比较不同规模、不同架构模型在相同语料上的表征异同,为模型架构演化提供实证参考。此外,该数据集催生了若干工具库与可视化平台,例如交互式仪表盘浏览器和自动文本标签生成工具,使得非专家用户也能便捷地探索模型内部世界。这些衍生工作不仅深化了对语言模型可解释性的理解,也为可解释AI工具链的完善贡献了令人瞩目的成果。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

