ai-requirements-index
收藏资源简介:
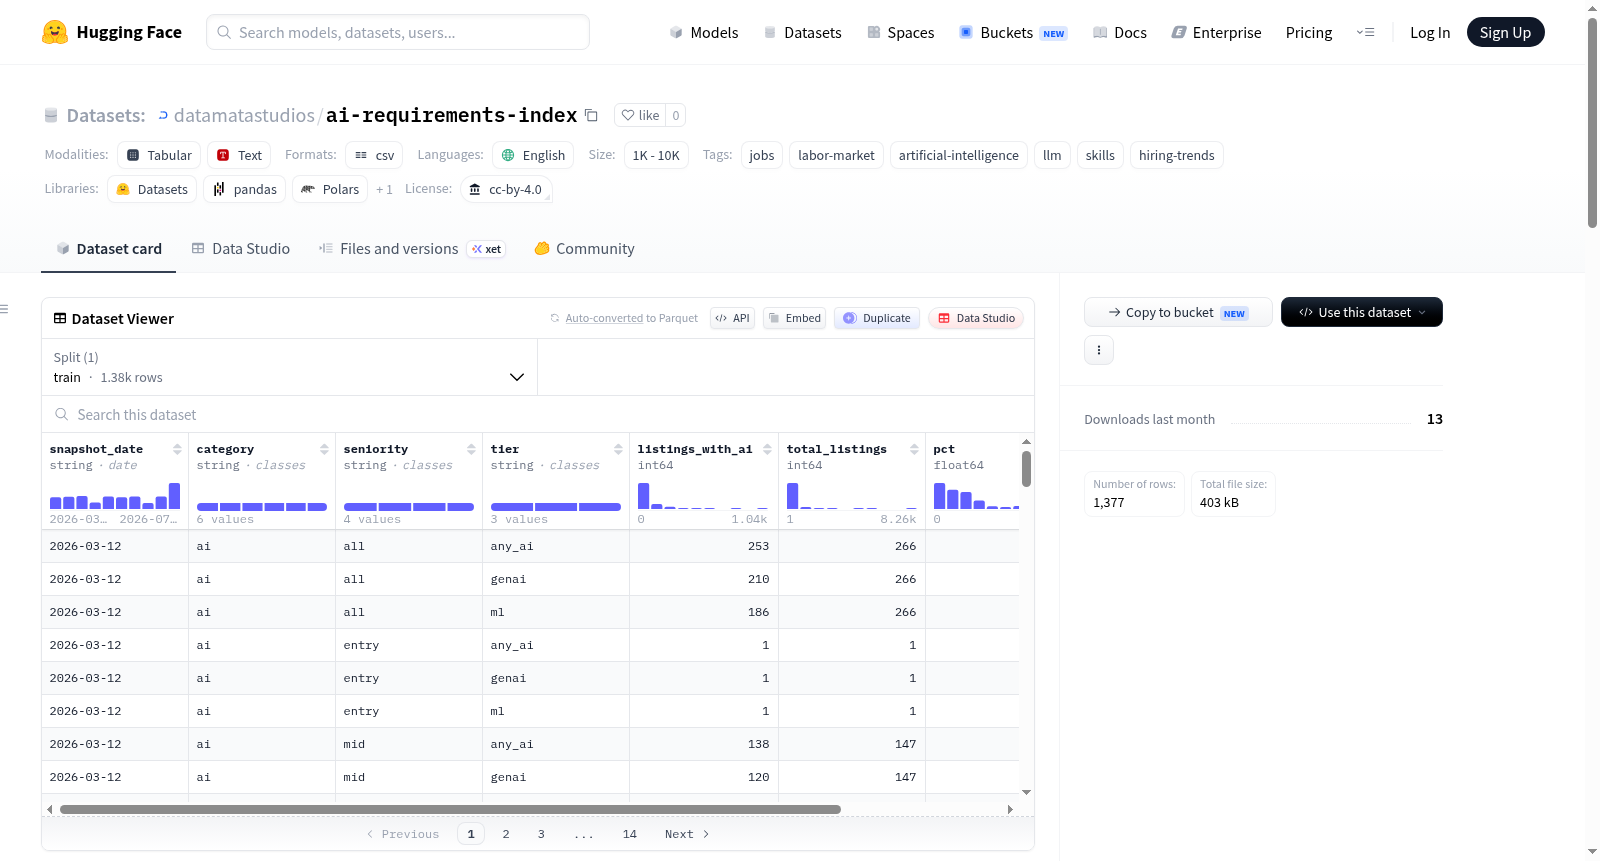
Datamata AI 需求指数数据集是一个用于追踪人工智能技能在科技职位招聘中成为需求的速度的时序数据集。它记录了按时间、技能层级(生成式AI vs 经典机器学习)、职位类别(数据、工程、产品、开发运维、安全、AI)和资历级别(全部、初级、中级、高级、主管、未知)划分的活跃科技职位列表中提及AI技能的比例。数据集每日更新,包含1377行数据,每行代表一个特定日期、类别、资历和技能层级的聚合快照。关键指标包括提及AI技能的职位列表数量、总职位列表数量、占比以及作为硬性要求的职位数量。该数据集适用于分析AI技能需求趋势、比较不同技能层级的增长速率、评估各职位类别对AI技能的采纳速度以及研究不同资历级别的需求差异。数据来源于对公开公司职业页面和招聘网站的每日抓取,并通过一个精心策划的分类法从职位描述文本中提取技能。数据集采用CC BY 4.0许可证,允许商业使用和改编,需注明出处。
The Datamata AI Demand Index dataset is a time-series dataset that tracks the rate at which AI skills are becoming required in tech job postings. It records the proportion of active tech job listings mentioning AI skills, segmented by time, skill tier (generative AI vs. classic machine learning), job category (data, engineering, product, DevOps, security, AI), and seniority level (all, entry, mid, senior, lead, unknown). The dataset is updated daily and contains 1,377 rows, each representing an aggregated snapshot for a specific date, category, seniority, and skill tier. Key metrics include the number of job listings mentioning AI skills, total job listings, proportion, and number of jobs requiring AI skills as a hard requirement. It is suitable for analyzing trends in AI skill demand, comparing growth rates across skill tiers, evaluating adoption speed across job categories, and studying demand variations by seniority level. Data is sourced from daily crawls of public company career pages and job boards, with skills extracted from job description text using a curated taxonomy. The dataset is licensed under CC BY 4.0, allowing commercial use and adaptation with attribution.
数据集概述:Datamata AI Requirements Index
该数据集追踪了AI技能成为技术岗位招聘要求的增长速度,提供了随时间变化的活跃技术岗位招聘信息中提及AI技能的占比数据,并按技能层级、职位类别和资历级别进行划分。
- 数据集名称:Datamata AI Requirements Index
- 数据集提供方:Datamata Studios
- 最新快照日期:2026-07-11
- 当前发布版本行数:1377
- 更新频率:每日更新
- 许可证:CC BY 4.0(可自由使用、改编,包括商业用途,需注明出处)
- 来源与方法论:https://www.datamatastudios.com/datasets/ai-requirements-index
数据内容与用途
该数据集可用于回答以下问题:
- 目前技术岗位招聘信息中提及AI技能的占比,以及该占比的增长速度。
- 生成式AI技能(
tier = genai)与经典机器学习技能(tier = ml)的增长速度对比。 - 初级岗位对AI技能的要求情况(通过资历级别维度分析)。
- 不同职位类别(如数据、工程、产品、DevOps、安全)对AI技能需求的速度差异。
- AI技能是硬性要求还是加分项(通过
required_count与listings_with_ai字段分析)。
数据列说明
| 列名 | 类型 | 描述 |
|---|---|---|
snapshot_date |
字符串 | 快照的UTC日期(YYYY-MM-DD格式) |
category |
字符串 | 职位类别:data(数据)、engineering(工程)、product(产品)、devops(DevOps)、security(安全)或 ai(AI) |
seniority |
字符串 | 资历级别:all(全部)、entry(入门)、mid(中级)、senior(高级)、lead(领导)或 unknown(未知) |
tier |
字符串 | AI技能层级:genai(生成式AI,如RAG和微调)、ml(经典ML,如PyTorch和scikit-learn)或 any_ai(任意AI) |
listings_with_ai |
数值 | 提及至少一种该层级技能的有效招聘信息数量 |
total_listings |
数值 | 该快照日期下,该职位类别/资历级别组中的全部有效招聘信息数量 |
pct |
数值 | listings_with_ai 占 total_listings 的百分比 |
required_count |
数值 | 将该层级技能列为硬性要求(非加分项)的招聘信息数量。部分历史行此字段为空 |
数据构建方法
每天,数据集会抓取来自公开公司招聘页面和招聘网站的所有有效招聘信息,使用精心设计的分类体系从招聘文本中提取技能,并记录每个AI技能层级下提及至少一种技能的招聘信息占比。占比是基于每条招聘信息计算的,即一条招聘信息中提及五种AI技能也仅计为一次。完整方法论及已知局限性请参阅:https://www.datamatastudios.com/methodology。
引用格式
Datamata Studios. "Datamata AI Requirements Index." 2026-07-11. https://www.datamatastudios.com/datasets/ai-requirements-index. Licensed under CC BY 4.0.