
遇见数据集

stefanocarrera/autophagycode_D_he_train-mercury_Qwen3-4B_strategy_trust_t1.25_g7_run2_metrics

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

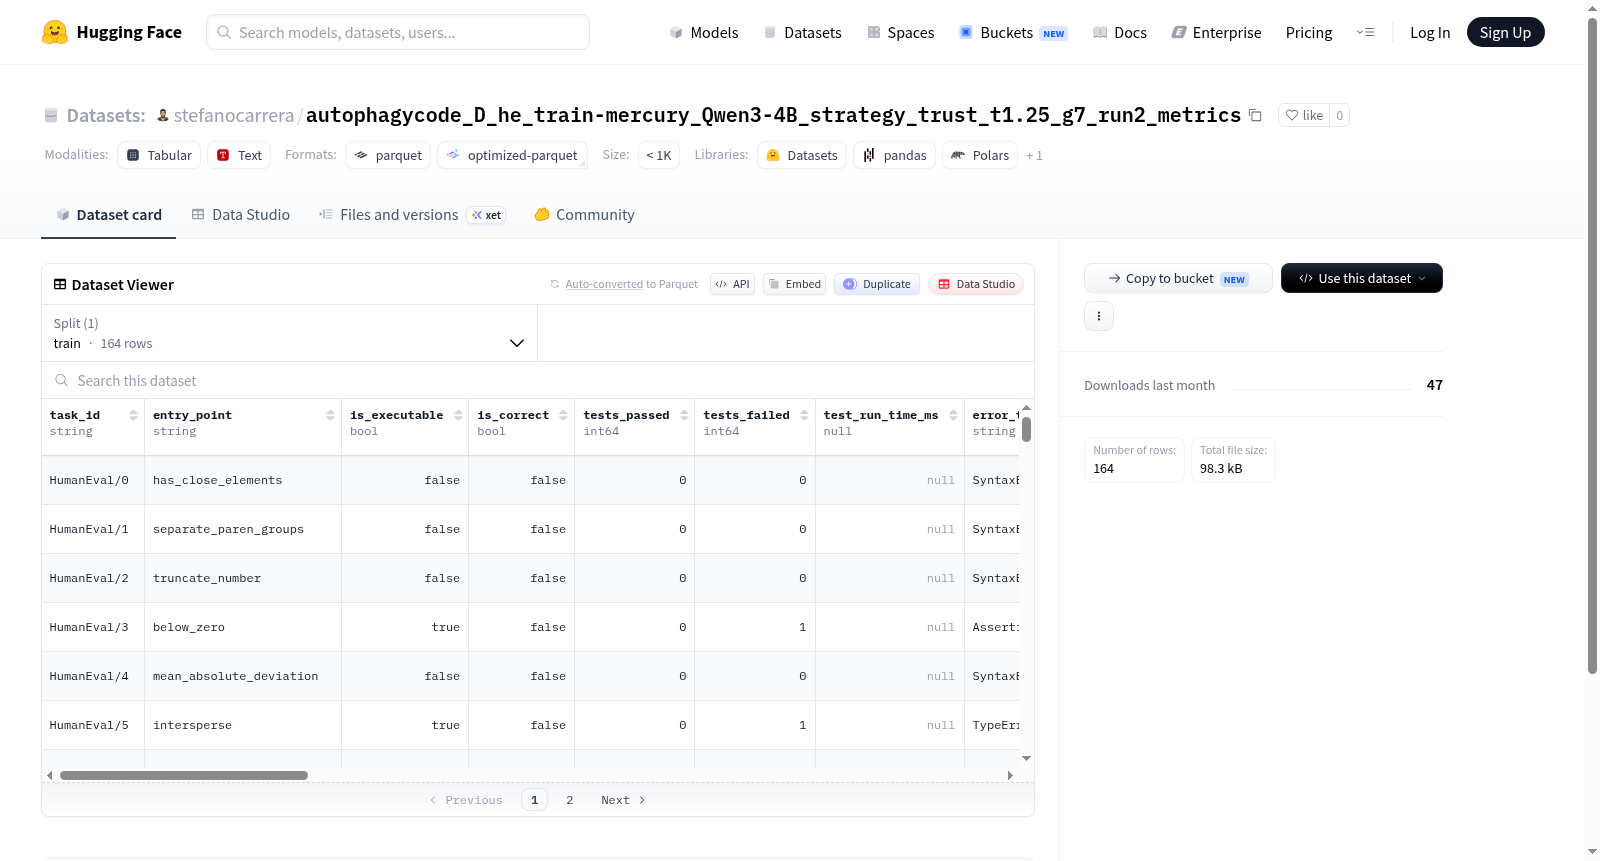
--- dataset_info: features: - name: task_id dtype: string - name: entry_point dtype: string - name: is_executable dtype: bool - name: is_correct dtype: bool - name: tests_passed dtype: int64 - name: tests_failed dtype: int64 - name: test_run_time_ms dtype: 'null' - name: error_type dtype: string - name: halstead_vocabulary dtype: int64 - name: halstead_length dtype: int64 - name: halstead_volume dtype: float64 - name: halstead_difficulty dtype: float64 - name: halstead_effort dtype: float64 - name: halstead_time dtype: float64 - name: cyclomatic_complexity dtype: int64 - name: maintainability_index dtype: float64 - name: loc dtype: int64 - name: sloc dtype: int64 - name: comment_percentage dtype: float64 - name: TTR dtype: float64 - name: token_dict dtype: string - name: shannon_entropy dtype: float64 - name: mean_predictive_entropy dtype: float64 - name: max_predictive_entropy dtype: float64 - name: n_func_defined dtype: int64 - name: entry_point_repeated dtype: bool splits: - name: train num_bytes: 224804 num_examples: 164 download_size: 94422 dataset_size: 224804 configs: - config_name: default data_files: - split: train path: data/train-* ---
提供机构:
stefanocarrera
搜集汇总
数据集介绍
stefanocarrera/autophagycode_D_he_train-mercury_Qwen3-4B_strategy_trust_t1.25_g7_run2_metrics 数据集图片
构建方式
该数据集名为 autophagycode_D_he_train-mercury_Qwen3-4B_strategy_trust_t1.25_g7_run2_metrics,是围绕代码生成模型Qwen3-4B在特定策略(trust策略,温度参数1.25,生成7个候选)下的推理结果构建而成的评估数据集。数据集的构建基于自动化代码执行与静态分析流水线:首先,针对每个编程任务(task_id)获取模型生成的代码,并检查其是否可执行(is_executable)以及是否通过功能性测试(is_correct、tests_passed、tests_failed);随后,引入Halstead复杂度指标(词汇量、长度、体积、难度、工作量、时间)和圈复杂度,从代码结构层面量化程序复杂性;进一步,通过可维护性指数、代码行数(loc、sloc)和注释百分比反映代码风格;最终结合香农熵、最大与平均预测熵等不确定性度量,形成多元化的代码质量与复杂性评估体系。
使用方法
本数据集以HuggingFace Datasets格式发布,支持通过datasets库直接加载,默认配置下包含164条训练样本。用户可通过条目级字段进行细粒度分析:例如,利用tests_passed和tests_failed字段评估生成代码的功能完整性,借助halstead_effort与halstead_time衡量代码复杂度,或基于shannon_entropy与mean_predictive_entropy探索模型生成的不确定性规律。数据集设计支持多种下游任务,包括但不限于代码质量预测、模型生成策略比较、错误类型归因分析以及代码复杂度与正确性的关系研究。建议用户结合具体研究目标,选择相关特征进行定制化统计建模或可视化分析。
背景与挑战
背景概述
该数据集由自主代码(autophagycode)研究团队创建,旨在评估大语言模型(如Qwen3-4B)在代码生成任务上的性能与质量。数据集构建于2025年,核心研究问题在于量化模型生成代码的可执行性、正确性、复杂度及可维护性等多维指标,以揭示当前模型在自动化编程中的优势与局限性。通过采集164条训练样本,该数据集综合了Halstead复杂度、圈复杂度、维护指数、香农熵等代码度量,为代码智能研究提供了细粒度的评价基准,对推动大语言模型在软件工程领域的应用具有重要参考价值。
当前挑战
该数据集面临的挑战主要来自两方面:其一,领域问题层面,大语言模型生成的代码常存在可执行率低、错误类型多样、测试通过率波动大等痛点,且代码的复杂度与可维护性难以兼顾,例如圈复杂度与维护指数之间的平衡关系尚未得到系统建模;其二,构建过程中,数据集规模较小(仅164条样本),且指标维度多达24个,如何从高维稀疏特征中提取有效信号、避免过拟合,同时确保不同代码度量(如Halstead时间与预测熵)之间的独立性与一致性,仍是亟待克服的技术难点。
常用场景
经典使用场景
在代码生成与程序合成领域,autophagycode_D_he_train-mercury_Qwen3-4B_strategy_trust_t1.25_g7_run2_metrics 数据集为评估与微调大型语言模型(LLM)的代码生成能力提供了精准的度量标准。该数据集囊括了任务标识、可执行性标志、测试通过率、错误类型以及丰富的代码复杂度指标,如圈复杂度、Halstead 度量和可维护性指数。研究者可借助这些结构化信息,深入分析模型生成的代码在功能正确性、鲁棒性和可读性上的表现,尤其适用于对比不同模型或解码策略在代码合成任务中的效用,例如在 trust 策略下温度系数为 1.25 时的输出质量。
解决学术问题
该数据集有效解决了当前学术界对代码生成模型评估维度单一、缺乏细粒度量化体系的痛点。传统方法多依赖基于测试用例的功能性通过率,难以捕捉代码的内在质量与潜在缺陷。而本数据集通过记录测试失败类型、执行时间及多维度软件工程指标,使得研究者能够系统性地剖析模型在逻辑漏洞、资源效率及维护成本等方面的问题。这不仅推动了从“功能正确”到“综合质量”评估范式的演进,也为构建更可靠、可解释的代码智能系统提供了数据驱动的研究基石。
实际应用
在实际应用层面,该数据集可用于自动化代码评审与辅助开发工具的质量监控。例如,在代码补全或修复场景中,开发者可依据数据集中的可维护性指数与圈复杂度筛选出易于集成的高质量生成代码。此外,数据集中记录的测试通过率与错误类型能够直接服务于持续集成/持续部署(CI/CD)流水线,自动标记存在高风险的代码片段,从而降低人工审查成本。这些特性使其成为保障企业级代码生成服务安全性与可靠性的宝贵资源。
数据集最近研究
最新研究方向
当前,在大规模语言模型与代码智能的交叉领域中,围绕代码生成与执行验证的评估范式正经历深刻变革。该数据集聚焦于模型生成代码的可执行性、正确性及测试通过率,并首次系统性地引入了哈斯泰德复杂度、圈复杂度、可维护性指数及香农熵等多维软件度量指标,旨在从功能性与代码质量双重视角衡量模型输出。这一研究方向紧密切合了近年来业界对‘可信任代码生成’的高度关注,尤其是在大模型在自动化编程、低代码平台及持续集成管道中广泛应用后,如何量化生成代码的鲁棒性与可维特性成为热点。数据集通过精细的 token 级熵值与 TTR(Type-Token Ratio)分析,揭示了模型预测的不确定性在代码生成中的独特表征,为理解模型内部决策机制提供了新颖的观测窗口,对推动大模型在软件工程中的安全落地具有重要方法论意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

