遇见数据集

nutrition-table-dataset

收藏
Hugging Face2026-07-26 更新2026-07-27 收录
官方服务:

资源简介:

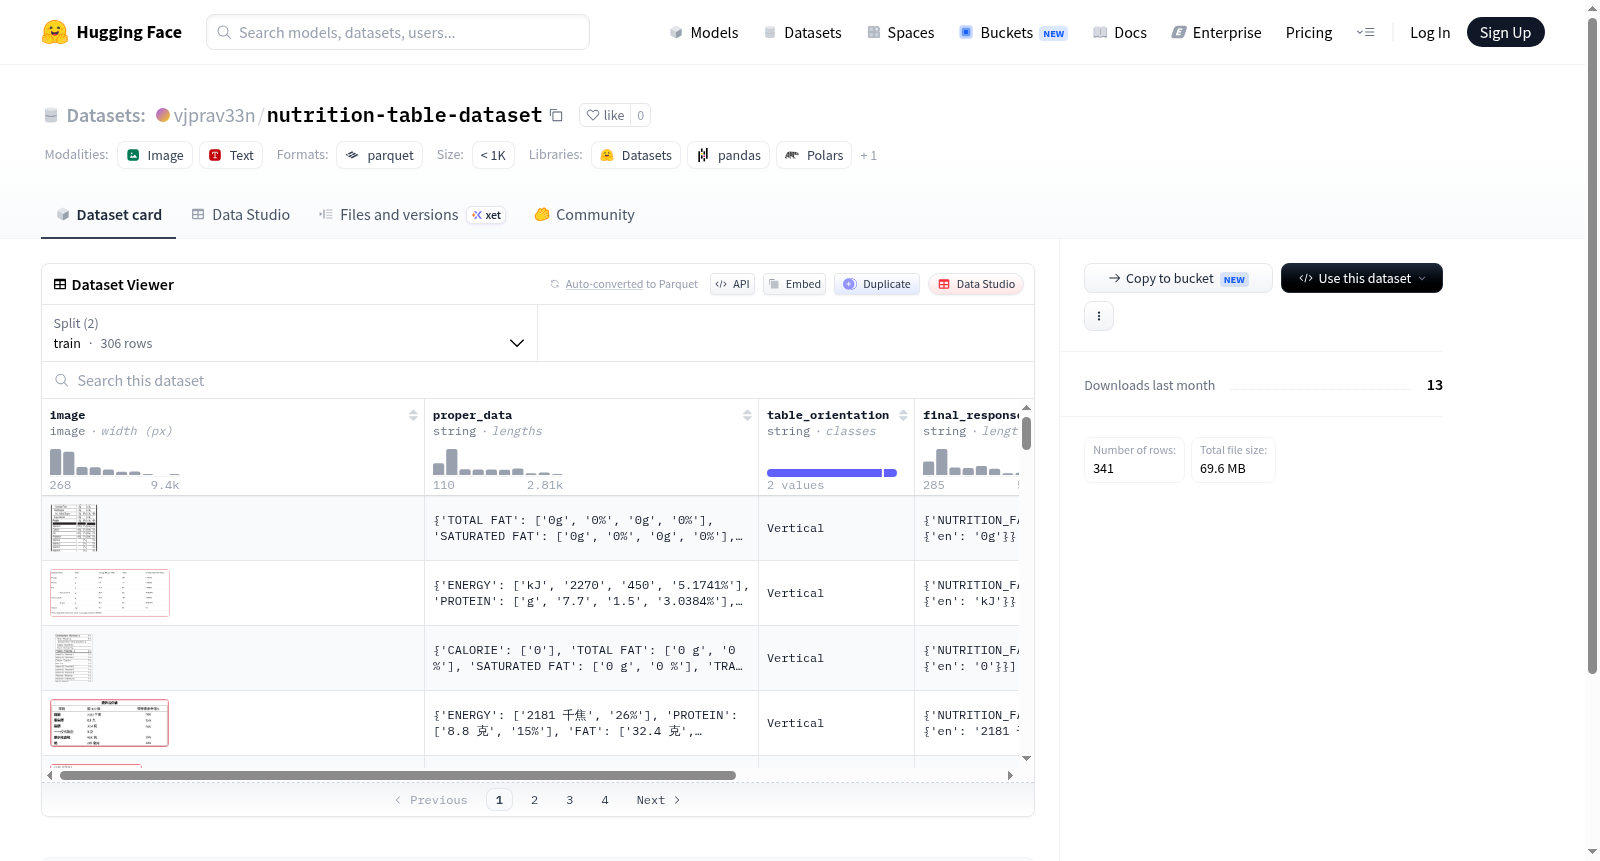
该数据集是一个结构化表格图像处理数据集,包含341个样本,划分为306个训练样本和35个测试样本。数据集包含五个核心特征字段:图像字段(image)存储表格图像数据;proper_data字段以字符串格式存储表格的规范数据;table_orientation字段记录表格的方向信息;final_response字段包含最终处理响应;Table_Format字段为分类标签,标识表格的格式类型,包括Excel、Metatable和PDF三种类别。数据集总大小约为72.47MB,适用于表格图像识别、表格格式分类、表格方向检测以及表格数据提取与响应生成等相关计算机视觉与自然语言处理任务。

This dataset is a structured table image processing dataset containing 341 samples, divided into 306 training samples and 35 test samples. It includes five core feature fields: the image field stores table image data; the proper_data field stores standardized table data in string format; the table_orientation field records table orientation information; the final_response field contains the final processing response; and the Table_Format field is a classification label identifying the table format type, including three categories: Excel, Metatable, and PDF. The total dataset size is approximately 72.47MB, and it is suitable for computer vision and natural language processing tasks such as table image recognition, table format classification, table orientation detection, and table data extraction with response generation.

创建时间:
2026-07-26
原始信息汇总

数据集概述

  • 数据集名称nutrition-table-dataset
  • 平台来源:Hugging Face Datasets
  • 数据集大小:约 72.47 MB(下载大小约 69.56 MB)

特征字段

字段名 类型 描述
image 图像(image) 包含营养表的图像数据
proper_data 字符串(string) 正确的数据内容
table_orientation 字符串(string) 表格的朝向(如横向或纵向)
final_response 字符串(string) 最终响应结果
Table_Format 分类标签(class_label) 表格格式,包括:Excel、Metatable、PDF

数据集划分

  • 训练集(train):306 个样本,占用约 64.71 MB
  • 测试集(test):35 个样本,占用约 7.76 MB

配置与文件路径

  • 配置名称default
  • 数据文件结构
    • 训练集:data/train-*
    • 测试集:data/test-*
搜集汇总
数据集介绍
nutrition-table-dataset 数据集图片
构建方式
该数据集聚焦于食品营养领域,旨在为多模态表格理解任务提供高质量的训练与评估资源。其构建基于对多样化营养表格图像的采集与标注,涵盖Excel、元数据表(Metatable)及PDF三种形式的表格数据,每张图像均附有对应的结构化描述文本(proper_data)、表格朝向信息(table_orientation)以及最终答案(final_response)。数据集共包含341个样本,按8.7:1的比例划分为训练集(306例)与测试集(35例),确保了模型学习的充分性与验证的严谨性。
特点
数据集的一个核心特色在于其多模态与多格式的融合设计:图像与文本标签并存,支持视觉与语义的联合建模。三种表格格式的引入(Excel、Metatable、PDF)覆盖了实际应用中的常见场景,增强了数据集的现实代表性。同时,表格朝向维度(如横向或纵向)的标注,有助于模型理解空间布局对表格内容的影响。所有样本均经过人工校验与标准化处理,保证了标签的高准确性与一致性。
使用方法
该数据集适用于多模态大模型(如视觉语言模型)的训练与评估,特别针对表格理解与问答任务。用户可通过HuggingFace Datasets库中的load_dataset函数加载数据,并按默认配置获取训练集与测试集。在模型使用时,可将图像与对应的问题文本(如proper_data)作为输入,让模型输出结构化答案(final_response)。建议结合OCR或表格检测模块进行预处理,以充分发挥多模态信息的协同效应。
背景与挑战
背景概述
在食品营养与健康研究领域,结构化表格数据的提取与分析对于自动化膳食评估、营养数据库构建至关重要。nutrition-table-dataset数据集由相关研究机构于近期创建,专注于从图像中识别和提取营养信息表格,其核心研究问题在于解决非结构化图像中表格的语义理解与格式转换。该数据集包含341个样本,涵盖Excel、Metatable和PDF三种表格格式,为计算机视觉与文档分析领域的交叉研究提供了基准资源。通过定义表格方向、内容正确性等标注,该数据集推动了营养信息数字化技术的发展,对智能饮食监测、临床营养决策支持系统具有显著影响力。
当前挑战
该数据集面临的核心挑战包括领域问题与构建过程两方面。在领域层面,营养表格通常包含混合排版(如合并单元格、跨页表格)、多语言文本及复杂数学符号,且实际场景中图像质量参差(如反光、阴影),导致传统OCR与表格检测方法难以精准还原结构化信息。在构建过程中,数据集规模有限(仅341个样本),难以覆盖真实世界中营养表格的多样性;人工标注表格格式与方向需耗费大量专家时间,且不同标注者间的一致性难以保证,易引入主观偏差;此外,PDF、Excel等不同源图像的预处理(如去偏斜、分辨率归一化)缺乏统一标准,增加了模型泛化难度。
常用场景
经典使用场景
在食品科学与营养健康领域,结构化数据对于构建精准膳食评估系统至关重要。nutrition-table-dataset数据集汇聚了来自不同来源的营养成分表格图像及其对应的结构化文本信息,成为训练多模态模型从表格图像中自动提取营养数据的标杆资源。研究者常利用该数据集训练OCR与表格结构识别模型,将非结构化的营养标签、菜单或食谱图像转化为可查询的键值对形式,从而支撑后续的大规模营养分析。
实际应用
在实际场景中,该数据集赋能了智能营养管理工具的研发。例如,移动端应用可借助基于此数据集训练的模型,拍摄食品包装上的营养成分表,即时解析出能量、蛋白质、脂肪等核心指标,帮助用户追踪每日摄入。此外,餐饮企业的数字化菜单系统亦能利用该技术自动生成标准化的营养数据库,不仅优化了菜单规划与过敏原标注流程,还为个性化膳食推荐服务奠定了数据基础。
衍生相关工作
基于nutrition-table-dataset,学术界涌现了一系列里程碑式工作。其中,TableFormer与TAPAS等模型针对表格结构化理解进行了专项优化,通过对比学习与位置编码技术,显著提升了表格单元格的语义匹配精度。另有工作将其与PubMed食品文献结合,创建了跨模态检索框架,实现了从文献图表到结构化知识库的自动转化。这些衍生研究共同推动了文档智能在垂直食品领域的成熟应用。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务