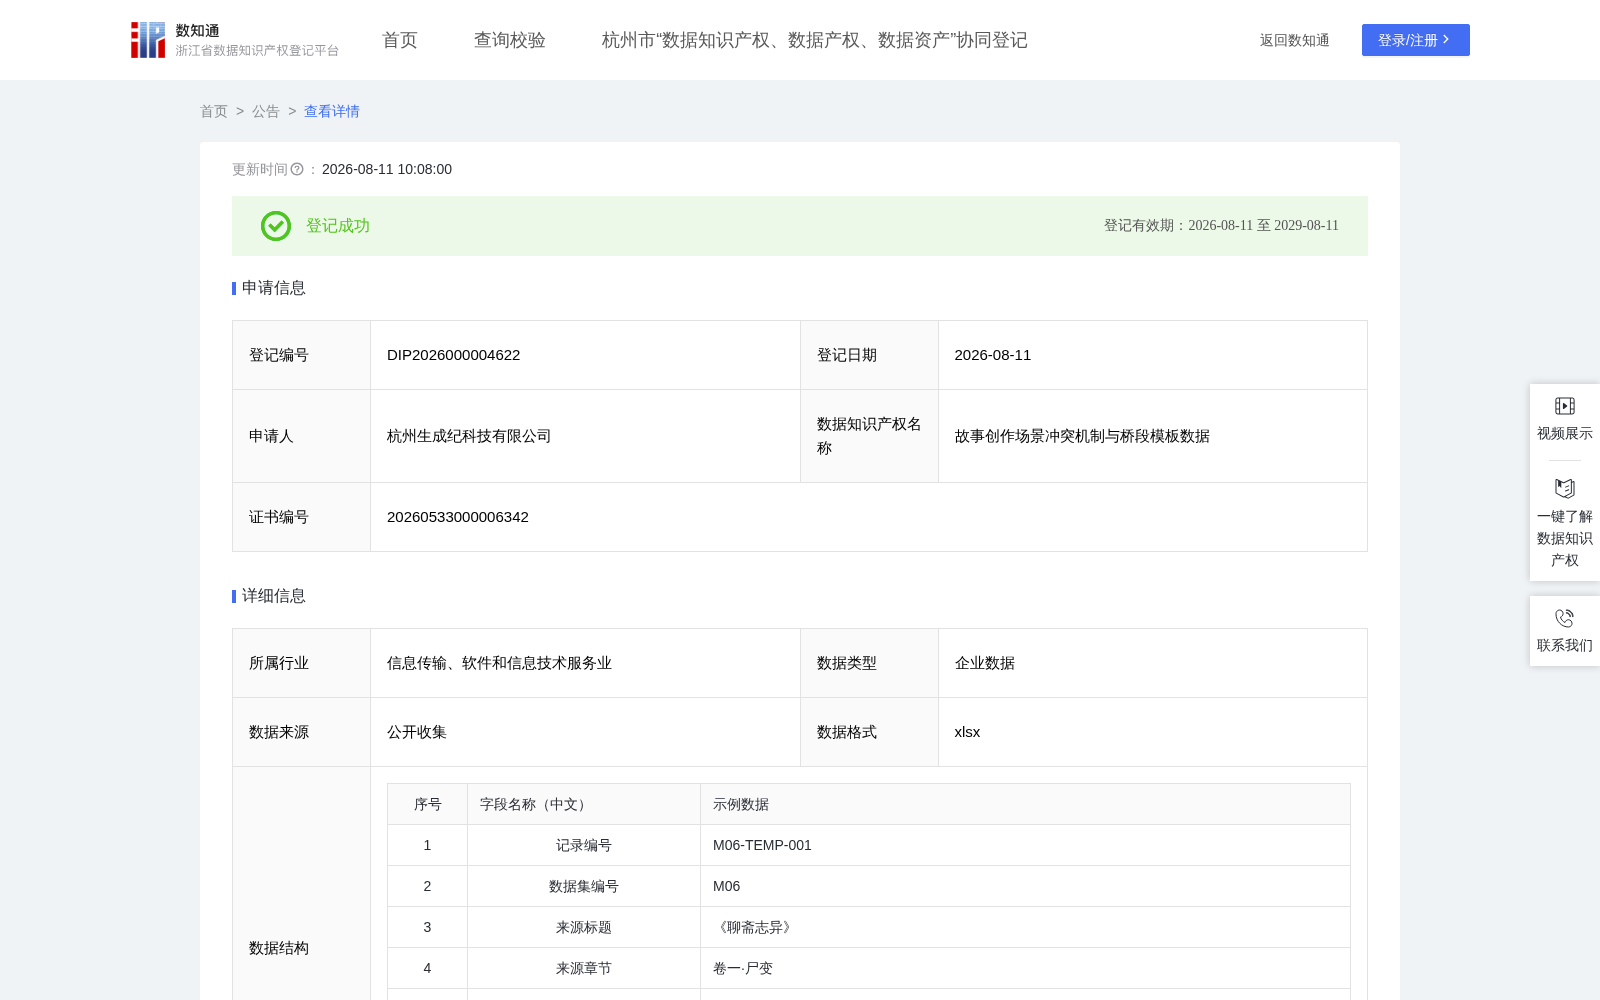
故事创作场景冲突机制与桥段模板数据
收藏资源简介:
本数据适用于ai辅助创作场景、剧情策划、素材检索及数字内容研发等场景,可支持小说、剧本、短剧、漫剧、口播故事、互动叙事、故事大纲等内容生产。加工前数据为非结构化叙事文本,原始材料主要用于阅读、研究和资料查阅,尚未形成能够直接服务故事创作和内容生成系统调用的冲突机制数据。申请人围绕场景冲突设计和桥段组织需求,建立“来源整理—冲突识别—结构提炼—迁移映射—质量复核—输出存证”的处理流程。 具体处理规则如下: 1. **来源整理与文本规范化:**登记来源书名、篇章定位和关键摘录,对文本格式、缺漏情况和来源可回溯性进行检查; 2. **冲突桥段识别:**识别材料中是否存在明确的冲突双方或多方关系、触发事件、压力来源、行动对抗和后果变化,筛除仅有结论、评价或背景描述的内容; 3. **结构要素提炼:**从有效片段中提炼冲突类型、冲突参与关系、触发事件、压力来源、冲突升级链、反转/揭底/破局节点和冲突后果; 4. **创作迁移映射:**将具有可迁移价值的结构提炼为桥段模板,并标注可用于剧情卡、章节卡、场景卡、爽点破局、悬疑揭露、轻喜剧翻车或短剧分镜等应用方向; 5. **质量分级与人工复核:**依据来源清楚程度、结构完整性、迁移价值和字段一致性进行质量判断,对存在跨库混入、冲突链不完整、来源不清或过度推断的记录进行退回或修订; 6. **格式检查与输出存证:**对空字段、重复记录、枚举口径、来源回溯和数据格式进行检查,形成可用于登记、调用和授权合作的结构化数据文件。 在生产过程中,可使用生成式人工智能工具辅助进行候选片段识别、字段初步提炼和格式整理,但有效记录的纳入、字段内容确认、来源核验、质量判断及最终提交均由申请人依据统一规则进行人工复核确认。 处理后的数据主要字段包括:记录编号、数据集编号、来源书名、来源篇章、原文摘录、结构化提炼摘要、主题标签、适用创作环节、质量等级、复核备注、冲突类型、冲突双方或多方关系、冲突触发事件、压力来源、冲突升级链、反转/揭底/破局节点、冲突后果和可迁移桥段模板等。