
ghananlpcommunity/ghanaian-research-english-sentences
收藏官方服务:
资源简介:
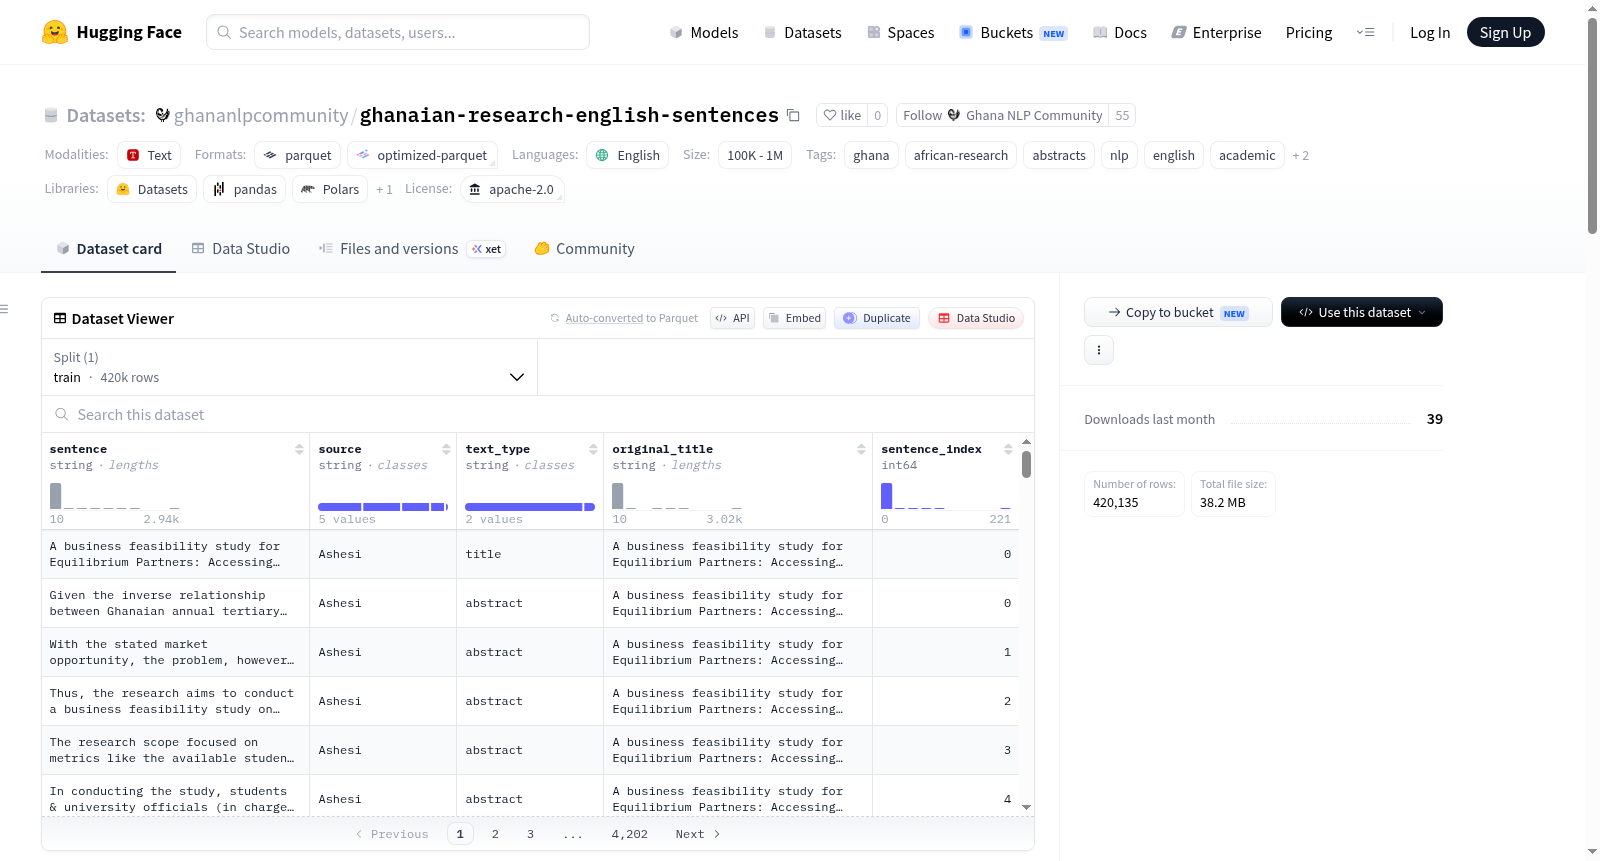
该数据集是Ghanaian Research English Dataset的句子级别、分词版本,将每篇研究标题和摘要分割成单独的句子。它适用于句子级别的自然语言处理任务,如语言建模、语义相似性、句子嵌入和文本分类。数据集包含来自加纳多所大学(如KNUST、UG、UCC、UEW、Ashesi)的研究论文句子,总句子数为420,135条,其中40,288条来自标题,379,847条来自摘要,并经过去重处理。语言为英语,使用NLTK的sent_tokenize进行分词。
A sentence-level, tokenized version of the Ghanaian Research English Dataset that splits every research title and abstract into individual sentences. It is useful for sentence-level NLP tasks such as language modeling, semantic similarity, sentence embeddings, and text classification.
提供机构:
ghananlpcommunity搜集汇总
数据集介绍
构建方式
该数据集源自加纳研究英语数据集,经由NLTK库的sent_tokenize工具将每篇研究标题与摘要切割为独立句子,并完成去重处理。最终汇集了来自KNUST、UG、UCC、UEW及Ashesi五所高校的420,135条句子,其中标题句子40,288条,摘要句子379,847条,形成结构化的句子级语料库。每条数据包含句子文本、来源机构、文本类型(标题或摘要)、原始标题及句子在源文本中的位置索引。
特点
数据集以句子为基本单元,特别适用于句子级别的自然语言处理任务,如语言建模、语义相似度计算、句子嵌入及文本分类。其跨机构、多领域的学术内容为模型训练提供了丰富的语义多样性,且经过去重处理确保了数据质量。此外,清晰标注的源信息和句子位置索引便于研究者追溯上下文,支持更精细的语义分析任务,如主题分割和学术文本结构研究。
使用方法
用户可通过HuggingFace的datasets库直接加载该数据集,指定split为'train'即可获取训练数据。数据字段包括'sentence'(句子文本)、'source'(来源机构)、'text_type'(标题或摘要)、'original_title'(原始标题)和'sentence_index'(句子索引),便于灵活筛选与组合。适用于训练句子嵌入模型、开展语义相似度比对或构建句子分类器。建议在使用前按需过滤文本类型或来源机构,以适应特定研究场景。
背景与挑战
背景概述
该数据集由加纳自然语言处理社区(Ghana NLP Community)于近期创建,专注于提供加纳高校研究论文的句子级英文语料。核心研究问题在于弥补非洲学术语境下高质量、细粒度自然语言处理资源的匮乏,尤其是针对句子级任务如语言建模、语义相似度计算与文本分类。数据集涵盖加纳五所主要高校(包括夸梅·恩克鲁玛科技大学、加纳大学等),总计超过42万条去重句子,为非洲英语变体与学术文本分析提供了珍贵基准,对推动低资源区域NLP研究具有显著影响力。
当前挑战
该数据集面临的挑战首先体现在领域问题层面:现有句子级模型多基于通用或高资源语料训练,对非洲学术写作的句法结构、术语表达及语义模式适应性较弱,亟需定制化建模。构建过程中亦遭遇多重困难,包括多源异构数据(不同大学的摘要与标题)的格式统一、跨学科术语的歧义消除,以及利用NLTK进行自动句子分割时对非标准标点与缩写词的处理精度问题。此外,确保数据代表性以涵盖加纳各地学术话语,同时维持Apache 2.0开源许可下的可用性,也是持续优化的关键难题。
常用场景
经典使用场景
该数据集将加纳高校研究摘要与标题拆解为420,135条独立句子,覆盖KNUST、UG等五所机构,是非洲学术英语句子级资源的重要补充。它特别适用于训练句级语言模型、评估句子嵌入质量以及开展语义文本相似度研究,为低资源语境下的自然语言处理提供了规整且去重的语料基础。
解决学术问题
在学术研究中,非洲本土学术文本的句子级标注资源长期匮乏,限制了跨领域模型在多样化写作风格中的泛化能力。该数据集通过系统化处理加纳科研文献,解决了学术英语语境下句子边界不统一、主题分布不均等常见障碍,为句子分类、主题分割等任务注入了地域特色浓厚的验证素材,推动了对南半球科研话语体系的理解。
衍生相关工作
基于该句子级数据集,衍生出了若干关键工作方向,包括利用其训练面向非洲学术领域的专用句子编码器、增强跨机构论文间的语义对齐能力,以及开发针对研究标题与摘要的细粒度分类模型。这些工作共同拓展了原有语料库的应用边界,使句子级特征提取与下游任务间的衔接更加稳健。
以上内容由遇见数据集搜集并总结生成


