
遇见数据集

parsaidp/swe-bench-verified-raw-traces-qwen3-coder

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

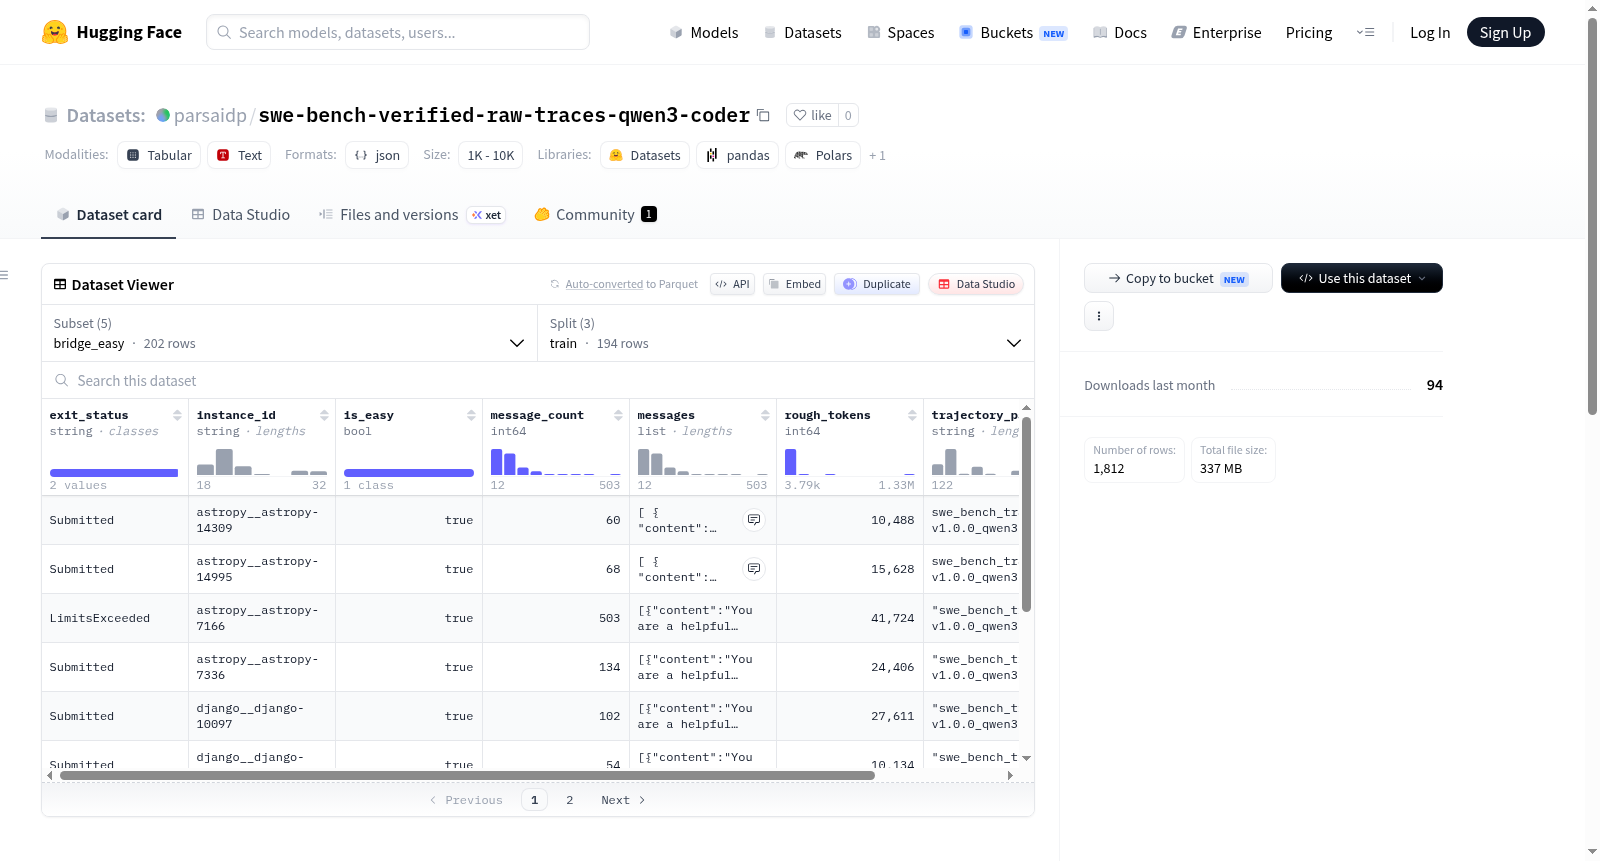
该数据集名为SWE-bench Verified raw mini-SWE-agent traces,包含来自20250802_mini-v1.0.0_qwen3-coder-480b-a35b-instruct的原始mini-SWE-agent轨迹,专门用于SWE-bench Verified任务。数据集提供多种配置:raw配置包含原始轨迹数据,其中easy分割使用来自parsaidp/SWE-bench_Verified_easy的194个实例ID,但轨迹内容是本地的mini-SWE-agent/Qwen跟踪;bridge_full和bridge_easy配置为Megatron Bridge格式的数据,适用于所有500个轨迹或仅194个easy轨迹,并分为训练、验证和测试集;此外,还有内存条件配置(如raw_memo和bridge_easy_memo),这些配置对easy子集进行了重写,将纯探索性shell调用替换为记忆回忆,并保留非探索性调用。数据集文件包括JSONL格式的轨迹数据、元数据文件(如实例ID列表和源信息),旨在支持软件工程基准测试和代理轨迹分析。

The dataset is named SWE-bench Verified raw mini-SWE-agent traces, containing raw mini-SWE-agent trajectories from 20250802_mini-v1.0.0_qwen3-coder-480b-a35b-instruct for SWE-bench Verified. It offers multiple configurations: the raw configuration includes raw trajectory data, with the easy split using exactly 194 instance IDs from parsaidp/SWE-bench_Verified_easy but with local mini-SWE-agent/Qwen traces; the bridge_full and bridge_easy configurations provide data in Megatron Bridge format for all 500 traces or only the 194 easy traces, split into training, validation, and test sets; additionally, there are memory-conditioned configs (e.g., raw_memo and bridge_easy_memo) that rewrite the easy subset by replacing purely exploratory shell calls with memory recollections and retaining non-exploratory calls. Dataset files include trajectory data in JSONL format, metadata files (such as instance ID lists and source information), and are designed to support software engineering benchmarking and agent trajectory analysis.
提供机构:
parsaidp
搜集汇总
数据集介绍
parsaidp/swe-bench-verified-raw-traces-qwen3-coder 数据集图片
构建方式
该数据集基于2025年8月2日发布的mini-SWE-agent v1.0.0版本,搭载Qwen3-Coder-480B-A35B-Instruct模型,对SWE-bench Verified基准中的500个任务实例进行推理,生成了原始的智能体轨迹。轨迹以JSON格式嵌套存储于`data/full.jsonl`中,并从中提取出194个与公开子集`parsaidp/SWE-bench_Verified_easy`匹配的实例作为简易子集。此外,采用Megatron Bridge的`vlm-preloaded`格式,将全部轨迹转换为桥接结构,分别形成`bridge/full`和`bridge/easy`两个配置,其训练集保留全部样本,验证集和测试集为确定性小样本,用于流水线测试。
特点
该数据集的核心特色在于提供了两种增强配置:一是原始轨迹的简易子集,便于快速验证;二是记忆条件化重写版(`*_memo`),将探索性Shell调用替换为“据我所知……”的回忆语句并丢弃对应的观察结果,而代码读取、编辑和测试运行等非探索性调用则保留原样并在前加上回忆前缀,其余内容(如系统提示、PR描述和最终提交)与原始轨迹字节级别一致。这种设计有效模拟了智能体具备先验知识后的行为,为研究记忆对代码修复任务的影响提供了独特视角。
使用方法
数据集通过HuggingFace Datasets库加载,支持多配置选择:`raw`和`raw_memo`分别提供原始和记忆条件化轨迹,`bridge_full`、`bridge_easy`及`bridge_easy_memo`提供桥接格式的划分数据。用户可根据需求加载对应配置的特定子集(如`full`、`easy`或`train`/`validation`/`test`),每个样本包含轨迹结构及元数据。推荐使用`load_dataset`函数指定`config_name`和`split`参数,例如加载`bridge_easy`的训练集,即可获得预处理的视觉-语言模型输入格式,适用于微调或评估智能体在代码修复任务中的表现。
背景与挑战
背景概述
在软件工程领域,自动化代码修复与调试一直是人工智能系统面临的重大挑战。swe-bench-verified-raw-traces-qwen3-coder数据集由研究团队于2025年8月创建,其核心研究问题聚焦于评估大规模语言模型在真实软件工程任务中的轨迹生成与问题解决能力。该数据集基于SWE-bench Verified基准,包含了来自mini-SWE-agent系统与Qwen3-Coder-480B-A35B-Instruct模型的500条原始轨迹,覆盖完整与简易子集,并延伸出桥接格式与记忆增强版本,为研究模型在代码导航、编辑及调试中的行为模式提供了标准化素材。该数据集在代码大模型评测领域具有重要影响力,为揭示模型在复杂软件仓库环境中的推理与操作能力提供了关键数据支持。
当前挑战
当前数据集面临的核心挑战包括:所解决的领域问题为自动化软件工程修复中模型轨迹的可靠性与可解释性评估,即如何在真实代码库中精确衡量模型执行导航、读取、编辑与验证等操作的效率与准确性,避免因探索性shell调用引入的冗余和噪声。构建过程中遇到的挑战涉及轨迹数据的统一格式转换与子集划分,例如将500条原始轨迹可靠地转化为Megatron Bridge模型所需的JSONL格式,同时确保训练、验证和测试集的无泄漏分配。此外,记忆增强版本的改写需精准区分探索性与非探索性调用,避免修改系统提示与最终提交,对数据预处理逻辑的严谨性提出了高要求。
常用场景
经典使用场景
在软件工程与人工智能的交叉领域,SWE-bench Verified Raw Traces Qwen3 Coder数据集作为一款高质量的代码智能体行为轨迹数据集,其经典使用场景聚焦于探究大语言模型驱动的代码自动修复与软件工程任务的执行机制。该数据集源自mini-SWE-agent框架在SWE-bench Verified基准上的运行时状态记录,包含了Qwen3-Coder模型进行真实软件仓库问题修复的完整轨迹,为研究者提供了从命题描述、环境探索到代码编辑与测试验证的全流程行为快照。这些轨迹数据被广泛应用于训练和评估代码智能体,尤其是在指令学习、推理链建模以及任务分解策略等方向,成为理解语言模型如何在复杂软件环境中自主决策与纠错的宝贵素材。
解决学术问题
该数据集的问世有效回应了软件工程与自然语言处理领域中一个关键学术挑战:如何系统性地捕捉并分析语言模型在真实代码仓库中进行问题定位与修复时的行为模式。传统研究往往依赖静态结果指标(如修复成功率)来衡量模型性能,而忽视了中间探索与决策过程的异质性。通过提供细粒度的原始轨迹信息,研究者能够深入剖析智能体在搜索代码库、阅读相关文件、运行测试用例等环节的表现,从而揭示不同策略对最终修复效果的因果影响。这一数据资源的出现,极大推动了关于智能体规划能力、错误恢复机制以及知识记忆利用等学术问题的实证研究,为构建更为鲁棒和高效的代码自主修复系统奠定了数据基。
衍生相关工作
围绕该数据集衍生了多项富有启发性的后续研究,其中最具代表性的是基于Megatron Bridge格式转换后的训练数据格式,催生了多模态代码智能体联合训练的范式探索。记忆条件版本的轨迹数据(memo变体)则直接启发了关于知识蒸馏与内部回忆机制的工作,研究者在尝试指导模型区分无目的探索与有目的的代码阅读行为时,将此数据集作为关键实验基准。此外,easy子集与Parsa公开数据集实例ID的对应关系,促使了一系列跨模型泛化能力的对比分析,使得不同规模语言模型在同一标准化轨迹框架下的表现得以统一评估,推动了代码智能体领域实验可重复性的提高。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

