
遇见数据集

Relaxed Memory Model Zoo dataset

收藏
github2026-09-03 更新2026-09-09 收录
官方服务:

资源简介:

支持https://rmm-zoo.kissig.org的数据:硬件和编程语言的内存模型,它们之间的排序关系,每个模型的属性表,以及支持排序声明的litmus证据。

This dataset contains data from https://rmm-zoo.kissig.org, including memory models for hardware and programming languages, the ordering relationships between these models, attribute tables for each individual model, and litmus evidence that supports ordering declarations.

创建时间:
2026-08-14
原始信息汇总

数据集概述

本数据集为 Relaxed Memory Model Zoo 项目提供底层数据支撑,涵盖硬件与编程语言内存模型、模型间的排序关系、各模型的属性表,以及支撑排序论断的litmus测试证据。该仓库是数据的唯一事实来源和贡献入口,网站 rmm-zoo.kissig.org 仅负责渲染展示。

数据内容

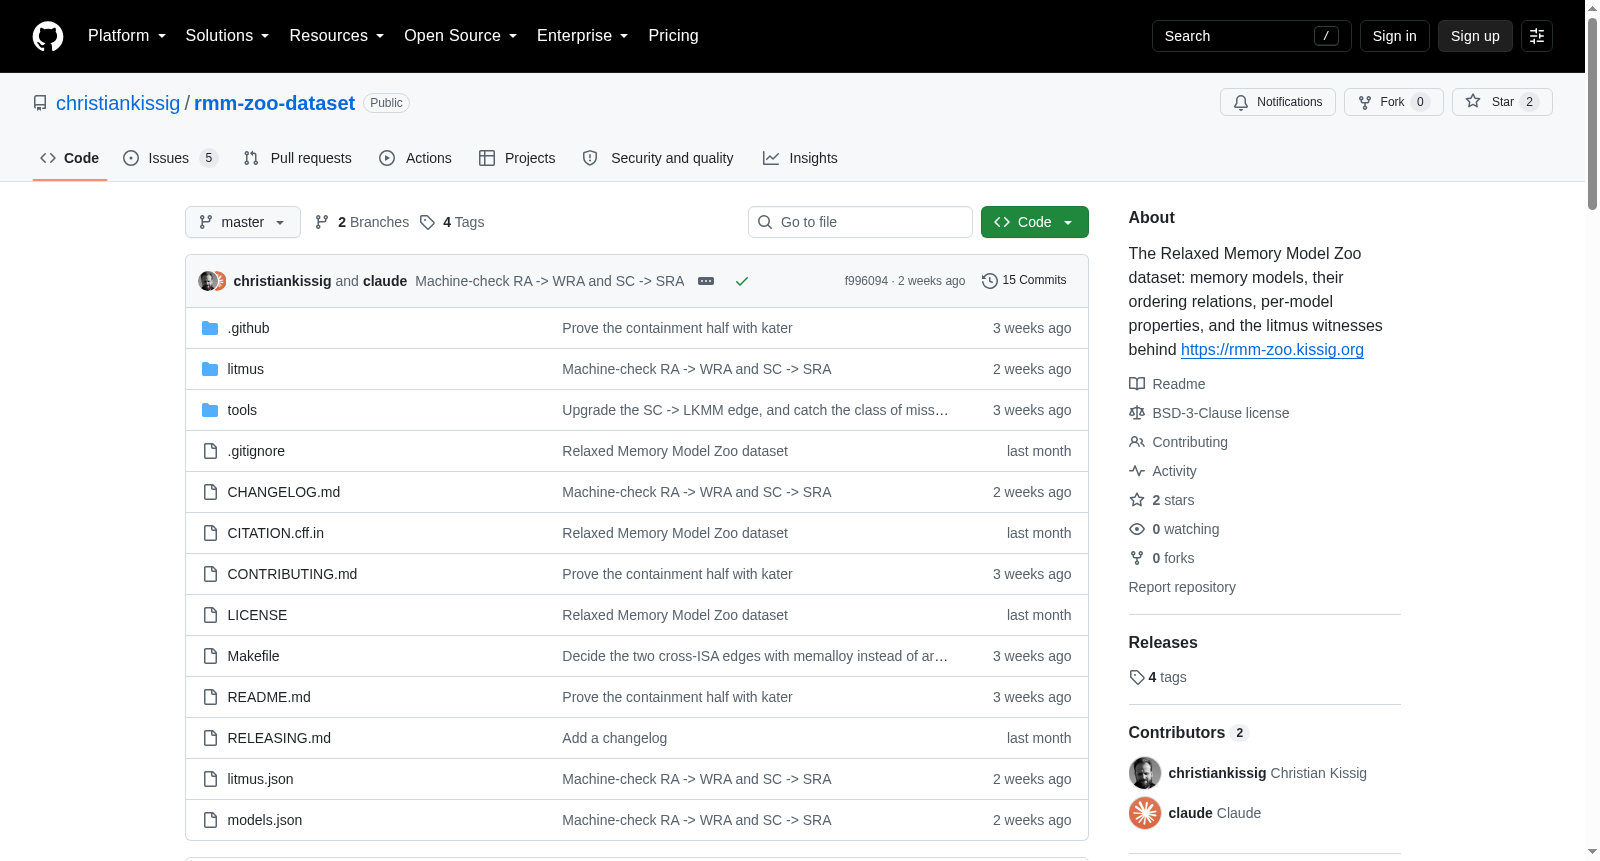
  • models.json:核心数据集文件,包含模型、边(排序关系)、参考文献、属性表、单元格溯源、cat/kat可说明性,以及由Git标签填充的版本与日期信息。
  • litmus.json:将litmus见证树整合为单个JSON文件(生成后提交)。
  • litmus/:每个排序边对应的见证测试目录,附带运行脚本。
  • litmus/kater/:机器可检查的包含关系证明文件,每个kater边对应一个查询,附运行脚本与操作手册。

核心原则

每条断言必须附带证据。排序边需记录其得知方式(来源+证据),属性单元格需标明数据出处;对于工具无法检查的断言,需明确声明,而非默认为机器已验证。make check 会尽可能机械化强制执行此规则。

数据校验机制

make check 执行以下检查:

  1. 每条边的端点必须是真实模型,且具备属性向量和带来源的cat支持条目。
  2. strictly_weaker 关系必须构成有向无环图。
  3. 每条边的类型唯一。
  4. 边的类型与方向必须与文件夹名称对应的见证一致;每个kater边都应有对应的证明查询。
  5. 每个 strictly_weakerincomparable 边须有区分性行为支持。
  6. 若 herd7 在 PATH 中,则 litmus 测试套件本身须通过。
  7. 若 kater 镜像已拉取,则包含关系套件须通过。

动态测试需 herd7(版本7.58)或 Docker(用于kater包含关系检查)环境,GitHub Actions 会在每次推送和拉取请求时自动运行两套测试。

发布与引用

  • Git 标签 vX.Y.Z 是版本的唯一来源,构建时会将版本号和日期写入 models.jsonCITATION.cff
  • 数据集发布至网站源站的 /data/ 路径下,可通过以下地址访问:
    • https://rmm-zoo.kissig.org/data/models.json
    • https://rmm-zoo.kissig.org/data/litmus.json
    • https://rmm-zoo.kissig.org/data/CITATION.cff

不包含的内容

网站的层级布局(tierMap/tierOrder/tierLabels)属于展示层设计,存放于网站仓库,不在此数据集中。新增模型会先以回退层级渲染,直到网站侧完成布局配置。

许可与引用

数据集以 3-Clause BSD License(SPDX: BSD-3-Clause)发布。数据集中的每个模型、边和属性单元格均携带独立引用信息,复用数据时需引用其原始来源。建议引用固定的版本号+标签+提交哈希。
搜集汇总
数据集介绍
Relaxed Memory Model Zoo dataset 数据集图片
构建方式
该数据集以严谨的工程化流程构建,将硬件与编程语言的内存模型、它们之间的序关系、各模型的属性表格以及支撑这些序关系的litmus测试用例,统一封装于结构化文件中。核心文件models.json汇聚了模型、边、参考文献、属性单元格及其溯源信息,并包含cat与kat规范适配性及版本日期。数据集遵循‘每一项声明都附带其证据’的铁律,通过provenance与evidence字段记录每条序关系的来源与验证方式,并利用make check工具链自动执行一系列校验,包括边的端点有效性、严格弱序关系的无环性、每条边的类型唯一性及与见证文件的匹配性,确保数据的一致性与可追溯性。机器验证部分依靠kater工具进行无界模型包含性判定,而动态litmus测试则由herd7驱动,双轨并进,共同奠定数据集的可靠性基石。
使用方法
数据集的使用途径多元且便捷。研究开发者可直接从在线站点https://rmm-zoo.kissig.org/data/下载models.json与litmus.json,或通过make build命令在本地生成。借助Python、JSON解析器等标准工具,可轻松载入数据,进行关系查询、属性比较或用作可视化图谱的底层数据源。对于验证性需求,make check命令可运行完整一致性检查,而集成环境通过GitHub Actions自动执行litmus与kater测试套件,验证边关系的正确性。此外,数据集版本与引用信息透明,用户可依据CITATION.cff规范引用特定版本与提交,确保科研成果的可追溯性。项目还欢迎社区以PR形式提交新模型、修正关系或补充证据,参与数据集的协同演进。
背景与挑战
背景概述
Relaxed Memory Model Zoo数据集由Kissig研究团队创建,旨在系统化整理硬件与编程语言内存模型及其偏序关系。该数据集源于对弱内存模型(如x86-TSO、ARM、RISC-V等)在并发编程中复杂性的关注,核心研究问题在于如何建立统一框架,精确刻画不同模型间的强弱关系及性质差异。其影响力体现在为内存模型研究提供了可验证、可追溯的权威参照,促进了形式化验证工具(如herd7、kater)的交叉验证。数据集的创新之处在于强调每条声明均附带证据,并通过GitHub Actions实现持续集成,成为该领域开源协作的典范。
当前挑战
数据集构建与维护面临多重挑战。领域层面,内存模型偏序关系的判定需处理不可判定问题,litmus测试仅能见证单向关系,而kater虽能实现无界包含判定,但对计算资源要求高,且需整合不同工具结果。构建过程中,需保证每条边类型、方向与证据严格一致,维护DAG结构,确保证据链完整。动态验证依赖herd7与kater,其环境配置复杂,版本敏感。此外,模型及关系的持续更新需平衡严谨性与社区贡献的便捷性,避免破坏既有验证体系,实现数据规模的扩展与质量的高保真并存。
常用场景
经典使用场景
松弛内存模型动物园数据集(Relaxed Memory Model Zoo)作为并发与分布式系统领域的权威资源,其核心用途在于系统化地梳理与比较硬件及编程语言所采用的内存模型。研究者利用该数据集对各模型的排序关系进行直观检索,并借助其内置的litmus测试套件,验证特定执行行为在不同模型下的可见性,从而深化对弱内存语义的理解。
解决学术问题
该数据集直面并发理论中模型关系模糊、证据分散的难题,通过为每条排序边和属性单元标注来源与验证方式,建立起可追溯的实证链条。它解决了跨模型比较缺乏统一基准的问题,使学者能严谨地论证模型间的强弱关系,推动了内存模型形式化验证与一致性理论的发展。
实际应用
在工业界,此数据集为编译器开发者、芯片验证工程师及系统程序员提供了关键参考。它帮助诊断并发程序中的异常行为,指导屏障指令的合理插入,并辅助设计符合预期语义的同步原语。其机器可读的JSON格式也便于集成至自动化工具链,提升软硬件协同设计的效率与正确性。
数据集最近研究
最新研究方向
该数据集聚焦于并发编程领域的内存模型,其前沿研究方向在于利用形式化方法与自动化工具对硬件及编程语言内存模型之间的精化关系进行系统化、可验证的刻画。随着多核处理器与异构计算架构的普及,内存一致性已成为影响系统可靠性与性能的关键,而该数据集通过整合模型间有序关系、属性表及litmus测试证据,并引入kater工具对包含关系进行无界机器验证,为内存模型的比较与确认提供了严谨的证据链基础。其强调‘每项声明均附带证据’的核心原则,推动了内存模型研究向可复现、可机器检查的方向演进,对并发算法验证、编译器优化正确性及架构设计具有重要的支撑意义,也为构建统一的内存模型理论框架贡献了宝贵的数据资产。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

