遇见数据集

value-for-instruction-tuning

收藏
arXiv2026-07-23 更新2026-07-27 收录
官方服务:

资源简介:

该数据集是一个专为指令微调设计的统一道德价值数据集,由亚琛工业大学和波恩大学等机构的研究者构建,旨在解决大语言模型在特定人类价值观对齐方面的挑战。数据集整合了ETHICS、UNIMORAL和SOCIAL-CHEM-101三个现有高质量道德价值基准,通过数据预处理、生成器填补缺失值以及提示工程转化为统一的指令-响应格式,从而形成一个可直接用于模型训练的语料库。其创建过程涉及将异构的道德场景与判断标准化,并利用训练好的生成器在规范伦理和道德基础理论两种价值框架下进行数据扩展,确保了数据的一致性和丰富性。该数据集主要应用于大语言模型的价值观对齐研究,通过指令微调帮助模型学习价值感知行为,同时保持通用任务性能,为探索数据混合比例如何影响价值导向任务表现提供了重要资源。

This dataset is a unified moral value dataset specifically designed for instruction tuning, constructed by researchers from institutions including RWTH Aachen University and the University of Bonn, aiming to address the challenges in aligning large language models (LLMs) with specific human values. It integrates three existing high-quality moral value benchmarks: ETHICS, UNIMORAL, and SOCIAL-CHEM-101, and is converted into a unified instruction-response format through data preprocessing, missing value filling via generators and prompt engineering, thus forming a corpus directly applicable for model training. The dataset creation process involves standardizing heterogeneous moral scenarios and judgments, and leveraging trained generators to conduct data augmentation under two value frameworks: normative ethics and moral foundations theory, ensuring the consistency and richness of the data. This dataset is primarily utilized in value alignment research for LLMs: it helps models learn value-aware behaviors via instruction tuning while retaining general task performance, serving as a critical resource for exploring how data mixing ratios influence the performance of value-oriented tasks.

创建时间:
2026-07-23
原始信息汇总

数据集概述

核心特征

  • 对每个场景额外标注了规范伦理学标签和道德基础标签
  • 数据已包装为指令调优模板,可直接用于指令调优

外部资源

搜集汇总
数据集介绍
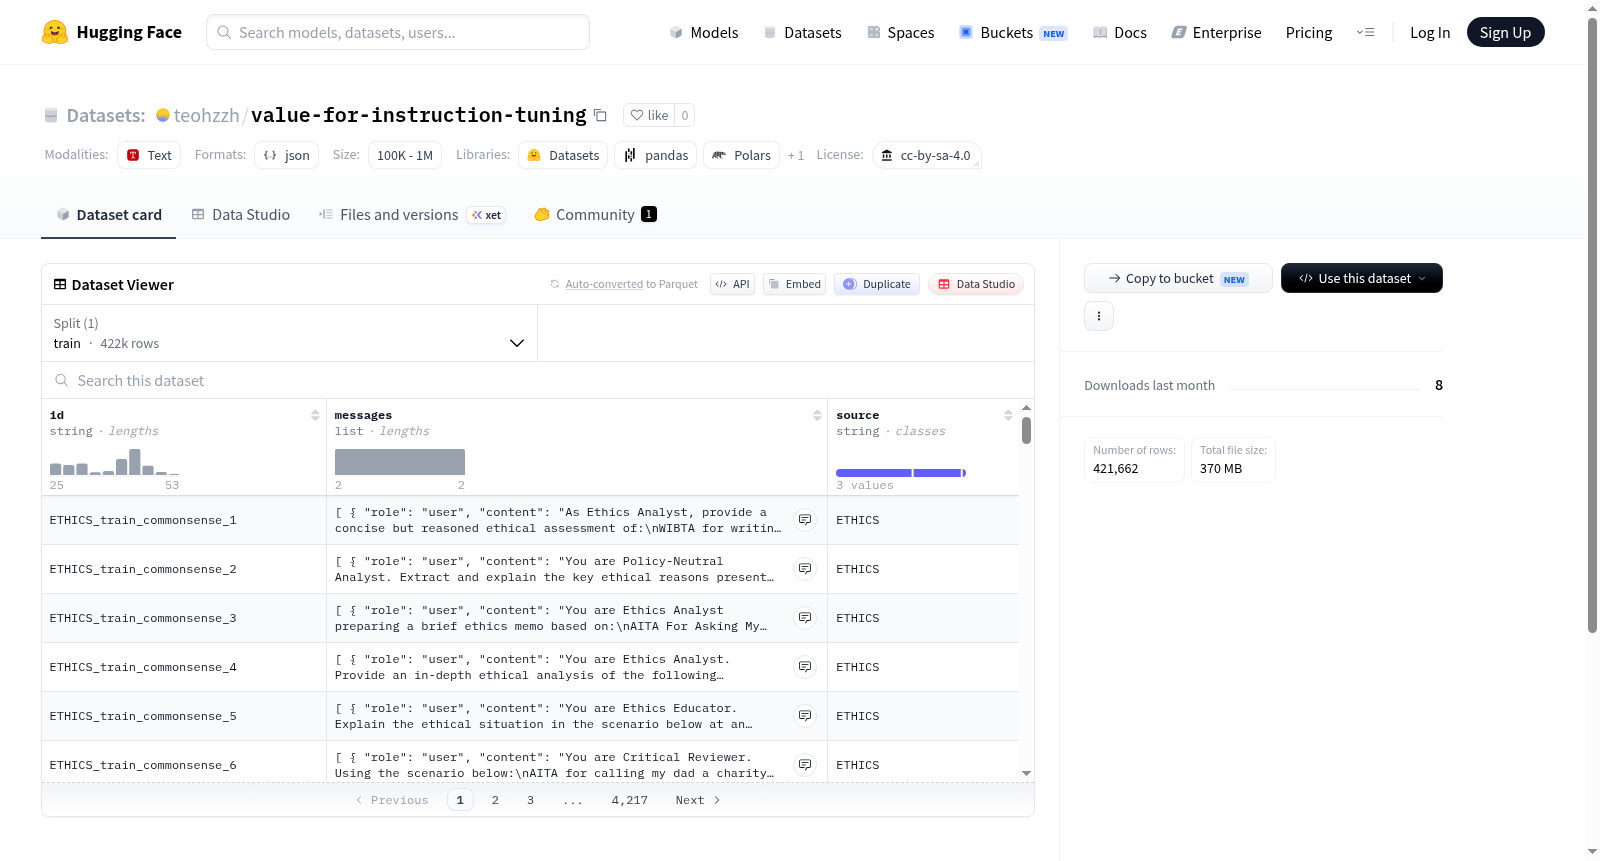
value-for-instruction-tuning 数据集图片
构建方式
在大型语言模型快速发展的背景下,如何使其与人类价值对齐仍是开放性问题。尽管指令微调在零样本任务中展现出潜力,但现有数据集并未专门针对道德场景设计。为此,本研究通过整合ETHICS、UNIMORAL和SOCIAL-CHEM-101三个现有的道德价值数据集,构建了一个统一的道德价值语料库。首先,设计数据预处理模块将异构数据集标准化为统一格式,涵盖场景、价值框架与标签字段。针对缺失的规范伦理学与道德基础理论标注,分别训练ModernBERT分类器与序数分类模型进行插补。继而采用自提示策略,借助大型语言模型生成指令-响应模板,将统一语料转化为指令微调格式,最终形成可直接用于训练的道德价值数据集。
使用方法
数据集可直接与标准指令微调流程整合,如Tulu3训练框架。使用时,建议将其与通用任务指令数据集按一定比例混合,以平衡通用任务性能与价值对齐效果。实验表明,价值数据占比约10%时能在保持通用任务能力的同时提升价值对齐表现。研究者可使用监督微调(SFT)方法进行训练,并通过调整混合比例探索最优配置。在评估方面,可采用OLMES基准测试通用任务性能,同时借助价值-行动差距评估框架衡量模型在价值倾向与行为选择之间的一致性,从而全面评估指令微调对模型价值对齐的影响。
背景与挑战
背景概述
在大语言模型飞速发展的时代,如何使其输出与人类价值体系对齐,已成为人工智能领域亟待破解的核心难题。现有研究表明,指令微调虽能有效提升模型在零样本任务上的泛化能力,却鲜有专门针对道德场景设计的数据集。为此,来自亚琛工业大学与波恩大学的研究人员Zhaohui Zeng与Florian Mai,于2026年构建了“value-for-instruction-tuning”这一统一的道德价值指令微调数据集。该工作通过整合ETHICS、UNIMORAL与SOCIAL-CHEM-101三个现有数据集,将其转化为一致的指令-响应格式,并引入ModernBERT模型进行缺失值填充,从而为价值对齐研究提供了可直接用于指令微调的系统性资源。这一开创性数据集不仅填补了道德场景指令微调数据的空白,也为后续探索模型价值行为与通用任务性能的平衡奠定了重要基础。
当前挑战
该数据集所面临的挑战首先源于价值对齐问题本身的复杂性:人类价值体系具有多样性和情境依赖性,如何将其准确映射至AI系统行为,至今仍是开放性难题。现有道德数据集在标注框架、格式结构上差异显著,例如ETHICS偏向规范伦理、SOCIAL-CHEM-101基于道德基础理论,统一这些异构数据需要克服语义对齐与标签缺失的双重障碍。在构建过程中,研究人员还需设计数据生成器以填补缺失的道德标签,但其预测误差可能引入噪声,且原始数据集以英语为主,缺乏跨语言与跨文化视角,不可避免地继承了源数据中的偏见。此外,指令微调过程中,若过度侧重价值数据,模型的通用任务理解能力可能退化,如何找到最佳混合比例以兼顾二者,同样是一项严峻考验。
常用场景
经典使用场景
在大语言模型(LLM)的价值观对齐研究中,value-for-instruction-tuning数据集被广泛用于通过指令微调(instruction tuning)来引导模型学习符合特定伦理框架的道德行为。该数据集将ETHICS、UNIMORAL和SOCIAL-CHEM-101等异构道德价值观数据集统一转化为指令-响应对格式,使得研究者能够直接将其融入现有的指令微调流水线。通过在该数据集上进行监督微调,模型能够在保持通用任务性能的同时,展现出与人类道德判断更一致的生成倾向,尤其是在面对涉及伦理困境的场景时,模型能够依据规范伦理或道德基础理论做出价值导向的选择。
解决学术问题
该数据集的核心贡献在于填补了指令微调领域缺乏专门针对道德价值观对齐的数据资源的空白。在学术研究中,LLM的价值对齐问题一直面临两大挑战:一是人类价值系统的复杂性与情境依赖性难以被单一模型捕捉,二是现有的指令微调数据集多聚焦于通用任务,未能系统性地融入道德判断信号。value-for-instruction-tuning通过融合多种伦理框架(如规范伦理学与道德基础理论),并采用数据生成器补全缺失标签,构建了一个结构统一的价值观导向训练语料。实验表明,在混合一定比例通用任务数据后,模型在价值-行为一致性评估中的表现显著提升,为探索数据混合比例对价值观学习效果的影响提供了实证基础。
实际应用
在实际应用中,该数据集可被部署于需要高度伦理合规性的AI系统开发场景,例如内容审核助手、医疗咨询机器人、教育辅导工具以及自动驾驶决策辅助系统。通过在这些系统中引入基于value-for-instruction-tuning微调的模型,可以显著降低生成有害、偏见或不道德内容的概率。例如,在社交媒体内容审核中,模型能够根据道德基础理论识别言论中蕴含的伤害、公平、忠诚等价值维度,并据此做出更符合人类社群规范的判断。此外,该数据集还可用于构建可解释的伦理决策引擎,为AI系统的行为提供透明的道德依据。
数据集最近研究
最新研究方向
该数据集聚焦于构建统一道德价值指令微调资源,旨在弥合大语言模型价值对齐中指令微调范式与多样化价值导向数据之间的鸿沟。当前前沿方向围绕如何通过混合通用任务数据与道德情境数据来维持模型通用性能的同时提升其价值敏感行为。研究发现,适度混合价值数据(如10%)能改善模型在价值-行动一致性基准上的表现,但过度依赖价值数据会损害指令遵循能力。这一工作为开发更精细的价值对齐策略提供了实证基础,尤其揭示了在小规模模型上,指令信号本身相较于数据组成对性能提升的主导作用。
相关研究论文
  • 1
    A Unified Moral-Value Dataset for Instruction Tuning亚琛工业大学; 波恩大学; 拉马尔机器学习和人工智能研究所 · 2026年
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务