
遇见数据集

CATIE-AQ/squad_v2_french_translated_fr_prompt_question_generation_with_context

收藏
Hugging Face2025-02-10 更新2024-03-04 收录
官方服务:

资源简介:

squad_v2_french_translated_fr_prompt_question_generation_with_context是法语提示数据集(DFP)的一个子集,包含3,795,312行数据,用于生成带上下文的问题。原始数据来源于squad_v2_french_translated数据集,并通过FrenchQA数据集中的SQUAD 2.0格式问题进行了增强。该数据集使用了24个提示来构建输入和目标列,使其格式与Muennighoff等人创建的xP3数据集一致。

squad_v2_french_translated_fr_prompt_question_generation_with_context is a subset of the French Prompt Dataset (DFP), containing 3,795,312 data rows for context-aware question generation. Its raw data originates from the squad_v2_french_translated dataset, and it is augmented with SQUAD 2.0-format questions sourced from the FrenchQA dataset. This dataset uses 24 prompts to construct its input and target columns, aligning its format with the xP3 dataset created by Muennighoff et al.

提供机构:
CATIE-AQ
原始信息汇总

数据集概述

基本信息

  • 语言: 法语
  • 许可证: Apache 2.0
  • 数据集大小: 1M<n<10M
  • 任务类别: 文本生成
  • 标签: DFP, french prompts
  • 注释创建者: found
  • 语言创建者: found
  • 多语言性: 单语种
  • 源数据集: squad_v2_french_translated

数据集详情

  • 名称: squad_v2_french_translated_fr_prompt_question_generation_with_context
  • 数据集来源: 来自Dataset of French Prompts (DFP)的子集
  • 数据量: 包含3,795,312行,适用于问题生成(带上下文)任务
  • 原始数据: 来自pragnakalp/squad_v2_french_translated数据集,并增加了FrenchQA数据集中的问题
  • 输入和目标列构建: 应用了24个提示,以构建输入和目标列,格式与xP3数据集相同

提示列表

  • 数量: 24个
  • 逻辑: 使用直陈式,使用tutoiement和vouvoiement形式

数据集分割

  • 训练集: 3,795,312个样本
  • 验证集: 无
  • 测试集: 无

使用方法

python from datasets import load_dataset dataset = load_dataset("CATIE-AQ/squad_v2_french_translated_fr_prompt_question_generation_with_context")

引用

原始数据

Hugging Face repository: https://huggingface.co/datasets/pragnakalp/squad_v2_french_translated

本数据集

@misc {centre_aquitain_des_technologies_de_linformation_et_electroniques_2023,
author = { {Centre Aquitain des Technologies de lInformation et Electroniques} },
title = { DFP (Revision 1d24c09) },
year = 2023,
url = { https://huggingface.co/datasets/CATIE-AQ/DFP },
doi = { 10.57967/hf/1200 },
publisher = { Hugging Face }
}

许可证

Apache 2.0
搜集汇总
数据集介绍
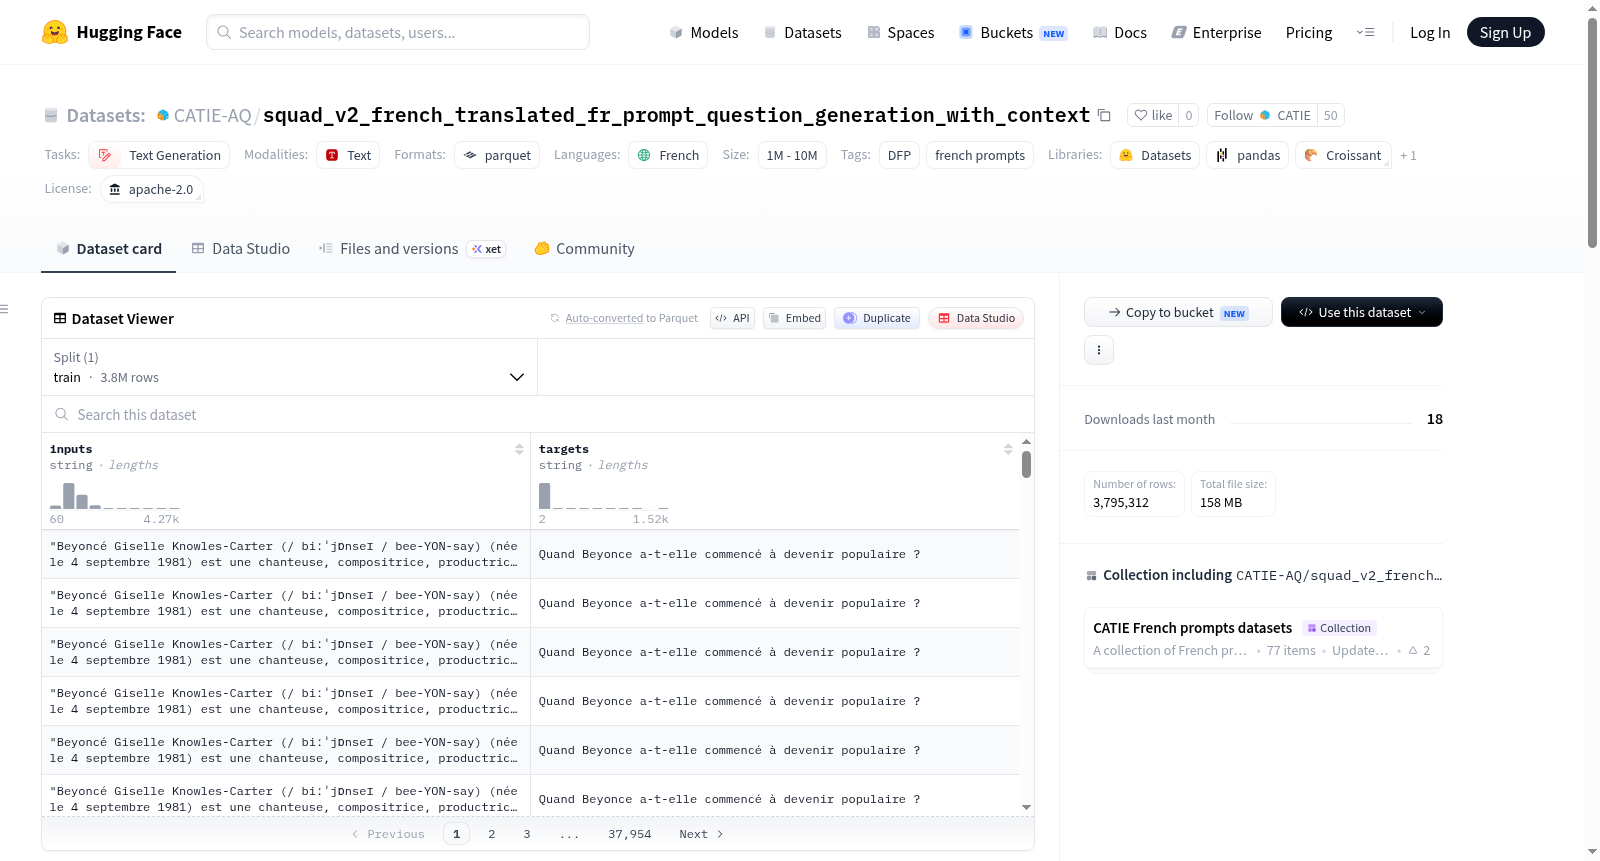
CATIE-AQ/squad_v2_french_translated_fr_prompt_question_generation_with_context 数据集图片
构建方式
在自然语言处理领域,高质量的法语问答数据集对于推进法语文本生成任务至关重要。该数据集源自SQuAD 2.0的法语翻译版本,并经过FrenchQA数据集的二次增强,保留了原始问答结构。在此基础上,研究者精心设计了24条法语提示语,涵盖直陈式语气、单数及复数敬语形式,通过将上下文嵌入提示模板,构建了输入与目标列,最终形成与xP3数据集格式一致的大规模法语提示数据集,总计包含3,795,312条样本。
特点
该数据集的核心特色在于其丰富的提示语多样性,通过三种语言变体(直陈式、单数敬语、复数敬语)的巧妙组合,显著提升了模型在法语环境下上下文问答生成任务的泛化能力。数据集完全基于法语单语构建,采用Apache-2.0开源许可,并严格遵循源数据集的标注规范,确保了数据的可靠性与可复现性。其规模庞大,为百万级样本,为训练鲁棒的法语文本生成模型提供了坚实基础。
使用方法
使用该数据集极为便捷,研究者可直接通过Hugging Face的datasets库进行加载。调用load_dataset函数并指定数据集标识符'CATIE-AQ/squad_v2_french_translated_fr_prompt_question_generation_with_context'即可获取完整的训练集。该数据集未划分验证集与测试集,用户可根据任务需求自行进行数据分割。适用于微调预训练语言模型,特别是在法语上下文相关的问答生成场景中,能够有效提升模型的提示理解与响应能力。
背景与挑战
背景概述
在自然语言处理领域,基于上下文的问句生成任务旨在从给定文本中自动构建合理的问题,其研究对于提升机器阅读理解与对话系统的交互能力具有深远意义。该数据集由法国阿基坦信息技术与电子中心(CATIE-AQ)的研究人员Loïck Bourdois于2023年创建,核心研究问题在于如何利用大规模模板化提示(prompt)技术,将已有的法语SQuAD 2.0翻译数据集转化为适用于文本生成任务的结构化数据。数据集以xP3格式为蓝本,融合了来自pragnakalp/squad_v2_french_translated和FrenchQA的资源,共计超过379万条样本。其发布为法语自然语言处理社区提供了关键训练资源,推动了多语言问句生成模型的进步,并成为法语提示数据集(DFP)的重要组成部分。
当前挑战
该数据集所解决的领域问题在于,法语问句生成任务长期缺乏大规模、高质量且格式统一的训练数据,现有资源多以英语为主,限制了多语言模型的泛化能力。在构建过程中,面临的挑战包括:1) 原始SQuAD 2.0法语翻译数据存在翻译不准确或语义偏差,需通过FrenchQA中的二次人工校验与格式对齐来保证问题与上下文的一致性;2) 设计24种不同语气(如敬语与平语)和句式(命令式与陈述式)的提示模板,以覆盖多样化的语言表达习惯,同时避免模板间的语义重叠或冗余;3) 处理超过379万条数据的高效清洗与去重,确保输入输出对的完整性,并维持xP3格式的严格规范,以兼容主流文本生成模型的训练流程。
常用场景
经典使用场景
该数据集专为法语语境下的问题生成任务而设计,其核心应用在于基于给定的上下文文本自动生成自然流畅的问题。作为法语自然语言处理领域的重要资源,它通过将SQuAD 2.0格式的问答对转化为提示驱动的生成任务,为研究者提供了大规模、高质量的训练样本。经典使用场景包括在机器阅读理解系统中构建问题生成模块,或用于教育领域的自动出题系统,能够从任意法语段落中提炼出关键信息并转化为疑问句形式,从而推动法语文本理解与交互技术的进步。
衍生相关工作
该数据集衍生了一系列经典工作,包括基于提示学习的法语多任务模型(如xP3框架的法语扩展版本),以及针对法语问题生成任务设计的Seq2Seq微调策略。研究者还利用其构建了法语问答系统的端到端评估基准,并探索了不同提示模板对生成质量的影响。此外,该数据集被整合进法语提示数据集(DFP)体系,催生了面向法语零样本学习与指令微调的研究,推动了法语生成式预训练模型在特定任务上的适配与优化。
数据集最近研究
最新研究方向
在自然语言处理领域,面向法语的生成式预训练模型研究正逐步深化,其中基于上下文的自动问题生成任务成为推动机器阅读理解能力跃升的关键路径。该数据集基于SQuAD 2.0的法语翻译版本,通过精心设计的24种提示模板(涵盖敬语与平语、不同祈使句式),构建了超过370万条训练样本,旨在弥合通用问答数据与法语提示学习之间的鸿沟。其研究前沿聚焦于探索多形态提示策略对生成质量的影响,关联近期低资源语言指令微调的热点,如xP3项目所倡导的跨任务泛化范式。该数据集不仅为法语NLP社区提供了标准化的指令式训练资源,更通过融入社会语言学的敬语变体,为文化敏感型AI系统的开发树立了重要标杆,对推动多语种、多风格的自然语言生成具有显著意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

