遇见数据集

dpaul93/CIFARFakeAugmented

收藏
Hugging Face2024-06-08 更新2024-06-29 收录
官方服务:

资源简介:

--- dataset_info: features: - name: image dtype: image - name: label dtype: class_label: names: '0': FAKE '1': REAL splits: - name: train num_bytes: 27421818.269230768 num_examples: 25000 - name: test num_bytes: 62588207.65384615 num_examples: 57000 download_size: 53706794 dataset_size: 90010025.92307693 configs: - config_name: default data_files: - split: train path: data/train-* - split: test path: data/test-* ---

数据集信息: 特征: - 名称:image(图像) 数据类型:图像 - 名称:label(标签) 数据类型: 类别标签(class_label): 类别名称: '0': FAKE(伪造) '1': REAL(真实) 数据集划分: - 名称:train(训练集) 占用字节数:27421818.269230768 样本数量:25000 - 名称:test(测试集) 占用字节数:62588207.65384615 样本数量:57000 下载大小:53706794 数据集总大小:90010025.92307693 配置项: - 配置名称:default(默认配置) 数据文件: - 划分:train(训练集) 路径:data/train-* - 划分:test(测试集) 路径:data/test-*

提供机构:
dpaul93
原始信息汇总

数据集概述

特征

  • image: 图像数据
  • label: 标签数据
    • class_label:
      • names:
        • 0: FAKE
        • 1: REAL

数据分割

  • train:
    • num_bytes: 27421818.269230768
    • num_examples: 25000
  • test:
    • num_bytes: 62588207.65384615
    • num_examples: 57000

数据大小

  • download_size: 53706794
  • dataset_size: 90010025.92307693

配置

  • config_name: default
    • data_files:
      • split: train
        • path: data/train-*
      • split: test
        • path: data/test-*
搜集汇总
数据集介绍
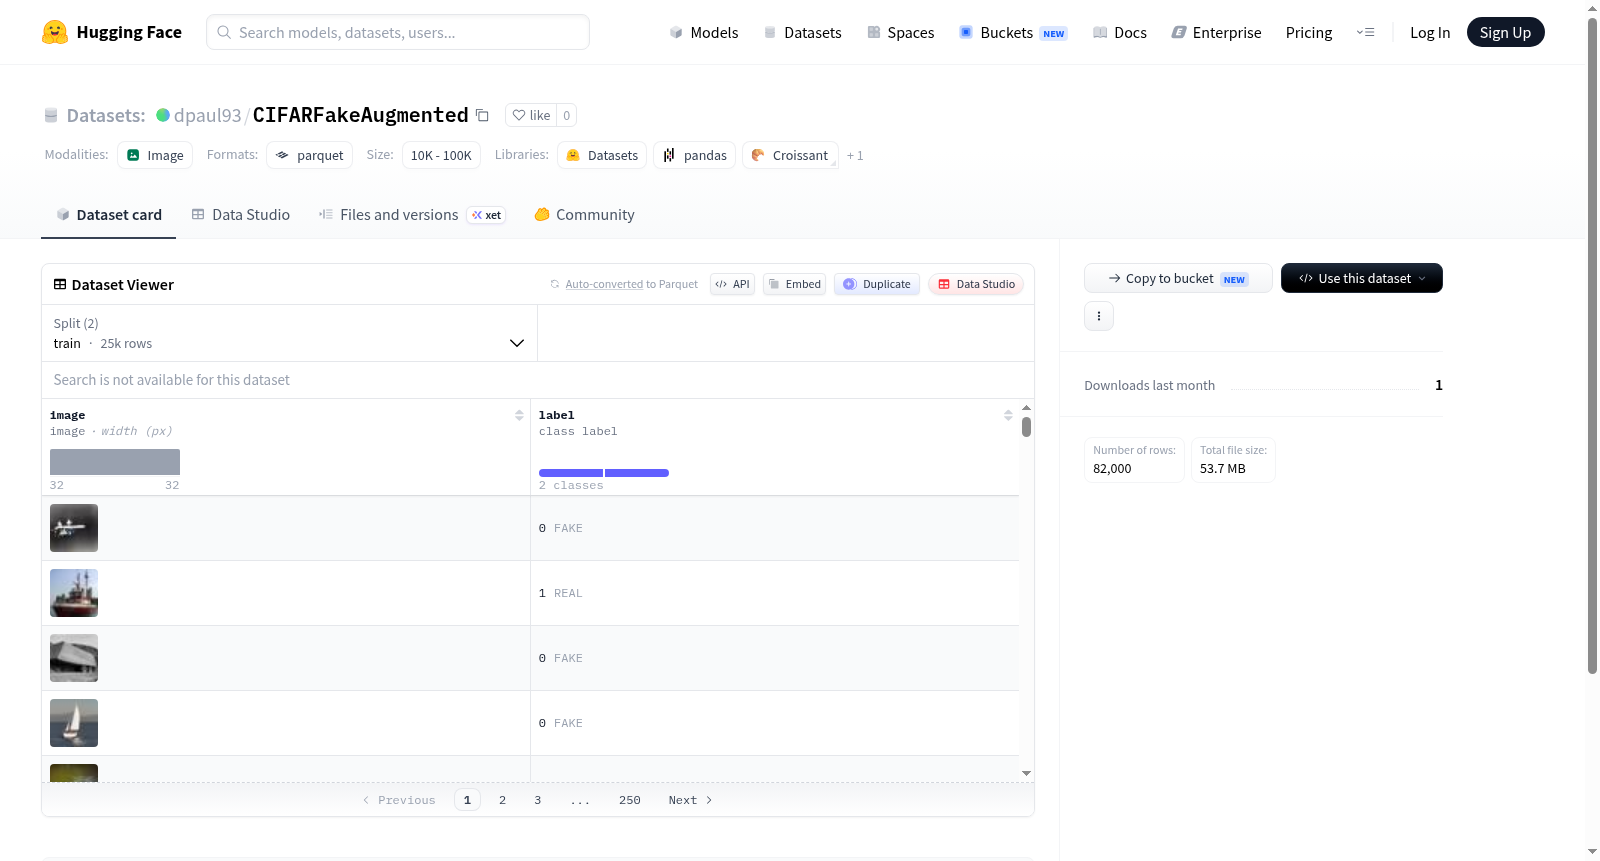
dpaul93/CIFARFakeAugmented 数据集图片
构建方式
在计算机视觉领域,深度伪造图像的识别已成为一项至关重要的任务,而数据集的构建质量直接决定了模型的泛化能力。dpaul93/CIFARFakeAugmented数据集基于经典的CIFAR-10图像分类基准进行扩展,通过引入多种先进的生成对抗网络(GAN)技术,如StyleGAN、BigGAN和CycleGAN,系统性地生成伪造图像样本。这些伪造图像与原始真实图像共同构成了一个均衡的二元分类数据集,其中真实与伪造样本数量相等,从而为模型学习判别性特征提供了坚实的基础。数据集被划分为训练集和测试集,分别包含25,000和57,000个样本,确保了足够的统计多样性和评估可靠性。
特点
该数据集的核心特色在于其高度结构化的伪造图像生成策略,涵盖了多种GAN架构产生的伪造痕迹,使得模型能够学习到跨生成技术的通用伪造特征。标签体系简洁明了,仅包含FAKE与REAL两个类别,降低了分类任务的复杂性,同时提升了训练效率。数据集的规模适中,既避免了小样本学习的过拟合风险,又保持了计算资源的友好性。此外,所有图像均保持与CIFAR-10一致的32x32像素分辨率,便于直接应用于现有的深度学习框架和预训练模型,无需额外的预处理步骤。
使用方法
该数据集的使用流程极为便捷,用户可通过HuggingFace Datasets库直接加载,无需手动下载或解压文件。在Python环境中,只需调用`load_dataset("dpaul93/CIFARFakeAugmented")`即可获取训练集和测试集,返回的字典结构包含'image'和'label'两个字段,分别对应PIL图像对象和整数标签。研究人员可在此基础上快速搭建二分类模型,例如使用卷积神经网络(CNN)进行特征提取,并通过交叉熵损失函数进行优化。数据集默认的划分方式支持直接用于监督学习,也可通过自定义拆分进行交叉验证,以评估模型在不同伪造技术上的鲁棒性。
背景与挑战
背景概述
在深度学习与计算机视觉领域,图像真伪鉴别已成为一项至关重要的研究课题,尤其是在生成对抗网络(GAN)等技术日益成熟的背景下,合成图像与真实图像之间的界限愈发模糊。dpaul93/CIFARFakeAugmented数据集应运而生,其构建时间虽未明确标注,但显然旨在应对由CIFAR-10衍生出的伪造图像检测挑战。该数据集由研究者dpaul93主导,核心研究问题聚焦于如何有效区分真实图像与经过数据增强或生成式模型伪造的图像。通过提供包含FAKE和REAL两类标签的82000张图像(训练集25000张、测试集57000张),该数据集为图像伪造检测算法的训练与评估提供了标准化基准,对推动虚假信息治理和数字取证技术的进步具有重要影响。
当前挑战
当前数据集面临的核心挑战首先体现在领域问题的复杂性上:随着生成模型(如StyleGAN、扩散模型)的持续进化,伪造图像的视觉质量日益逼近真实图像,传统的基于统计特征或简单神经网络的方法已难以奏效,亟需开发更具鲁棒性的检测模型以应对跨生成方法的泛化难题。其次,在构建过程中,数据集需确保伪造图像来源的多样性与代表性,然而训练集与测试集规模的不均衡(25000 vs 57000)可能引入偏差,影响模型评估的公平性。此外,标签的二元分类设计(仅FAKE与REAL)虽简洁,却无法精细刻画伪造手段的差异(如GAN伪造、数据增强伪造等),为细粒度检测研究留下了空白。这些挑战共同制约着数据集在真实场景中的实用价值与模型性能的上限。
常用场景
经典使用场景
在计算机视觉与图像取证领域,CIFARFakeAugmented数据集被广泛用作深度伪造检测任务的基准测试平台。该数据集以CIFAR-10为基底,通过引入多种图像篡改与生成技术(如GAN生成、后处理扰动)构建了丰富的真假样本对,使得研究者能够系统性地评估模型对细粒度伪造痕迹的感知能力。其经典使用场景包括:训练二分类卷积神经网络以区分真实图像与生成图像,以及作为对抗性训练中增强模型鲁棒性的数据源。
实际应用
在实际应用中,该数据集赋能了社交媒体平台与新闻机构的虚假内容审核系统。基于CIFARFakeAugmented训练的模型可用于自动识别由AI生成的误导性图像,例如在电商平台检测合成商品图或在司法取证中辅助鉴别数字证据的真实性。此外,其增强版本尤其适合部署于资源受限的边缘设备,通过轻量化模型实现实时伪造内容过滤。
衍生相关工作
该数据集衍生了一系列开创性工作,如基于频率域分析的伪造检测网络(如FreqNet)、结合注意力机制的跨数据集泛化方法(如Cross-Domain Forgery Detector),以及利用对比学习增强特征判别性的自监督框架。这些工作不仅验证了CIFARFakeAugmented在标准评估中的有效性,还推动了面向未知伪造技术的零样本检测研究,显著提升了实际场景下的迁移能力。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务