
遇见数据集

SINAI/ALIA-es-discriminative-stance-detection

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

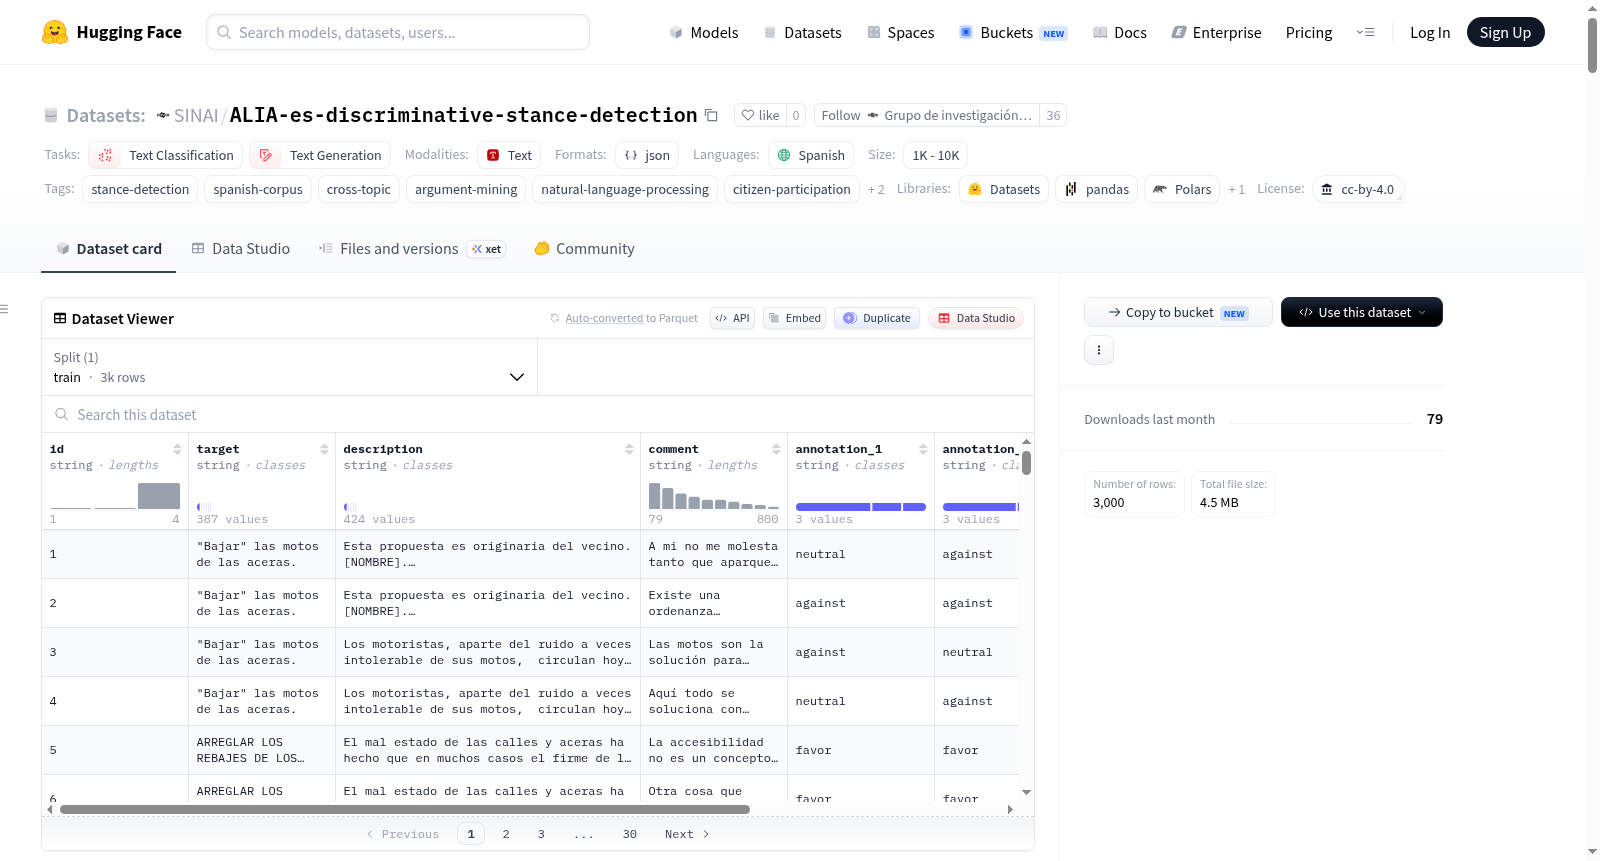
ALIA西班牙语判别式立场检测语料库是一个手动标注的数据集,专为训练和评估西班牙语立场检测模型而设计。给定一个公民话题(目标)和一条公民评论,任务是将评论对该话题的立场分类为三种类别之一:支持、反对或中立。该语料库包含3000个手动标注的实例,来源于Decide Madrid参与式民主平台上的真实公民评论。数据集采用跨话题设计,覆盖387个不同话题,涉及城市交通、环境政策、公共服务等多个地方治理领域。每个实例由3个独立的人类标注者通过众包平台标注,并遵循数据透视主义原则发布所有个体标注,而不是将标注合并为单一真实标签并丢弃分歧,从而支持标注者分歧、模糊性建模和多视角立场分类的研究。

The ALIA Spanish Discriminative Stance Detection Corpus is a manually annotated dataset designed for training and evaluating stance detection models in Spanish. Given a civic topic (target) and a citizen comment, the task is to classify the comments stance toward the topic into one of three categories: favor, against, or neutral. The corpus comprises 3,000 manually annotated instances for stance detection in Spanish, built from real citizen comments posted on the Decide Madrid participatory democracy platform. It is cross-topic by design, spanning 387 distinct topics covering various areas of local governance. Each instance was annotated by 3 independent human annotators, and the dataset is published in full accordance with the principles of data perspectivism, releasing all individual judgments to enable research on annotator disagreement, ambiguity modeling, and multi-perspective stance classification.
提供机构:
SINAI
搜集汇总
数据集介绍
SINAI/ALIA-es-discriminative-stance-detection 数据集图片
构建方式
该数据集源自马德里市民参与平台“Decide Madrid”上的真实公民评论,经过多阶段筛选与分层抽样构建而成。首先,仅保留直接回应辩论或提案的一级评论,并过滤掉低质量、垃圾信息及无关内容。随后,从387个不同议题中按比例分层抽取3000条评论,确保议题多样性,并保证每个议题至少包含3条评论,高频议题则上限为50条。每条评论由3名独立标注员通过Prolific众包平台进行立场标注,标注类别为“赞成”、“反对”或“中立”。最终,数据集遵循数据视角主义原则,公开所有个体标注结果,而非仅保留多数票标签。
使用方法
该数据集可通过HuggingFace的`load_dataset`函数直接加载,并支持多种使用方式。用户可使用`majority_label`字段进行标准的监督学习训练与评估,或利用`annotation_1`至`annotation_3`字段开展标注分歧分析与歧义建模。数据集未预设训练/测试划分,建议用户在构建跨议题评估时确保议题不重叠。典型使用流程包括:过滤无多数标签的实例、将目标描述与评论拼接为输入文本、使用西班牙语预训练模型(如RoBERTa-large-bne)进行微调,或基于个体标注分布训练软标签预测模型。
背景与挑战
背景概述
ALIA-es-discriminative-stance-detection数据集由西班牙哈恩大学SINAI研究团队于2026年创建,旨在推动西班牙语立场检测的研究。该数据集来源于马德里市议会参与的民主平台“Decide Madrid”,包含3,000条人工标注的市民评论,涵盖387个跨主题的公共政策议题,如城市交通、环境保护和公共服务。作为西班牙国家ALIA项目的重要组成部分,它为发展面向西班牙语的AI基础模型提供了关键资源,尤其关注公民参与和辩论分析。数据集的独特之处在于遵循“数据视角主义”原则,公开所有独立标注者的判断,而非仅提供多数标签,从而支持对标注者分歧和主观性的研究。该数据集的发布填补了西班牙语政治话语立场检测领域标注资源的空白,对计算语言学和社会计算领域具有显著影响。
当前挑战
该数据集的核心挑战在于立场检测任务本身的主观性和复杂性。领域问题方面,自然语言中的立场表达常涉及讽刺、隐含态度和条件性支持,而简单的三分类体系(赞成/反对/中立)难以捕捉这些细微差异,导致标注者间一致性仅为中等水平(Fleiss' kappa=0.406),5%的实例出现完全分歧。构建过程中,团队需从开放平台海量评论中筛选出高质量的跨主题样本,面临平台参与偏差(用户多为数字素养较高的公民)、话题分布不均(如城市交通类远超技术行政类)以及标签不平衡(赞成类占62.5%)等挑战。此外,去除非实质性内容、去除重复以及保证话题与评论间语义对准等数据清洗步骤增加了构建复杂度。
常用场景
经典使用场景
ALIA-es-discriminative-stance-detection数据集由近三千条经过严格人工标注的西班牙语公民评论构成,每条评论均被标注为支持、反对或中立立场。该数据集的经典用法在于训练和评估立场检测模型,尤其在跨主题场景下验证其泛化能力。由于评论覆盖了城市交通、环境政策、公共服务等数百个多样化的地方治理话题,研究者可通过该数据集构建能够从复杂公民话语中提取立场倾向的文本分类系统。此外,每条评论由三位独立标注者分别标注,保留了标注差异,为研究标注者间的主观性提供了宝贵资源。加载时仅需使用HuggingFace的datasets库即可快速获取,并可通过过滤非多数标签的样本进行标准监督学习。
解决学术问题
该数据集核心解决了西班牙语立场检测领域缺乏高质量、跨主题标注语料的学术困境。传统立场检测研究多集中于英语,且常忽略标注者间的观点分歧,而本数据集通过公开每位标注者的独立判断,有力推动了‘数据视角主义’方法论的发展。研究者得以系统探究标注不一致的根源,开发能够建模主观性和歧义性的分类模型。此外,该数据集为跨主题泛化研究提供了坚实基准:由于评论来自387个互不重叠的公民议题,学者可以严谨评估模型在未见主题上的迁移能力。这些特性使其成为论证挖掘、观点分析等自然语言处理子领域的标准化评估平台。
实际应用
在实际应用中,该数据集支撑了公民参与平台与公共政策咨询系统的智能化分析。基于此数据集训练的立场检测模型可自动识别市民对市政提案的支持或反对态度,帮助政府高效汇总公众意见,实现透明化治理。例如,在马德里‘Decide Madrid’这类参与式民主平台中,模型能实时分析大量评论的情感倾向,辅助决策者快速把握民意脉络。同时,该语料库也可用于开发面向政务的西班牙语意见分析工具,在地方议会咨询、社区需求调研等场景下生成可视化报告,显著降低人工阅读和归纳的成本,提升公民反馈的处理效率与响应速度。
数据集最近研究
最新研究方向
当前,该数据集的前沿研究方向聚焦于基于数据视角主义(data perspectivism)的西班牙语立场检测,特别是在公民参与平台(如Decide Madrid)的真实评论中建模标注者分歧与主观歧义。研究热点包括利用多标注者完整注释训练能够输出标签分布而非单一硬标签的模型,并探索跨话题泛化能力以应对城市流动性、环境政策、公共服务等多样化治理议题。这一资源为西班牙语自然语言处理中的辩论挖掘与舆论分析提供了关键支撑,推动了公平透明AI在公共咨询分析中的应用,也是西班牙国家AI战略(ALIA项目)下构建本土语言基础模型的重要里程碑。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

