
stevez80/Sci-Fi-Books-gutenberg
收藏官方服务:
资源简介:
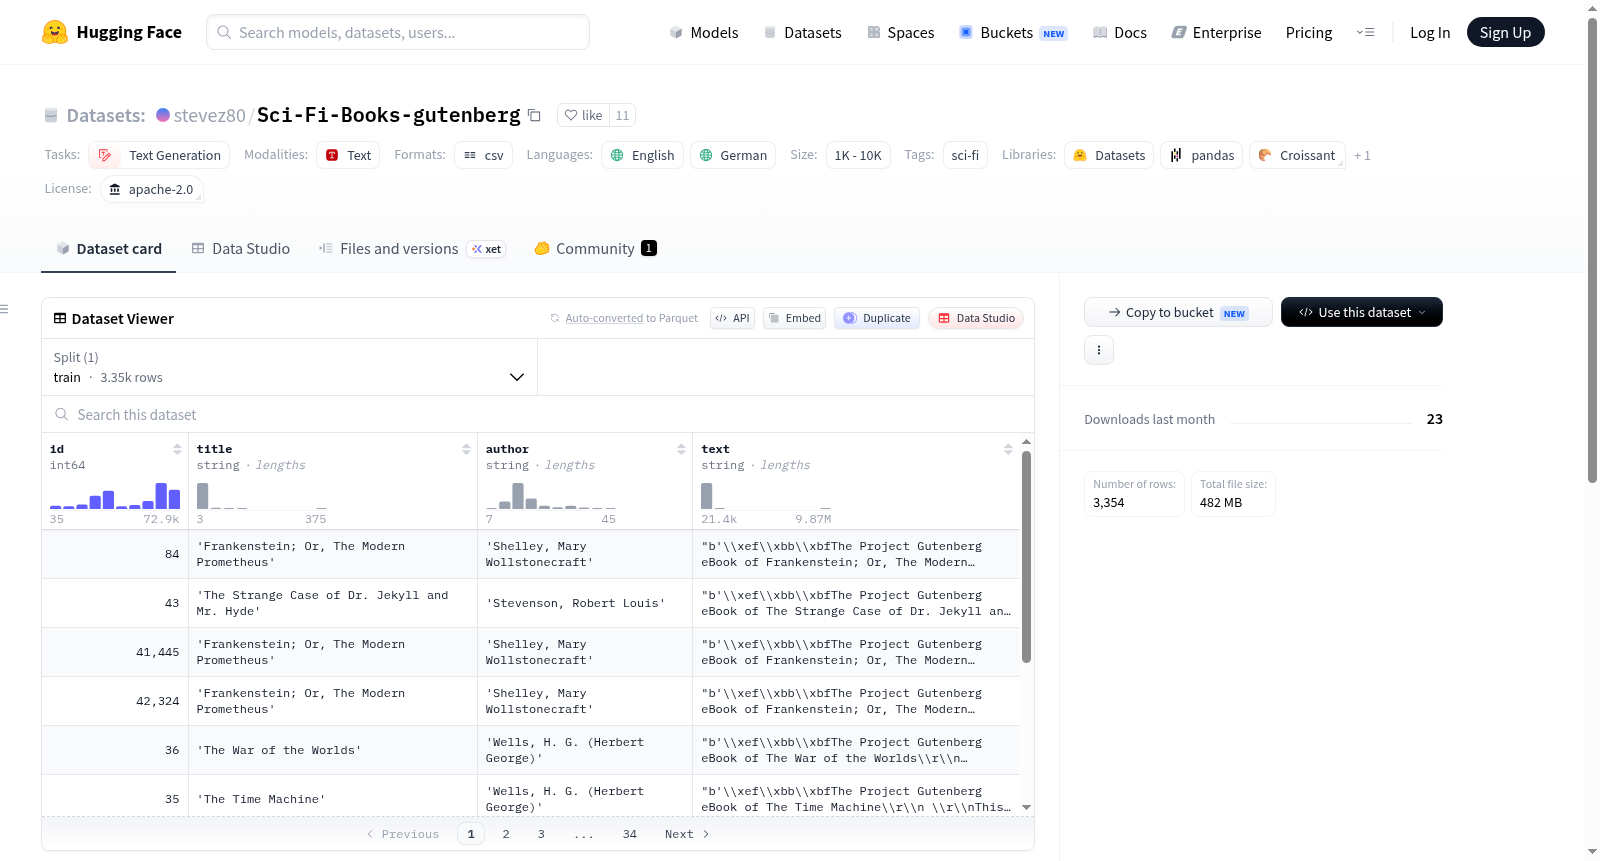
该数据集包含关于科幻书籍的信息,旨在用于训练AI模型、研究或任何与自然语言处理相关的目的。数据集以CSV格式提供,每条记录代表一本书,包含ID、标题、作者和文本内容。数据来源于Project Gutenberg,这是一个提供大量免费电子书的数字图书馆,所有书籍均为公共领域作品,无版权限制。
该数据集包含关于科幻书籍的信息,旨在用于训练AI模型、研究或任何与自然语言处理相关的目的。数据集以CSV格式提供,每条记录代表一本书,包含ID、标题、作者和文本内容。数据来源于Project Gutenberg,这是一个提供大量免费电子书的数字图书馆,所有书籍均为公共领域作品,无版权限制。
提供机构:
stevez80原始信息汇总
Gutenberg Sci-Fi Book Dataset 概述
数据集基本信息
- 许可证: Apache-2.0
- 任务类别: 文本生成
- 支持语言: 英语、德语
- 标签: 科幻
- 美观名称: Gutenberg Sci-Fi Book Dataset
数据集描述
该数据集包含有关科幻书籍的信息,旨在用于训练AI模型、研究或任何与自然语言处理相关的其他目的。
数据格式
数据集以CSV格式提供,每条记录代表一本书,包含以下字段:
- ID: 书籍的唯一标识符。
- Title: 书籍的标题。
- Author: 书籍的作者。
- Text: 书籍的文本内容(例如,摘要、摘录或全文)。
数据来源
本数据集中的书籍来源于Project Gutenberg,这是一个提供大量免费电子书的数字图书馆。Project Gutenberg专注于公共领域内的作品,即不再受版权保护的作品,因此可以自由使用、分发和分析这些文本,无需任何法律限制。
搜集汇总
数据集介绍
构建方式
在自然语言处理与文本生成领域,高质量、多样化的语料库是模型训练与学术研究的基石。该数据集源自Project Gutenberg这一享有盛誉的数字图书馆,专注于收录已进入公共领域的科幻文学作品,确保了数据使用的合法性与开放性。构建过程中,数据集以CSV格式组织,每条记录对应一部完整的科幻小说,包含唯一标识符、标题、作者及全文文本等关键字段,为后续的文本分析与模型训练提供了结构清晰、内容丰富的原始素材。
使用方法
研究人员与开发者可直接通过HuggingFace平台加载该数据集,利用其CSV格式便于与Pandas、Transformers等主流库无缝集成。典型应用包括微调文本生成模型(如GPT系列)以创作科幻风格文本,或训练分类器识别科幻文学特征。使用时需注意,完整文本可能包含较长序列,建议根据模型最大输入长度进行适当截断或分段处理。此外,数据集的多语言特性要求在使用前明确目标语言,并考虑跨语言迁移学习的可能性。
背景与挑战
背景概述
科幻文学作为人类想象力的瑰宝,承载着对科技发展、未来社会与宇宙奥秘的深刻探索。由开发者stevez80于近期构建的Gutenberg Sci-Fi Book Dataset,基于Project Gutenberg这一庞大的公共领域数字图书馆,系统性地收录了英语与德语科幻著作。该数据集以CSV格式提供每部作品的唯一标识、标题、作者及文本内容,旨在为自然语言处理领域的研究者与开发者提供高质量的训练资源。通过聚焦于科幻这一特定文学体裁,该数据集不仅丰富了文本生成任务的语料多样性,更推动了人工智能对叙事结构、未来主义词汇及跨文化科幻表达的深度理解,为相关学术探索与模型优化奠定了坚实的数据基础。
当前挑战
该数据集面临的挑战首先体现在领域问题的复杂性上:科幻文本常包含虚构术语、技术性描述及非现实场景,这对语言模型的语义理解与泛化能力提出了更高要求,尤其在处理创造性叙事与逻辑推理交织的生成任务时。此外,构建过程中的挑战不容忽视:Project Gutenberg的书籍虽为公共领域资源,但文本格式多样且可能包含扫描错误、标点不一致或历史拼写差异,需耗费大量精力进行清洗与标准化。同时,数据集仅涵盖英语与德语,缺乏对其他语种科幻作品的系统收录,限制了跨语言研究潜力,且未标注文本类型(如摘要或全文),可能影响下游任务的适用性。
常用场景
经典使用场景
在自然语言处理与计算文学研究的交汇领域,该数据集因其源自古腾堡计划中经典的科幻文学作品,常被用于构建文本生成模型,尤其是在科幻叙事风格的模仿与创作任务中。研究人员利用其包含的完整书籍文本,训练语言模型学习科幻小说特有的词汇搭配、情节结构和未来主义修辞,从而生成风格一致的科幻文本片段或续写段落。
解决学术问题
该数据集有效缓解了科幻领域高质量、长文本语料匮乏的困境,为探究特定文学体裁的语言特征提供了标准化资源。它助力研究者解决科幻文本自动摘要、主题建模及作者风格迁移等学术问题,推动了计算文体学在类型文学中的深化应用,其开放版权特性更保障了实验的可重复性与成果的广泛传播。
实际应用
在实际应用中,该数据集可用于开发面向创意写作的辅助工具,如智能科幻故事生成器或情节推荐系统。出版社与内容平台可借助基于该数据集微调的模型,自动生成科幻短篇或宣传文案,提升内容生产效率。此外,教育领域亦可利用其进行文学分析与语言教学,帮助学生理解科幻文学的独特叙事逻辑。
数据集最近研究
最新研究方向
在自然语言处理与文本生成领域,科幻小说因其独特的想象力、复杂的世界观构建和丰富的叙事结构,正成为训练大语言模型创造性思维与逻辑推理能力的重要语料。stevez80/Sci-Fi-Books-gutenberg数据集汇集了来自Project Gutenberg的公共领域科幻作品,涵盖英文与德文双语内容,为跨语言文本生成、风格迁移及领域自适应研究提供了高质量资源。当前前沿方向聚焦于利用此类经典科幻文本微调模型,以增强其在长文本连贯性、假设性推理与未来情境模拟方面的表现,同时探索如何通过科幻语料激发模型对未知概念的生成能力。该数据集的开放性与法律安全性使其成为学术界与工业界探索AI创意写作、叙事生成及科技伦理讨论的基础工具,其影响力正随着生成式AI对虚构内容需求的增长而持续扩大。
以上内容由遇见数据集搜集并总结生成


